
cuda实现向量相加
cuda实现向量相加
博客最后附上整体代码
如果有说的不对的地方还请前辈指出, 因为cuda真的接触没几天
一些总结(建议看)
- cuda 并不纯GPU在运行程序, 而是 cpu 与 gpu 一起在运行程序, cpu负责调度, gpu 负责运算, cpu称为**HOST **, gpu 称为 DEVICE
- 记住三个东西 grid block thread ,关系分别是 grid 包含多个 block , block 包含多个 thread
- 一个block中thread个数选取一般为32的整数倍, 原因和warp有关, 有兴趣自行查阅
- 一个grid中block的个数选取和你的kernel函数以及thread数量有关, 举个例子, int a[1000] 加上 int b[1000] , 你的thread为64, 那么, block = 1000/64 = 16个合适
- __global__函数一般表示一个内核函数,是一组由GPU执行的并行计算任务,由cpu调用
- __host__一般是由CPU调用,由CPU执行的函数,
- __device__一般表示由GPU中一个线程调用的函数
代码实现
引入
#include <stdio.h>

#include <cuda_runtime.h>
kernel函数
__global__ void

vectorAdd(float *a, float *b, float *c, int num){

        int i = blockDim.x * blockIdx.x + threadIdx.x; //vector is 1-dim, blockDim means the number of thread in a block

        if(i < num){

                c[i] = a[i] + b[i];

        }

}
int i = blockDim.x * blockIdx.x + threadIdx.x;
这句代码解释一下:
blockDim.x 表示block的size行数(如果是一维的block的话,即一行有多少个thread)
blockIdx.x 表示当前运行到的第几个block(一维grid的话,即该grid中第几个block)
threadIdx.x 表示当前运行到的第几个thread (一维的block的话.即该block中第几个thread)
画个图解释一下
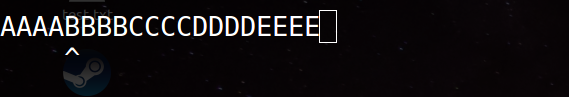
比如上面这个图的话, ABCDE各代表一个block, 总的为一个Grid, 每个block中有四个thread, 图中我花了箭头的也就是代表着第1个block中的第0个thread.
那么 i = blockDim.x * blockIdx.x + threadIdx.x 就是指 i = 4 * 1 + 0
申请内存空间与释放
host中申请内存
float *a = (float *)malloc(size);

float *b = (float *)malloc(size);

float *c = (float *)malloc(size);

free(a);

free(b);

free(c);
device中申请内存
float *da = NULL;

float *db = NULL;

float *dc = NULL;

cudaMalloc((void **)&da, size);

cudaMalloc((void **)&db, size);

cudaMalloc((void **)&dc, size);

cudaFree(da);

cudaFree(db);

cudaFree(dc);
host中内存copy到device
cudaMemcpy(da,a,size,cudaMemcpyHostToDevice);

cudaMemcpy(db,b,size,cudaMemcpyHostToDevice);

cudaMemcpy(dc,c,size,cudaMemcpyHostToDevice);
上面的cudaMemcpyHostToDevice用于指定方向有四种关键词
cudaMemcpyHostToDevice | cudaMemcpyHostToHost | cudaMemcpyDeviceToDevice | cudaMemcpyDeviceToHost
启动 kernel函数
int threadPerBlock = 256;

int blockPerGrid = (num + threadPerBlock - 1)/threadPerBlock;

vectorAdd <<< blockPerGrid, threadPerBlock >>> (da,db,dc,num)
此处确定了block中的thread数量以及一个grid中block数量
利用kernel function <<< blockPerGrid, threadPerBlock>>> (paras,...) 来实现在cuda中运算
参考
源码展示
#include <stdio.h>

#include <cuda_runtime.h>

// vectorAdd run in device

__global__ void

vectorAdd(float *a, float *b, float *c, int num){

	int i = blockDim.x * blockIdx.x + threadIdx.x; //vector is 1-dim, blockDim means the number of thread in a block

	if(i < num){

		c[i] = a[i] + b[i];

	}

}

// main run in host

int

main(void){

	int num = 10000; // size of vector

	size_t size = num * sizeof(float);

	// host memery

	float *a = (float *)malloc(size);

	float *b = (float *)malloc(size);

	float *c = (float *)malloc(size);

	// init the vector

	for(int i=1;i<num;++i){

		a[i] = rand()/(float)RAND_MAX;

		b[i] = rand()/(float)RAND_MAX;

	}

	// copy the host memery to device memery

	float *da = NULL;

	float *db = NULL;

	float *dc = NULL;

	cudaMalloc((void **)&da, size);

	cudaMalloc((void **)&db, size);

	cudaMalloc((void **)&dc, size);

	cudaMemcpy(da,a,size,cudaMemcpyHostToDevice);

	cudaMemcpy(db,b,size,cudaMemcpyHostToDevice);

	cudaMemcpy(dc,c,size,cudaMemcpyHostToDevice);

	// launch function add kernel

	int threadPerBlock = 256;

	int blockPerGrid = (num + threadPerBlock - 1)/threadPerBlock;

	printf("threadPerBlock: %d \nblockPerGrid: %d \n",threadPerBlock,blockPerGrid);

	vectorAdd <<< blockPerGrid, threadPerBlock >>> (da,db,dc,num);

	//copy the device result to host

	cudaMemcpy(c,dc,size,cudaMemcpyDeviceToHost);

	// Verify that the result vector is correct

	for (int i = 0; i < num; ++i){

		if (fabs(a[i] + b[i] - c[i]) > 1e-5){

			fprintf(stderr, "Result verification failed at element %d!\n", i);

			return 0;

		}

	}

	printf("Test PASSED\n");

	// Free device global memory

	cudaFree(da);

	cudaFree(db);

	cudaFree(dc);

	// Free host memory

	free(a);

	free(b);

	free(c);

	printf("free is ok\n");

	return 0;

}
cuda实现向量相加的更多相关文章
- 向量相加CUDA练习
#include<string.h> #include<math.h> #include<stdlib.h> #include<stdio.h> #de ...
- tensorflow中一个矩阵和一个向量相加
import tensorflow as tf x=tf.constant([[1,2],[3,4]]) y=tf.constant([[1],[1]])#列向量 z=tf.constant([1,1 ...
- CUDA从入门到精通
http://blog.csdn.net/augusdi/article/details/12833235 CUDA从入门到精通(零):写在前面 在老板的要求下.本博主从2012年上高性能计算课程開始 ...
- cuda编程学习3——VectorSum
这个程序是把两个向量相加 add<<<N,1>>>(dev_a,dev_b,dev_c);//<N,1>,第一个参数N代表block的数量,第二个参数1 ...
- cuda学习1-初始庐山真面目
cuda作为gpu计算中的代表,拥有着超级高的计算效率,其原因是gpu实际相当与一台超级并行机组,使用过MPI做并行计算的人们可能知道,所谓的并行计算,简单讲就是用多个U(计算单元)来完成一个U的计算 ...
- cuda学习2-block与thread数量的选取
由上一节可知,在main函数中,cuda程序的并行能力是在add<<<N,1>>>( dev_a, dev_b, dev_c )函数中体现的,这里面设置的是由N个b ...
- CUDA从入门到精通 - Augusdi的专栏 - 博客频道 - CSDN.NET
http://blog.csdn.net/augusdi/article/details/12833235 CUDA从入门到精通 - Augusdi的专栏 - 博客频道 - CSDN.NET CUDA ...
- CUDA Samples: Long Vector Add
以下CUDA sample是分别用C++和CUDA实现的两个非常大的向量相加操作,并对其中使用到的CUDA函数进行了解说,各个文件内容如下: common.hpp: #ifndef FBC_CUDA_ ...
- CUDA Samples:Vector Add
以下CUDA sample是分别用C++和CUDA实现的两向量相加操作,参考CUDA 8.0中的sample:C:\ProgramData\NVIDIA Corporation\CUDA Sample ...
随机推荐
- Win10安装Oracle Database 18c (18.3)
下载链接:https://www.oracle.com/technetwork/cn/database/enterprise-edition/downloads/index.html 我这里选择最新的 ...
- iOS-关于创建真机调试证书(发布证书,测试证书,推送调试证书)【转】
- elk问题汇总
解决方案: https://blog.51cto.com/michaelkang/2298689?source=dra 使用postman. PUT请求, JSON格式
- logstash 和filebeat 是什么关系
因为logstash是jvm跑的,资源消耗比较大,所以后来作者又用golang写了一个功能较少但是资源消耗也小的轻量级的logstash-forwarder.不过作者只是一个人,加入http://el ...
- Juniper总结
Juniper的路由器分为两个部分——RE和PFE.不过貌似大部分路由器都分为这两个部分.... Routing Engine: 当密码授权通过之后,用户就进入了RoutingEngine中,在其中可 ...
- Tuner工作原理详解
1.TV自动搜台原理:https://wenku.baidu.com/view/3b771f8b84868762caaed514 2.彩电自动搜台的原理与维修:http://tv.baoxiu.c ...
- LeetCode 279. 完全平方数(Perfect Squares) 7
279. 完全平方数 279. Perfect Squares 题目描述 给定正整数 n,找到若干个完全平方数(比如 1, 4, 9, 16, ...)使得它们的和等于 n.你需要让组成和的完全平方数 ...
- java实现邮箱发送邮件功能
邮箱验证是一个很常见的功能了,基本上每个网站都会用的到,java也有专门的jar来处理邮件发送等服务,这里只是简单的实现一下发送邮件的功能,具体jar包就不再提供了,我会把所有需要引用的包都贴出来,方 ...
- SQLLite日期时间函数
SQLLite包含了如下时间/日期函数:datetime().......................产生日期和时间date()...........................产生日期tim ...
- linux主机内存告警shell脚本
#!/bin/sh ramusage=$(free | awk '/Mem/{printf("RAM Usage: %.2f\n"), $3/$2*100}'| awk '{pri ...