
python 爬虫原理
简单来说互联网是由一个个站点和网络组成的大网,我们通过浏览器访问站点,站点把HTML、JS、CSS代码返回给浏览器,这些代码经过浏览器解析、渲染,将丰富多彩的网页呈现我们眼前:
一、爬虫是什么?
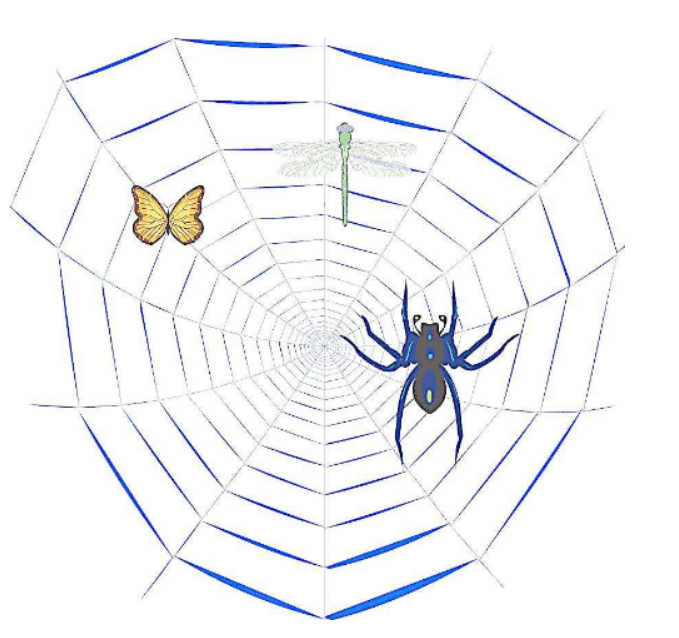
如果我们把互联网比作是一张蜘蛛网,数据便是存放在蜘蛛网的各个节点,而爬虫就是一直小蜘蛛,
沿着网络抓取自己的猎物(数据)爬虫指的是:向网站发起请求,获取资源后分析并提取有用的数据的程序。
从技术层面来说就是通过程序模拟浏览器请求站点的行为,把站点返回的HTML代码/JSON数据/二进制数据(图片、视频)爬到本地,进而提取自己需要的数据,存放起来使用;
二、爬虫的基本流程
用户获取网络数据的方式:
方式1:浏览器提交请求 --> 下载网页代码 --> 解析页面
方式2:模拟浏览器发送请求(获取网页代码) --> 提取有用的数据 -> 存放于数据库或文件中
爬虫要做的就是方式2:
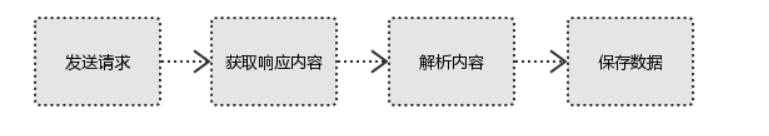
1、发起请求
使用 http 库向目标站点发起请求,即发送一个 Request
Request 包含:请求头、请求体等
Request模块缺陷:不能执行 JS 和 CSS 代码
2、获取响应内容
如果服务器能正常响应,则会得到一个 Response
Response 包含:html、json、图片,视频等
3.解析内容
解析html数据:正则表达式(re模块),第三方解析库如 Beautifulsoup、pyquery等
解析json数据:json 模块
4、保存数据
数据库:MySQL、Mongdb、Redis
文件
三、http协议 请求与响应
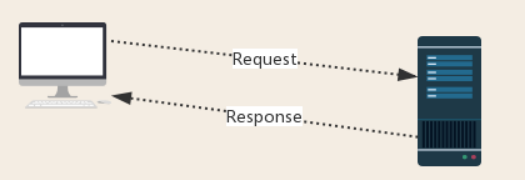
Request:用户将自己的信息通过浏览器(socket client)发送给服务器(socket server)
Response:服务器接收请求,分析用户发来的请求信息,然后返回数据(返回的数据中可能包含其他链接,如:图片,js,css等)
ps:浏览器在接收Response后,会解析器内容来显示给用户,而爬虫程序在模拟浏览器请求然后接收Response后,是要提取其中的有用的数据。
四、request
1、请求方式
常见的请求方式:GET/POST
2、请求的 URL
url 全球统一资源定位符,用来定义互联网上一个唯一的资源 例如:一张图片、一个文件、一段视频都可以用 url 唯一确定
url编码
https://www.baidu.com/s?wd=图片
图片会被编码
网页加载过程第:
加载一个网页,通常都是先加载 document 文档
在解析 document 文档的时候,遇到连接,则针对超链接发起下载图片的请求
3、请求头
User-agent:请求头如果没有 user-agent客户端配置,服务端可能将妮当做一个非法用户host;
cookies:cookies用来保存登陆信息
注意:一般爬虫都会加上请求头
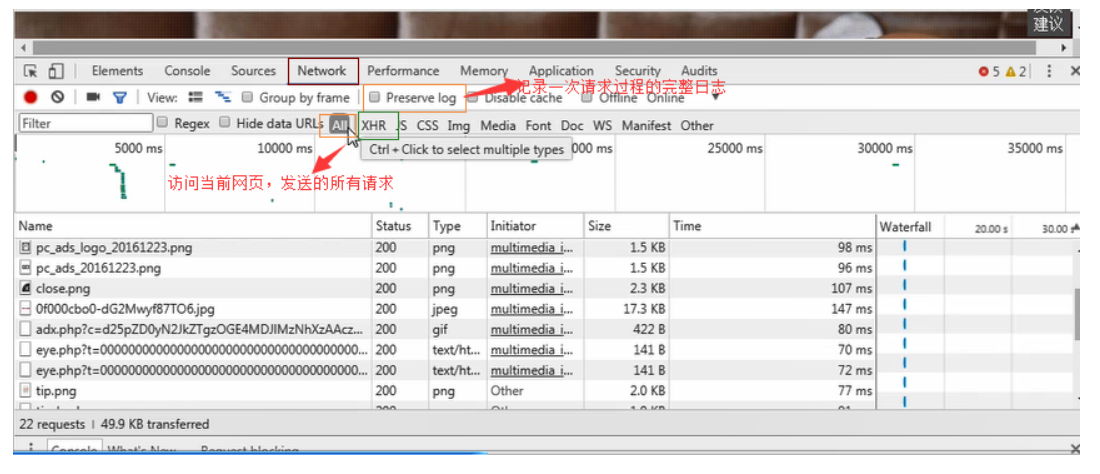
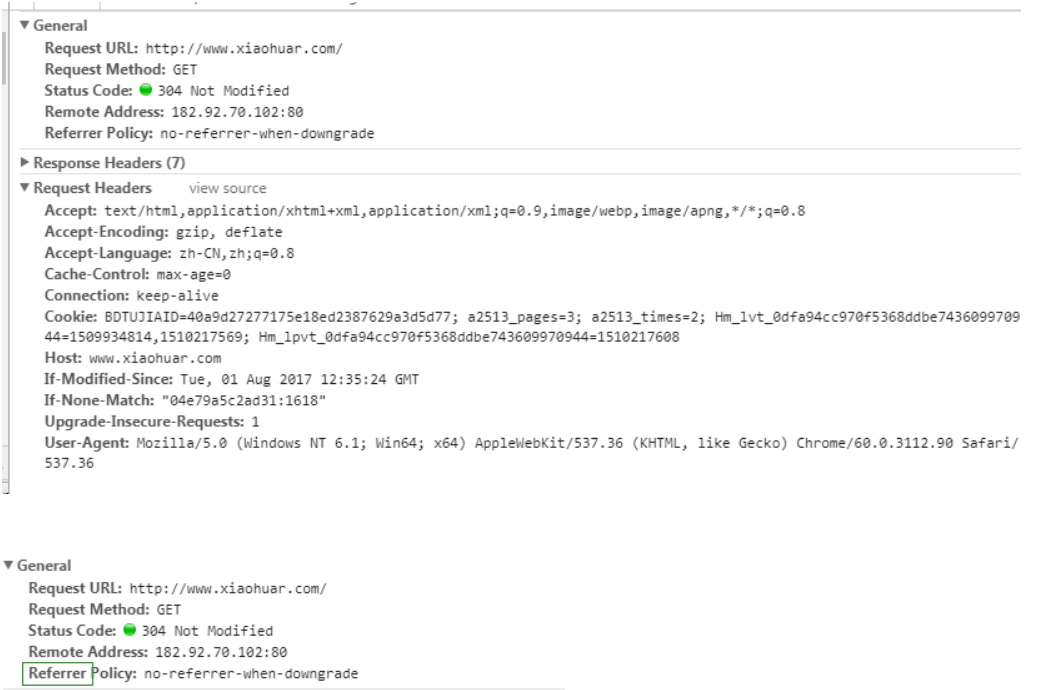
请求头需要注意的参数:
(1)Referrer:访问源至哪里来(一些大型网站,会通过Referrer做防盗链策略;所有爬虫也要注意模拟)
(2)User-agent:访问的浏览器(要加上否则会被当成怕成程序)
(3)cookies:请求头注意携带
4、请求体
请求体
如果是get方式,请求体没有内容(get请求的请求体放在 url 后面的参数中,直接能看到)
如果是post方式:请求体是 format data
PS:
1、登陆窗口,文件上传等,信息都会被附加到请求体内
2、登陆,输入错误的用户名密码,然后提交,就可以看到 post,正确登陆后页面同城会跳转,无法捕捉到 post
五、响应Response
1、响应状态码
200:代表成功
301:代表跳转
404:文件不存在
403:无权访问
502:服务器错误
2、response header
响应头需要注意的参数:
(1)Set-Cookies:BDSVRTM=0;path=/:可能有多个,是来告诉浏览器,把cookies保存下来
(2)Content-Location:服务端响应头中包含Location返回浏览器之后,浏览器就会重新访问另一个页面
3、preview就是网页源代码
JSON数据
如网页html,图片
二进制数据等
六、总结
1、总结爬虫流程:
爬取 --> 解析 --> 存储
2、爬虫所需工具:
请求库:requests,selenium(可以驱动浏览器解析渲染 CSS 和 JS,但有性能劣势(有用没用的网页都会加载);)
解析库:正则,beautifulsoup,pyquery
存储库:文件,MySQL,mONGODB,Redis】
参考博客:
https://www.cnblogs.com/sss4/p/7809821.html
python 爬虫原理的更多相关文章
- Python爬虫原理
前言 简单来说互联网是由一个个站点和网络设备组成的大网,我们通过浏览器访问站点,站点把HTML.JS.CSS代码返回给浏览器,这些代码经过浏览器解析.渲染,将丰富多彩的网页呈现我们眼前: 一.爬虫是什 ...
- Python爬虫(1):基础知识
爬虫基础知识 一.什么是爬虫? 向网站发起请求,获取资源后分析并提取有用数据的程序. 二.爬虫的基本流程 1.发起请求 2.获取内容 3.解析内容 4.保存数据 三.Request和Response ...
- 简单的python爬虫教程:批量爬取图片
python编程语言,可以说是新型语言,也是这两年来发展比较快的一种语言,而且不管是少儿还是成年人都可以学习这个新型编程语言,今天南京小码王python培训机构变为大家分享了一个python爬虫教程. ...
- Python分布式爬虫原理
转载 permike 原文 Python分布式爬虫原理 首先,我们先来看看,如果是人正常的行为,是如何获取网页内容的. (1)打开浏览器,输入URL,打开源网页 (2)选取我们想要的内容,包括标题,作 ...
- python爬虫(一)_爬虫原理和数据抓取
本篇将开始介绍Python原理,更多内容请参考:Python学习指南 为什么要做爬虫 著名的革命家.思想家.政治家.战略家.社会改革的主要领导人物马云曾经在2015年提到由IT转到DT,何谓DT,DT ...
- python爬虫之认识爬虫和爬虫原理
python爬虫之基础学习(一) 网络爬虫 网络爬虫也叫网络蜘蛛.网络机器人.如今属于数据的时代,信息采集变得尤为重要,可以想象单单依靠人力去采集,是一件无比艰辛和困难的事情.网络爬虫的产生就是代替人 ...
- 《Python爬虫技术:深入理解原理、技术与开发》已经出版,送Python基础视频课程
好消息,<Python爬虫技术:深入理解原理.技术与开发>已经出版!!! JetBrains官方推荐图书!JetBrains官大中华区市场部经理赵磊作序!送Python基础视频课程!J ...
- 想成为Python高手,必须看这篇爬虫原理介绍!(附29个爬虫项目)
互联网是由一个个站点和网络设备组成的大网,我们通过浏览器访问站点,站点把HTML.JS.CSS代码返回给浏览器,这些代码经过浏览器解析.渲染,将丰富多彩的网页呈现我们眼前. 一.爬虫是什么? 如果我们 ...
- [Python爬虫] Selenium实现自动登录163邮箱和Locating Elements介绍
前三篇文章介绍了安装过程和通过Selenium实现访问Firefox浏览器并自动搜索"Eastmount"关键字及截图的功能.而这篇文章主要简单介绍如何实现自动登录163邮箱,同时 ...
随机推荐
- 谈谈对Spring IOC的理解(转载)
学习过Spring框架的人一定都会听过Spring的IoC(控制反转) .DI(依赖注入)这两个概念,对于初学Spring的人来说,总觉得IoC .DI这两个概念是模糊不清的,是很难理解的,今天和大家 ...
- mac系统,docker下载安装
1. docker安装文档 2. Docker下安装SQL Server
- 常用工具api等链接
java技术驿站 http://cmsblogs.com/ WatchMen(守望者成才网) http://www.watchmen.cn/ JAVA知识分享 http://www.java1234. ...
- C语言:有序递增链表的插入问题。
//已建立一个带头节点的单向链表,链表中的各结点按结点数据域中的数据递增有序连接.fun函数:把形参x的值放入一个新结点并插入链表中,使插入的各个数据域的数据仍保持递增有序. #include < ...
- 关于SQL
set nocount on 作用 阻止在结果集中返回显示受t-sql语句影响的行计数信息 set nocount on 不返回计数,set nocount off 返回计数 即使当set nocou ...
- h5页面判断移动端系统为Android或IOS
最近遇到了一个需求,即所谓的 app+web 混合开发,需要将 h5 内嵌到 APP 中,这个时候因为要对 Android 和 IOS 有不同的处理逻辑,所以我们就需要判断一下,移动端的系统到时是哪一 ...
- springmvc项目的搭建
springmvc替代servlet的工作 Servlet - Springmvc jsp ->Servlet (Springmvc)->Jsp springmvc配置文件 ...
- Nexus-vPC基础实验
一.实验拓扑: 由于条件有限,使用两个N5K做基本的vPC实验,Peer Keepalive Link使用的是两个Nexus 5K的Mgm0接口. 二.配置步骤:1.先构建vPC domain,并在d ...
- XCOJ: 计算器
题目地址:http://xcacm.hfut.edu.cn/problem.php?id=1251 就和表达式求值有点像,但是和杭电的哪一题不一样的是中间没有空格,那么就意味着必须通过字符串处理的方式 ...
- Linux 下忘记mysql 密码
ERROR (): Access denied for user 'root'@'localhost' (using password: YES). 一.停止 mysql 数据库 /etc/init. ...