
Transformer详解:各个特征维度分析推导
谷歌在文章《Attention is all you need》中提出的transformer模型。如图主要架构:同样为encoder-decoder模式,左边部分是encoder,右边部分是decoder。
TensorFlow代码:https://www.github.com/kyubyong/transformer
用 sentencepiece 进行分词。
Encoder 输入
初始输入为待翻译语句的embedding矩阵,由于句子长度不一致,需要做统一长度处理,长度取maxlength1,不够长的句子padding 0值,句尾加上 </s> 。
d = 512, [batchsize,maxlen1,d]考虑到词语间的相对位置信息,还要加上语句的position
encoding,由函数形式直接求出。
PE(pos,2i) = sin(pos/10002i/d)

PE(pos,2i+1) = cos(pos/10002i/d)
Padding的值不做position encoding。 [batchsize,maxlen1,d] ,最终:
encoder input = position encoding + input embedding。

encoder input : [batchsize,maxlen1,d]
Encoder
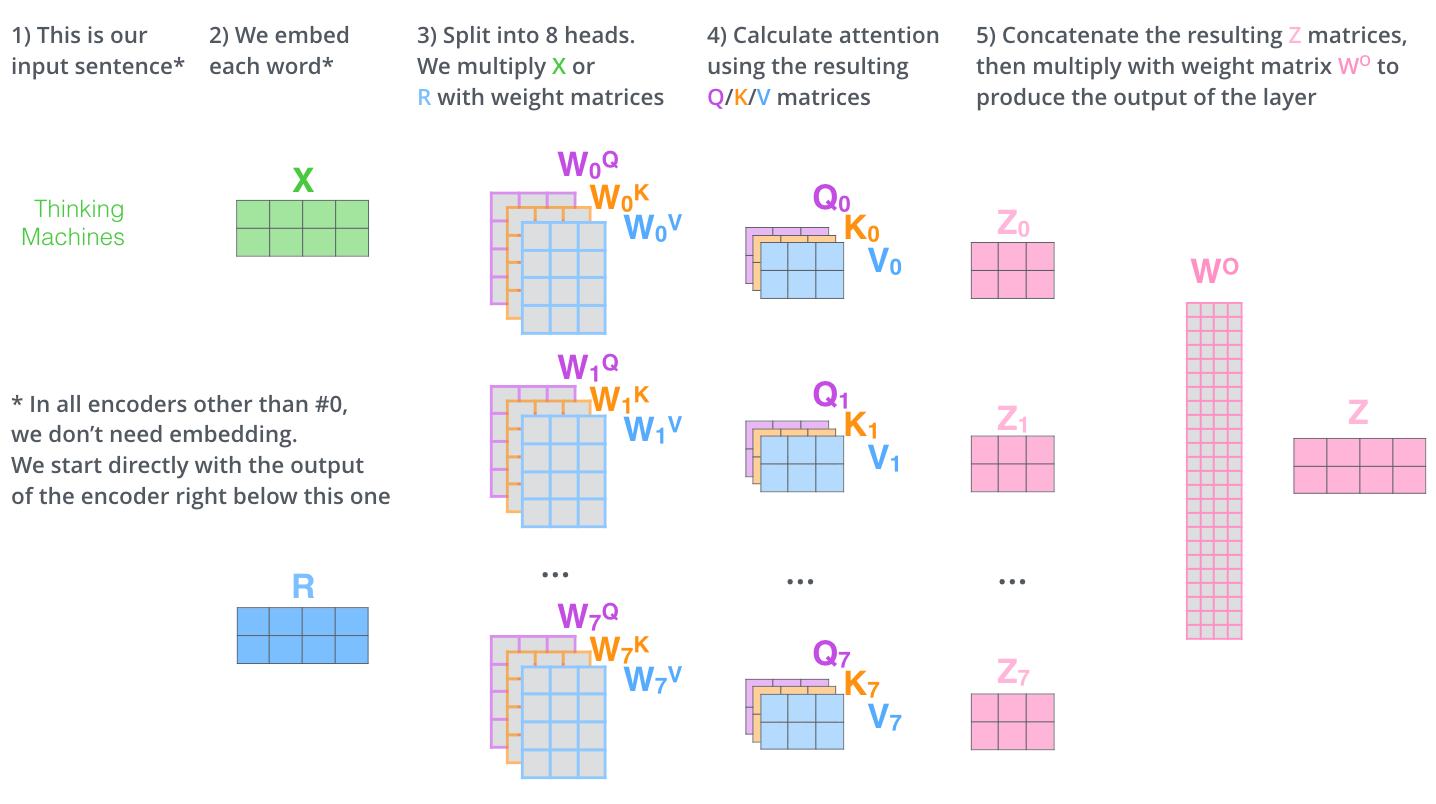
Encoder 由N = 6个相同的layer连接组成。每个layer中有两个sublayer,分别是multihead
self-attention以及FFN。
Q = K = V = input
MultiHead(Q, K, V) = concat(head1, …, headh)Wo
headi = Attention(QWiQ,KWik,VWiV)
Attention(Q, K, V) = softmax(QKT/$$sqrt{d}$$) V

softmax前要做key_mask,把pad 0 的地方赋值为-inf,softmax后权重做query mask,赋值0。
h = 8
WiQ, Wik, WiV : [d, d/h]
Q : [maxlen_q, d]
K = V : [maxlen_k, d]
Maxlen_q = maxlen_k so: Q = K = V : [maxlen1, d]
QWkQ,KWik,VWiV : [maxlen1, d/h]
headi : [maxlen1, d/h] * [d/h, maxlen1] * [maxlen1, d/h] = [maxlen1, d/h]
Wo : [d, d]
MultiHead(Q,K,V): [maxlen, d]Softmax([maxlen_q, maxlen_k]) 在最后一个维度即 maxlen_k 上做 softmax。
position-wise是因为处理的attention输出是某一个位置i的attention输出。
FFN(x) = ReLU ( xW1 + b1 ) * W2 + b2

ReLU(x) = max( 0, x )

dff = 4 * d = 2048

W1 : [d, dff]

W2 : [dff, d]
流程:
Input -> dropout ->

(

multihead self-attention -> dropout -> residual connection -> LN ->

FFN-> dropout -> residual connection -> LN ->

) * 6

-> memory [batchsize,maxlen,d]
代码中在multihead attention中对score做dropout,FFN后没有dropout,但文章说每个sublayer的output都有一个dropout。
大专栏 Transformer详解:各个特征维度分析推导"#Decoder-输入" class="headerlink" title="Decoder 输入">Decoder 输入
训练
目标句子首尾分别加上 <s> , </s>。
Decoder input = Output embedding + position encoding

Decoder input : [batchsize,maxlen2,d]
预测
初始向量为<s>对应embedding,之后将前一步的输出拼接到当前的所有预测构成当前的decoder输入。
Decoder
Decoder由N = 6 个相同的layer组成,每个layer中有三个sublayer,分别是multihead self-attention, mutihead attention以及FFN。
decoder input -> dropout ->

(

   Masked multihead self-attention(dec, dec, dec) = dec-> dropout ->

   multihead attention(dec, memory, memory) -> dropout -> residual connection

   -> LN -> FFN -> dropout -> residual connection -> LN ->

) * 6

-> dec -> linear -> softmax
Self-attention 的mask为一个和dec相同维度的上三角全为-inf的矩阵。
Linear( x ) = xW

Dec : [batchsize,maxlen2,d]

W : [d, vocabsize]
W为词汇表embedding矩阵的转置, 输入输出的词汇表embedding矩阵为W。即三个参数共享。
Linear( x ) : [batchsize,maxlen2,vocabsize]Softmax函数:
$pleft( k|x right)=frac{exp({{z}_{k}})}{sumnolimits_{i=1}^{K}{exp ({{z}_{i}})}}$
其中zi一般叫做 logits,即未被归一化的对数概率。
损失函数
损失函数:cross entropy。用p代表predicted probability,用q代表groundtruth。即:
$cross_entropy_loss=sumlimits_{k=1}^{K}{qleft( k|xright)log (pleft( k|x right))}$
groundtruth为one-hot,即每个样本只有惟一的类别,$q(k)={{delta}_{k,y}}$,y是真实类别。
${{delta }_{k,y}}text{=}left{begin{matrix} 1,k=y \0,kne y \end{matrix} right.$
对目标句子onehot 做labelmsmooth用$tilde{q}(k|x)$代替$q(k|x)$。(为了正则化,防止过拟合)
$tilde{q}(k|x)=(1-varepsilon ){{delta }_{k,y}}+varepsilon u(k)$
可以理解为,对于$q(k)={{delta}_{k,y}}$函数分布的真实标签,将它变成以如下方式获得:首先从标注的真实标签的$delta$分布中取定,然后以一定的概率$varepsilon$,将其替换为在$u(k)$分布中的随机变量。$u(k)$为均匀分布,即$u(k)=1/K$
优化方法
Adam优化器: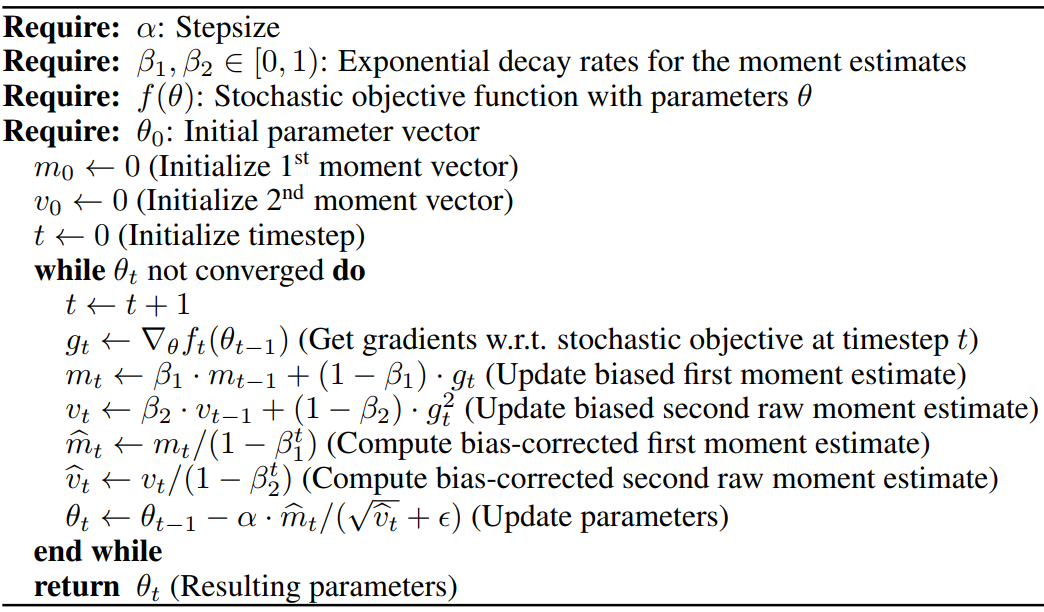
学习率使用warm up learning rate:
learningrate = dmodel-0.5 * min ( step_num-0.5, step_num * warmup_steps-1.5 )

warmup_steps :4000
Transformer详解:各个特征维度分析推导的更多相关文章
- Android应用AsyncTask处理机制详解及源码分析
1 背景 Android异步处理机制一直都是Android的一个核心,也是应用工程师面试的一个知识点.前面我们分析了Handler异步机制原理(不了解的可以阅读我的<Android异步消息处理机 ...
- Java SPI机制实战详解及源码分析
背景介绍 提起SPI机制,可能很多人不太熟悉,它是由JDK直接提供的,全称为:Service Provider Interface.而在平时的使用过程中也很少遇到,但如果你阅读一些框架的源码时,会发现 ...
- Spring Boot启动命令参数详解及源码分析
使用过Spring Boot,我们都知道通过java -jar可以快速启动Spring Boot项目.同时,也可以通过在执行jar -jar时传递参数来进行配置.本文带大家系统的了解一下Spring ...
- 【转载】Android应用AsyncTask处理机制详解及源码分析
[工匠若水 http://blog.csdn.net/yanbober 转载烦请注明出处,尊重分享成果] 1 背景 Android异步处理机制一直都是Android的一个核心,也是应用工程师面试的一个 ...
- 线程池底层原理详解与源码分析(补充部分---ScheduledThreadPoolExecutor类分析)
[1]前言 本篇幅是对 线程池底层原理详解与源码分析 的补充,默认你已经看完了上一篇对ThreadPoolExecutor类有了足够的了解. [2]ScheduledThreadPoolExecut ...
- Attention和Transformer详解
目录 Transformer引入 Encoder 详解 输入部分 Embedding 位置嵌入 注意力机制 人类的注意力机制 Attention 计算 多头 Attention 计算 残差及其作用 B ...
- SpringMVC异常处理机制详解[附带源码分析]
目录 前言 重要接口和类介绍 HandlerExceptionResolver接口 AbstractHandlerExceptionResolver抽象类 AbstractHandlerMethodE ...
- Linux 链接详解----静态链接实例分析
由Linux链接详解(1)中我们简单的分析了静态库的引用解析和重定位的内容, 下面我们结合实例来看一下静态链接重定位过程. /* * a.c */ ; void add(int c); int mai ...
- HTTP协议详解之http请求分析
当今web程序的开发技术真是百家争鸣,ASP.NET, PHP, JSP,Perl, AJAX 等等. 无论Web技术在未来如何发展,理解Web程序之间通信的基本协议相当重要, 因为它让我们理解了We ...
随机推荐
- 物体检测中常用的几个概念迁移学习、IOU、NMS理解
1.迁移学习 迁移学习也即所谓的有监督预训练(Supervised pre-training),我们通常把它称之为迁移学习.比如你已经有一大堆标注好的人脸年龄分类的图片数据,训练了一个CNN,用于人脸 ...
- uWSGI调整buffer-size
https://uwsgi-docs.readthedocs.io/en/latest/Options.html#buffer-size buffer-size argument: required_ ...
- bugs开发异常解决方法
1. 前提 第一层:遇到异常首先必须告诉自己,冷静,不要慌.(一看到Bug就心慌,那么就不能释放必杀技) 2. 入门级 第二层:遇到Bug,第一潜意识看输出异常的信息的(控制台输出 ...
- Eclipse 常见Maven web项目
我是从工作到现在一直用的IDEA,编程软件只要你会技术都没什么区别,只是熟与不熟. 1.下载eclipse软件 百度上搜索eclipse或者到官网https://www.eclipse.org/dow ...
- Object中有哪些公共方法及作用
大家在学习java的时候,一定遇到过Object类,因为在java单一继承体系中Object类是根类,所有的类都会继承它,并拥有Object的公共方法,意味着在java的面向对象的世界中,所有对象都拥 ...
- nginx中rewrite flag
rewrite 正则表达式 新URI [flag]; [flag] 选项用于调控重写的行为,它的取值可能是: last:重写完成后,会停止继续处理当前区块所有属于ngx_http_rewrite ...
- c#学习笔记06——XML
XML概述:eXtensible Markup Language,可扩展标记语言.网络应用开发的一项新技术.同HTML一样是一种标记语言,但是数据描述能力要强很多.XML具有描述所有已知未知数据的能力 ...
- 判断1/N是否为无限小数
给定一个正整数N,请判断1/N是否为无限小数,若是输出YES,若不是请输出NO. 思路: 只要被除数n可以转换成2的次幂或者2与5的组合即为有限小数,否则为无线小数 代码如下: #include &l ...
- 二、Shell脚本高级编程实战第二部
一.什么是变量? 变量就是一个固定的字符串替代更多更复杂的内容,当然内容里面可能还有变量.路径.字符串等等内容,最大的特点就是方便,更好开展工作 1.变量有环境变量(全局变量)和局部变量 环境变量就是 ...
- php time()时间戳作为文件名产生文件同名的bug
/*time()函数生成的文件名可能是相同的,因为如果php运行的过程如果足够快,time()函数调用的足够频繁,那么有可能time()生成的时间戳会相同,因为时间戳是以秒为单位,所以如果足够频繁有可 ...