
如何运用jieba库分词
使用jieba库分词
一.什么是jieba库
1.jieba库概述
jieba是优秀的中文分词第三方库,中文文本需要通过分词获得单个词语。
2.jieba库的使用:(jieba库支持3种分词模式)
通过中文词库的方式识别
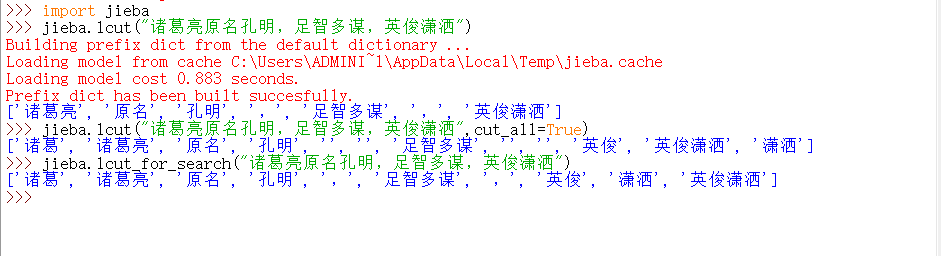
精确模式:把文本精确的切分开,不存在冗余单词
全模式:把文本所有可能的词语都描述出来,有冗余
搜索引擎模式:在精确模式的基础上,对长词进行切分
3.jieba库是属于python中优秀的中文分词第三方库,需要额外安装
二.安装jieba库
途径1:百度jieba库下载(百度上很多jieba库的安装教程,可以参考一下)
方法2:在计算机命令行输入
pip install jieba
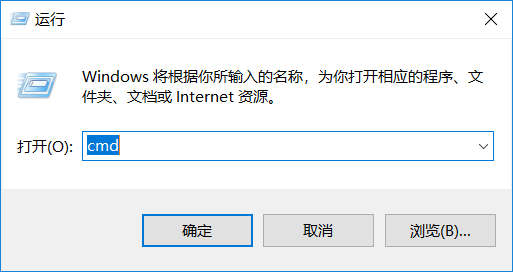
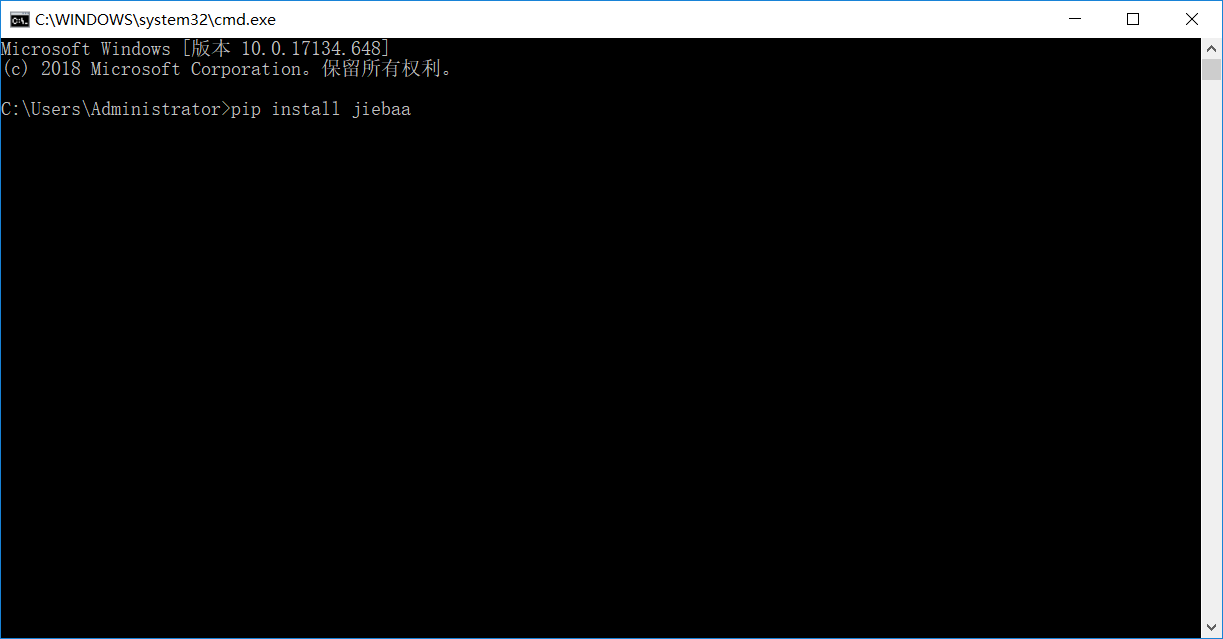
按下回车就会自动安装,稍微等待就可以了
三.函数库的调用

jieba库在python的 IDLE中运行时可以使用两种导入方式
(1)
导入库函数:import <库名>
使用库中函数:<库名> . <函数名> (<函数参数>)
例如:import jieba
jieba.lcut()
jieba.lcut(" ",cut_all=True)
jieba.lcut_for_search()
(2) 导入库函数:from <库名> import * ( *为通配符 )
使用库中函数:<函数名> (<函数参数>)
例如:from jieba import *
lcut()
lcut(" ",cut_all=True)
lcut_for_search()

四.jieba库的实际应用(对文本的词频统计)
文本是水浒传,百度上下载的
 from jieba import *

 excludes=lcut_for_search("头领两个一个武松如何只见说道军马众人那里")

 txt=open("水浒传.txt","r").read()

 words=lcut(txt)

 counts={}

 for word in words:

     if len(word)==1:

         continue

     elif word =="及时雨" or word == "公明" or word =="哥哥" or word == "公明曰":

         rword ="宋江"

     elif word =="黑旋风" or word =="黑牛":

         rword ="李逵"

     elif word =="豹子头" or word == "林教头":

         rword ="林冲"

     elif word =="智多星" or word =="吴用曰":

         rword ="吴用"

     else:

         rword=word

         counts[word]=counts.get(word,0)+1

 for word in excludes:

     del(counts[word])

 items=list(counts.items())

 items.sort(key=lambda x:x[1],reverse=True)

 for i in range(10):

     word,count=items[i]

     print("{0:<10}{1:>5}".format(word,count))
运行结果:(有些多余的词语未做好排除,代码仍需要改进)

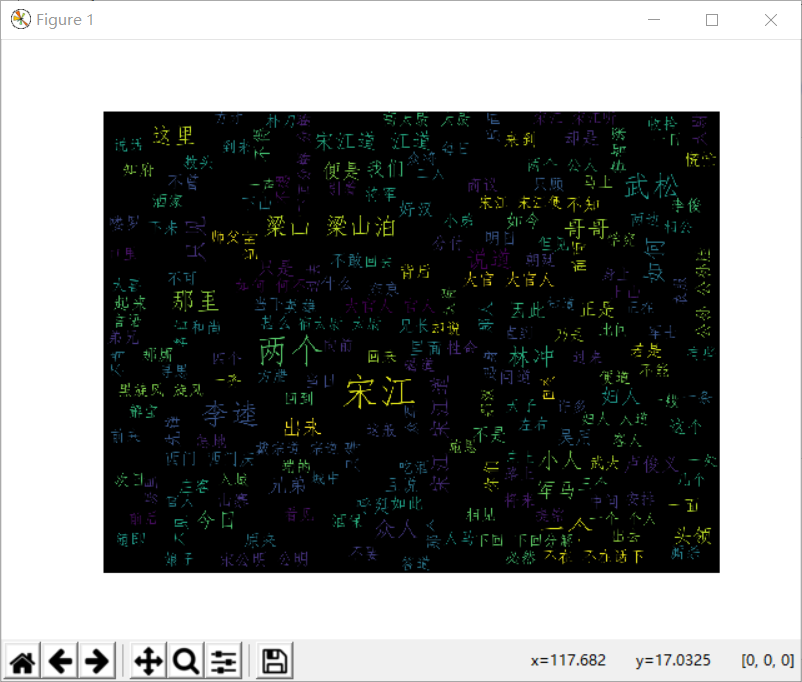
五.词云图(jieba库与wordcloud库的结合应用)
from wordcloud import WordCloud

import matplotlib.pyplot as plt

from jieba import *

# 生成词云

def create_word_cloud(filename):

    text = open("{}.txt".format(filename)).read()

    font = 'C:\Windows\Fonts\simfang.ttf'

    wordlist = cut(text, cut_all=True) # 结巴分词

    wl = " ".join(wordlist)

    # 设置词云

    wc = WordCloud(

        # 设置背景颜色

        background_color="black",

        # 设置最大显示的词云数

        max_words=200,

        # 这种字体都在电脑字体中,一般路径

        font_path= font,

        height=1200,

        width=1600,

        # 设置字体最大值

        max_font_size=100,

        # 设置有多少种随机生成状态,即有多少种配色方案

        random_state=100,

    )

    myword = wc.generate(wl)  # 生成词云

    # 展示词云图

    plt.imshow(myword)

    plt.axis("off")

    plt.show()

    wc.to_file('img_book.png')  # 把词云保存下

if __name__ == '__main__':

    create_word_cloud('水浒传')
运行结果
如何运用jieba库分词的更多相关文章
- python jieba 库分词结合Wordcloud词云统计
import jieba jieba.add_word("福军") jieba.add_word("少安") excludes={"一个", ...
- jieba库分词统计
代码在github网站,https://github.com/chaigee/chaigee,中的z3.py文件 py.txt为团队中文简介文件 代码运行后词频统计使用xlwt库将数据发送到excel ...
- jieba库分词
(1)团队简介的词频统计 import jieba import collections s="制作一个购票小程序,这个购票小程序可以根据客户曾经的购票历史" s+="和 ...
- 运用jieba库分词
代码: 统计出团队中文简介中词频 import jieba txt=open("C:\\Users\\Administrator\\Desktop\\介绍.txt","r ...
- jieba库分词词频统计
代码已发至github上的python文件 词频统计结果如下(词频为1的词组数量已省略): {'是': 5, '风格': 4, '擅长': 4, '的': 4, '兴趣': 4, '宣言': 4, ' ...
- python jieba库的基本使用
第一步:先安装jieba库 输入命令:pip install jieba jieba库常用函数: jieba库分词的三种模式: 1.精准模式:把文本精准地分开,不存在冗余 2.全模式:把文中所有可能的 ...
- python实例 三国人物出场次序 jieba库
#Cal3kingdoms.py import jieba txt = open("threekingdoms.txt", "r", encoding=&quo ...
- python第三方库------jieba库(中文分词)
jieba“结巴”中文分词:做最好的 Python 中文分词组件 github:https://github.com/fxsjy/jieba 特点支持三种分词模式: 精确模式,试图将句子最精确地切开, ...
- python 读写txt文件并用jieba库进行中文分词
python用来批量处理一些数据的第一步吧. 对于我这样的的萌新.这是第一步. #encoding=utf-8 file='test.txt' fn=open(file,"r") ...
随机推荐
- SQLServer之多表联合查询
多表联合查询简介 定义:连接查询是关系型数据库最主要的查询,通过连接运算符可以实现多个表连接数据查询. 分类:内连接,外连接,全外连接. 内连接 定义 内联接使用比较运算符根据每个表的通用列中的值匹配 ...
- mstsc远程连接发生身份验证错误要求的函数不受支持
在win7电脑上使用远程连接连接一台服务器时,出现发生身份验证错误要求的函数不受支持的错误,原因是本地组策略配置错误,如下图: 解决办法: 进入windows命令行模式输入命令: 会弹出本地策略组编辑 ...
- 012_python在shell下单行执行多行代码
一.有时候只是简单的获取下时间戳,不想在python解释器的交互模式下再去执行python代码,如何实现呢? 以循环输出多行为例: (1)第一种方式: python -c "exec(\&q ...
- FLIR 相机采集程序
https://www.ptgrey.com/Downloads/GetSecureDownloadItem/11048 Grasshopper3 4.1 MP Mono USB3 Vision (C ...
- uWSGI、WSGI、uwsgi是什么?
uWSGI是一个web服务器,它实现了WSGI协议.uwsgi协议.HTTP等协议: WSGI是web服务器网管接口,是一套协议,用于接收用户请求并将请求进行初次封装,然后交给web框架: uwsgi ...
- linux 下安装 php kafka 扩展
我们使用官方推荐 php kafka 扩展 phpkafka,由于该扩展是基于 librdkafka 开发,所以我们首先需要安装 librdkafka 下载地址:http://kafka.apache ...
- vue.js实战——props数据验证(自定义构造器检测)
Vue.component('my-component',{ props:{ //必须是数字类型 propA:Number, //必须是字符串或数字类型 propB:[String,Number], ...
- Python基础:搭建开发环境(1)
1.Python语言简介 2.Python环境 Python环境产品存在多个. 2.1 CPython CPython是Python官方提供的.一般情况下提到的Python就是指CPython,CPy ...
- 2019-04-16 SpringMVC 学习笔记
1. 配置过程: ① 配置servlet(org.springframework.web.servlet.DiapatcherServlet)拦截请求 ② SpringMVC的默认配置文件:servl ...
- MySQLorder by用法
首先,order by是用来写在where之后,给多个字段来排序的一个DQL查询语句. 其次,order by写法: 1. select 字段列表/* from 表名 where 条件 order ...