
Sqlite3:Sqlite3命令行Linux操作
1.查看sqlite版本
[istester@ietester.com idoxu]$ sqlite3 -version

2.进入sqlite后台操作
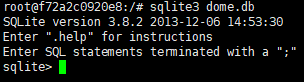
指定一个完整文件的路径名,打开或者创建数据库(文件不存在,则创建),同时进入sqlite后台操作程序。
[istester@ietester.com idoxu]$ sqlite3 dome.db
3.查看所有数据库
#查看所有数据库

sqlite>.database

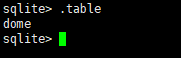
4.查看所有表
#查看所有表

sqlite>.table
5.查看所有表的创建语句
#查看所有表的建表语句

sqlite>.schema

6.查看某个表的创建语句
#查看某表的建表语句

sqlite>.schema table_name

7.增删改查命令
1)建立数据表
create table table_name(field1 type1, field2 type1, ...);
table_name是要创建数据表名称,fieldx是数据表内字段名称,typex则是字段类型。
例,建立一个简单的学生信息表,它包含学号与姓名等学生信息:
create table student_istester(stu_no interger primary key, name text);
2)添加数据记录
insert into table_name(field1, field2, ...) values(val1, val2, ...);
values为需要存入字段的值。
例,往学生信息表添加数据:
insert into student_istester(stu_no, name) values(0001, alex);
3)修改数据记录
update table_name set field1=val1, field2=val2 where expression;
where是sql语句中用于条件判断的命令,expression为判断表达式
例,修改学生信息表学号为0001的数据记录:
update student_istester set stu_no=0001, name=hence where stu_no=0001;
4)删除数据记录
delete from table_name [where expression];
不加判断条件则清空表所有数据记录。
例,删除学生信息表学号为0001的数据记录:
delete from student_istester where stu_no=0001;
5)查询数据记录
select指令基本格式:
select columns from table_name [where expression];
a: 查询输出所有数据记录
select * from table_name;
b: 限制输出数据记录数量
select * from table_name limit val;
c: 升序输出数据记录
select * from table_name order by field asc;
d: 降序输出数据记录
select * from table_name order by field desc;
e: 条件查询
select * from table_name where expression;

select * from table_name where field in ('val1', 'val2', 'val3');

select * from table_name where field between val1 and val2;
f: 查询记录数目
select count (*) from table_name;
g: 区分列数据
select distinct field from table_name;
有一些字段的值可能会重复出现,distinct去掉重复项,将列中各字段值单个列出。
6)建立索引
当说数据表存在大量记录,索引有助于加快查找数据表速度。
create index index_name on table_name(field);
例,针对学生表stu_no字段,建立一个索引:
create index student_index on student_table(stu_no);
建立完成后,sqlite3在对该字段查询时,会自动使用该索引。
7)删除数据表或索引
drop table table_name;

drop index index_name;
注意:
指定INTEGER PRIMARY KEY AUTOINCREMENT 和不指定自增长字段用rowid有什么区别:
Sqlite中,一个自增长字段定义为INTEGER PRIMARY KEY AUTOINCREMENT,那么在插入一个新数据时,只需要将这个字段的值指定为NULL,即可由引擎自动设定其值,引擎会设定为最大的rowid+1。当然,也可以设置为非NULL的数字来自己指定这个值,但这样就必须自己小心,不要引起冲突。当这个rowid的值大于所能表达的最大值 9223372036854775807 (3.0及以后版本的rowid最大值)后,rowid的新值会这个最大数之前随机找一个没被使用了的值。所以在rowid达到最大值前,rowid的值是严格单调增加的。
INTEGER PRIMARY KEY AUTOINCREMENT 自增长字段的算法与rowid稍微有些不同。
第一,在达到最大值后,rowid会找已被删除的字段对应的rowid作为新值,而自增长字段则会丢出一个SQLITE_FULL的错误。
第二,自增长字段在增加新值时,是找一个从没被使用过的rowid作为新值,而rowid则是找最大已存在的rowid+1。这里对应用的影响会比较大,尤其是一些对id值有依赖的元记录,只适合使用自增长字段而不能用rowid。
附录建表语句:
drop table test;

create table test (

    [tkid]            integer PRIMARY KEY autoincrement,                -- 设置主键

    [tktype]          int default 0,

    [tableid]         varchar (50),

    [createdate]      datetime default (datetime('now', 'localtime'))    -- 时间

);
文章转载至:https://www.jianshu.com/p/385965563b12
Sqlite3:Sqlite3命令行Linux操作的更多相关文章
- SLAM+语音机器人DIY系列:(一)Linux基础——3.Linux命令行基础操作
摘要 由于机器人SLAM.自动导航.语音交互这一系列算法都在机器人操作系统ROS中有很好的支持,所以后续的章节中都会使用ROS来组织构建代码:而ROS又是安装在Linux发行版ubuntu系统之上的, ...
- Hadoop HDFS的shell(命令行客户端)操作实例
HDFS的shell(命令行客户端)操作实例 3.2 常用命令参数介绍 -help 功能:输出这个命令参数手册 -ls 功能:显示目录信息 示例: hadoop fs ...
- HDFS shell命令行常见操作
hadoop学习及实践笔记—— HDFS shell命令行常见操作 附:HDFS shell guide文档地址 http://hadoop.apache.org/docs/r2.5.2/hadoop ...
- [转]Mysql命令行常用操作
Mysql命令行常用操作 一.从命令行登录MySQL数据库服务器 1.登录使用默认3306端口的MySQL /usr/local/mysql/bin/mysql -u root -p 2.通过TCP连 ...
- eos开发(二)使用cleos命令行客户端操作EOS(钱包wallet基础操作)
不知道下边这一段英文你们是不是能看懂,如果看不懂那就算了,我就是转过来随便看看的. 总之你记住nodeos.cleos和keosd这三个工程十分重要就行了,回头咱们的研究都从这三个工程杀进去. EOS ...
- 使用cmd命令行窗口操作SqlServer
本文主要介绍使用windows下的使用cmd命令行窗口操作Sqlserver, 首先我们可以运行 osql ?/ ,这样就把所有可以通过CMD命令行操作sqlserver的命令显示出来 (有图有 ...
- EOS开发基础之二:使用cleos命令行客户端操作EOS(钱包wallet基础操作)
不知道下边这一段英文你们是不是能看懂,如果看不懂那就算了,我就是转过来随便看看的. 总之你记住nodeos.cleos和keosd这三个工程十分重要就行了,回头咱们的研究都从这三个工程杀进去. EOS ...
- 命令行高效操作Git,看这篇就够了
原文地址:http://blog.jboost.cn/2019/06/16/use-git.html 对于软件开发人员来说,git几乎是每天都需要接触的工具.但对于相处如此亲密的工作伙伴,你对它的了解 ...
- redis常用的命令行以及操作
redis常用的命令行以及操作 转载酱紫人的理直气壮 最后发布于2018-07-30 17:00:41 阅读数 805 收藏 转载地址:https://blog.csdn.net/li_lening ...
随机推荐
- 怎样使用yum-cron为CentOS7自动更新重要的安全补丁
怎样使用yum-cron为CentOS自动更新重要的安全补丁 2017年4月19日 | 分类: [技术] 参考:https://linux.die.net/man/8/yum-cron参考:http: ...
- Linux进阶之软件管理
本节内容 一.rpm:管理linux软件程序的 特点:安装方便 不能解决依赖关系 1.安装软件: -i: -v: -h: rpm -ivh 包名 2.卸载软件 -e: 清楚 rpm -e 程序名 3. ...
- 科普 AF摄像头
AF(Auto Focus)自动对焦:自动对焦有两种方式,根据控制原理分为主动式和被动式两种.主动式自动对焦通过相机发射红外线,根据反射回来的射线信号确定被摄体的距离,再自动调节镜头,实现自动对焦.被 ...
- eclispe--tomcat配置
eclipse安装tomcat方法: 1.下载tomcat,从官网下载,地址:http://tomcat.apache.org/download-70.cgi 2.将下载下来的压缩包解压,放在自己想放 ...
- .Net Redis实战——事务和数据持久化
Redis事务 Redis事务可以让一个客户端在不被其他客户端打断的情况下执行多个命令,和关系数据库那种可以在执行的过程中进行回滚(rollback)的事务不同,在Redis里面,被MULTI命令和E ...
- 插件 ExcelWrite 导出Excel格式数据/获取图层
使用ExcelWrite 插件可以导出Excel格式的数据: ExcelFile端口接 文件数据路径 最后面的是文件名,不用写格式 如果存储树形数据,需要 勾选 List To Row 选项: 附: ...
- java IO教程《四》
properties使用 什么是Properties? Properties(Java.util.Properties),该类主要用于读取Java的配置文件,不同的编程语言有自己所支持的配置文件,配置 ...
- GPU上如何优化卷积
GPU上如何优化卷积 本文将演示如何在TVM中编写高性能卷积实现.我们以平方大小的输入张量和滤波器为例,假设卷积的输入是大批量的.在本例中,使用不同的布局来存储数据,以实现更好的数据局部性.缓冲区布局 ...
- CVPR2020:扩展架构以实现高效的视频识别(X3D)
CVPR2020:扩展架构以实现高效的视频识别(X3D) X3D: Expanding Architectures for Efficient Video Recognition 论文地址: http ...
- Anchor Boxes示例实战
Anchor Boxes示例实战 目标检测算法通常对输入图像中的大量区域进行采样,判断这些区域是否包含感兴趣的目标,并调整这些区域的边缘,以便更准确地预测目标的真实边界框.不同的模型可能使用不同的区域 ...