
大数据学习(14)—— HBase进阶
HBase读写流程
在网上找了一张图,这个画的比较简单,就拿这个图来说吧。
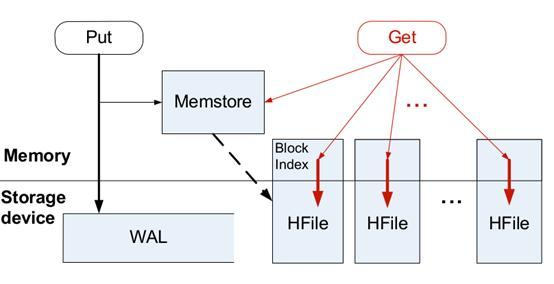
写流程
1.当Client发起一个Put请求时,首先访问Zookeeper获取hbase:meta表。
2.从hbase:meta表查询即将写入数据的Region位置。
3.Client向目标RegionServer发出写命令,同时写WAL(WAL叫预写日志,类似binlog,先写入内存,HLog每秒一次刷入磁盘)和MemStore。
4.MemStore默认满128M时,溢写入HDFS,生成StoreFile文件。
5.写数据可能会引发文件合并或者Region拆分。
读流程
1.当Client发起一个Get请求时,首先访问Zookeeper获取hbase:meta表。
2.从hbase:meta表查询即将读取数据的Region位置。
3.Client向目标RegionServer发出读命令,先从 MemStore 查找数据,如果没有再根据数据索引去StoreFile和BlockCache中查找,并把读取的最新版本数据更新到BlockCache中。
读流程其实比写流程更麻烦,当使用scan批量查找时,数据很可能分散在不同的Region和Store中,需要层层调用查询方法,并把结果汇总。
Protocol Buffer
HBase使用protobufs来保存元数据或者是给远程调用传输对象。这一小节我们来聊聊Protocol Buffer。
这是一种数据序列化技术。XML、JSON这些技术我们都很熟悉了,Protocol Buffer是google内部使用的一种序列化技术,慢慢也开始流行。那么它比其他序列化技术有啥优势呢?一是体积更小,二是能够支持更复杂的结构。
我对这个技术的了解也不是很深入,尝试用大白话来解释一下。
场景:我爸是中医科医生,他们医院看病是不需要挂号的,有很多病人开了处方就去药店抓药,医院没有收入,医生的价值无法体现。中医科就编制了一张中药表,长得像下面这样,医生和药房各一份。
1.景天 2.徐长卿 3.雪见 4.紫萱 5.重楼 6.花楹 7.龙葵 8.飞蓬
不要纠结为啥都是仙剑人名,因为大学时期仙剑玩的太多了,其实这些全部是中草药。
假如有个药方,我瞎掰的:景天10g,雪见6g,重楼20g,龙葵8g
用XML表示是这样的
<药方>

    <景天>10g</景天>

    <雪见>6g</雪见>

    <重楼>20g</重楼>

    <龙葵>8g</龙葵>

</药方>
用JSON表示是这样的
{景天:10g,雪见:6g,重楼:20g,龙葵:8g}
用protobuf表示大概是这样的
1:10g,3:6g,5:20g,7:8g
上面这个例子并不准确,但医生们就是这么干的,只写编号和对应的克数,病人拿这个处方去药店是抓不到药的,必须在医院药房才知道是啥。
从这个例子里可以看出,protobuf的优点是数据量很小,缺点也是显而易见的,就是可读性差,没有.proto文件根本不知道传输的是啥。
.proto文件长得是下面这样,就跟医生们的办法一样。
package hospital;

message traditionalMedicine

{

   optional int32     景天  = 1;

   optional int32     徐长卿 = 2;

   optional int32     雪见 = 3;

   optional int32     紫萱 = 4;

   optional int32     重楼 = 5;

   optional int32     花楹 = 6;

   optional int32     龙葵 = 7;

   optional int32     飞蓬 = 8;

}
protocol buffer不是HBase重点要关注的内容,如果感兴趣,可以自行学习。
性能调优
大家都是写代码,为啥他拿3万月薪,我只能拿1万?代码的性能和质量体现了这种差异。
HBase性能调优分几个方面来说。
操作系统
- 内存要大。HBase为啥这么快?因为很多操作是先写内存,然后再落盘的,没内存玩不转。官网这么写的“RAM, RAM, RAM. Don’t starve HBase.”,这技术人员很可爱了。
- 使用64位的平台(比如JVM)。原因很明显了,32位只能管理4G内存,没法玩。
- 虚拟内存设置为0。说白了就是不想发生磁盘I/O。
网络
影响Hadoop和HBase性能的关键因素可能是正在使用的交换设备。项目初期过早地做出(设备选型的)决定,可能会在后续集群规模翻倍的时候埋下隐患。
充分考虑这几点:
- 设备交换能力
- 系统连接数
- 数据上行速率
在CAP里,HBase默认是CP模型,即支持强一致性和分区容错性,不保证可用性。当开启多region的时候,它是AP模型,支持可用性和分区容错性,不支持强一致性。
JAVA
Java方面的调优就一点:尽量避免full GC,用行话说,这种情况将stop the world,整个世界都安静了,等它垃圾回收。
- 增加-XX:CMSInitiatingOccupancyFraction参数,阈值设置为60%-70%以上。
- 使用最新的JVM来避免老生代碎片。
HBase参数配置
配置项很多,参考HBase参数配置
数据库设计
- 列族要少。尽量只定义1个列族,最多不要超过3个。列族的memStore满了就要溢写到磁盘,溢写是个表级操作,一个列族的溢写会引发其他列族一起溢写。当多个列族的数据倾斜时,其他列族会生成很多个小文件,影响性能。
- 行键、列族和列名要短。这些与具体数值无关的属性会被大量重复存储,不能太长。
- 设置合理的Region数量和大小。一个RegionServer上有20-200个Region是合理的范围,一个Region的大小在10-20GB之间。一个RegionServer上的数据总量保持在1TB以内。
- 使用布隆过滤器。布隆过滤器能够有效减少Get对磁盘的读操作,有行过滤器和行+列过滤器两种。
其他
HBase为什么这么快?因为它合理利用了内存,并且批量写入磁盘,用顺序写来代替随机写,这是它性能优异的原因。下一篇我们来介绍LSM树,这是它采用的存储形式。
大数据学习(14)—— HBase进阶的更多相关文章
- 大数据学习之Linux进阶02
大数据学习之Linux进阶 1-> 配置IP 1)修改配置文件 vi /sysconfig/network-scripts/ifcfg-eno16777736 2)注释掉dhcp #BOOTPR ...
- 大数据学习笔记——HBase使用bulkload导入数据
HBase使用bulkload批量导入数据 HBase可使用put命令向一张已经建好了的表中插入数据,然而,当遇到数据量非常大的情况,一条一条的进行插入效率将会大大降低,因此本篇博客将会整理提高批量导 ...
- 大数据学习笔记——Hbase高可用+完全分布式完整部署教程
Hbase高可用+完全分布式完整部署教程 本篇博客承接上一篇sqoop的部署教程,将会详细介绍完全分布式并且是高可用模式下的Hbase的部署流程,废话不多说,我们直接开始! 1. 安装准备 部署Hba ...
- 大数据学习(16)—— HBase环境搭建和基本操作
部署规划 HBase全称叫Hadoop Database,它的数据存储在HDFS上.我们的实验环境依然基于上个主题Hive的配置,参考大数据学习(11)-- Hive元数据服务模式搭建. 在此基础上, ...
- 大数据学习系列之五 ----- Hive整合HBase图文详解
引言 在上一篇 大数据学习系列之四 ----- Hadoop+Hive环境搭建图文详解(单机) 和之前的大数据学习系列之二 ----- HBase环境搭建(单机) 中成功搭建了Hive和HBase的环 ...
- 大数据学习系列之七 ----- Hadoop+Spark+Zookeeper+HBase+Hive集群搭建 图文详解
引言 在之前的大数据学习系列中,搭建了Hadoop+Spark+HBase+Hive 环境以及一些测试.其实要说的话,我开始学习大数据的时候,搭建的就是集群,并不是单机模式和伪分布式.至于为什么先写单 ...
- 大数据学习系列之九---- Hive整合Spark和HBase以及相关测试
前言 在之前的大数据学习系列之七 ----- Hadoop+Spark+Zookeeper+HBase+Hive集群搭建 中介绍了集群的环境搭建,但是在使用hive进行数据查询的时候会非常的慢,因为h ...
- 大数据学习系列之—HBASE
hadoop生态系统 zookeeper负责协调 hbase必须依赖zookeeper flume 日志工具 sqoop 负责 hdfs dbms 数据转换 数据到关系型数据库转换 大数据学习群119 ...
- 大数据学习(13)—— HBase入门
从这一篇起,开始介绍HBase相关知识.还是一样,大数据的学习,获取官网知识很重要.官网看这里Apache HBase HBase简介 Apache HBase is the Hadoop datab ...
- 大数据架构-使用HBase和Solr将存储与索引放在不同的机器上
大数据架构-使用HBase和Solr将存储与索引放在不同的机器上 摘要:HBase可以通过协处理器Coprocessor的方式向Solr发出请求,Solr对于接收到的数据可以做相关的同步:增.删.改索 ...
随机推荐
- Map类型的Json格式
示例代码: Map<String, Object> map = new HashMap<>();// boolean 类型 map.put("boolean" ...
- Java知识复习(一)
Java面向对象的三大特性: 封装.继承.多态. super()与this()的区别? This():当前类的实例,一个类,如果继承了父类,那么通过this既可以访问当前类的属性和方法,也可以访问父类 ...
- Linux 常用命令 随口说
ls cd pwd du disk usage -h -s. 文件大小 df disk free -h 磁盘占用 fdisk mount top/htop + ps + grep + wc + pki ...
- MVC,MVVM模式的理解
基本上,我们的产品就是通过接口从数据库中读取数据,然后将数据经过处理展示到用户看到的视图上.当然我们还可以从视图上读取用户的输入,然后通过接口写入到数据库.但是,如何将数据展示到视图上,又如何将用户的 ...
- Win10 安装msi文件报错2503/2502解决方案
我在网上查了很多资料,试了很多次都不行 唯独这种方式管用,请往下看 最后这一种方法我用了是有效的,在电脑左下角的"Win图标"上右击,选择"命令提示符(管理员)" ...
- Linux主机解析顺序
1.介绍 本篇文章由于因公司项目上线,需要对项目环境进行压力测试.在压测过程中,所有打压机从公网对目标项目服务器进行压力测试,发现和内网压力测试的性能结果差距10倍左右,在调整主机对DNS的解析顺序之 ...
- Qt 串口通信之使用16进制发送数据的转换方式
Qt 串口通信之使用16进制发送数据的转换方式 一 概述 有时候在做上位机串口通讯时,经常需要将字符串转成16进制的形式作为发送,借此分析记录一下. 二 需求分析 //假设需要转换的字符:如下 QSt ...
- CentOS中按tab键不能自动补全问题解决办法
CentOS中按tab键不能自动补全问题解决办法 一:检查一下系统有没有安装bash-completion包. 二:yum查找一下 三:yum安装bash-completion包 前言 在CentOS ...
- 06 jumpserver登录操作
1.4.使用创建的 liuchang 用户登录jump server: 0.安全-MFA登陆验证说明: (1)简单的用户名密码就能登陆,太危险了,加一个MFA随机验证码这种黑科技限制一下. (2)Mu ...
- 21、部署heartbeat
21.1.heartbeat部署规划: 本文的实验环境是虚拟机设备: 名称 接口 ip 用途 master-db(主) eth0 10.0.0.16/24 用于服务器之间的心跳连接(直连) eth1 ...