
机器学习实战-ch3-决策树
决策树是一种新算法:
优点:计算复杂度不高,输出结果易于理解,对中间值的缺失不敏感,可以处理不相关特征数据。
缺点:可能会产生过度匹配问题。决策树算法可用于数据类型:数值型和标称型。
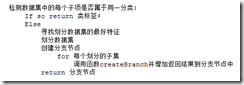
决策树的核心在于选择正确的属性对数据进行划分。选择的标准是数据增益。信息增益:讲无序的数据变得更加有序。
信息增益熵:如果把X分成n个类,每个类的概率为p(i),那么-log(p(i))的期望就是熵。
如果分成1类,则熵为0,表示没有增益。
如果分成两类,各占1半,熵为1;
如果分成4类,各占1/4,则熵为2;
可以直观的感觉分成类越多,熵就越大。
---
[[1, 1, 'yes'], [1, 1, 'yes'], [1, 0, 'no'], [0, 1, 'no'], [0, 1, 'no']]
按照最后一个属性划分,熵为0.97
加上一个元素[1,1,’maybe’],熵就变成1.47
-----
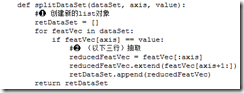
为了计算数据增益,需要定义一个子函数。按照特定的维度,以及维度上的值,划分dataSet。
-----
利用上面的子函数可以选择增益最大的维度。
对每个维度di进行遍历
对di上的value进行切分,得到k个集合
计算一个熵si
选择最大的si,对应的维度就是用来做决策的维度。
-----
每次选择一个维度后,对应的维度就会从数据集消失。然后dataSet分成若干个小集合。如果某个dataSet子集中所有元素label一致,则不需要再次划分。否则继续选择增益最大的属性继续划分。直到构成完整的决策树。
机器学习实战-ch3-决策树的更多相关文章
- 【Python机器学习实战】决策树和集成学习(一)
摘要:本部分对决策树几种算法的原理及算法过程进行简要介绍,然后编写程序实现决策树算法,再根据Python自带机器学习包实现决策树算法,最后从决策树引申至集成学习相关内容. 1.决策树 决策树作为一种常 ...
- 【Python机器学习实战】决策树与集成学习(七)——集成学习(5)XGBoost实例及调参
上一节对XGBoost算法的原理和过程进行了描述,XGBoost在算法优化方面主要在原损失函数中加入了正则项,同时将损失函数的二阶泰勒展开近似展开代替残差(事实上在GBDT中叶子结点的最优值求解也是使 ...
- 【Python机器学习实战】决策树和集成学习(二)——决策树的实现
摘要:上一节对决策树的基本原理进行了梳理,本节主要根据其原理做一个逻辑的实现,然后调用sklearn的包实现决策树分类. 这里主要是对分类树的决策进行实现,算法采用ID3,即以信息增益作为划分标准进行 ...
- 【Python机器学习实战】决策树与集成学习(四)——集成学习(2)GBDT
本打算将GBDT和XGBoost放在一起,但由于涉及内容较多,且两个都是比较重要的算法,这里主要先看GBDT算法,XGBoost是GBDT算法的优化和变种,等熟悉GBDT后再去理解XGBoost就会容 ...
- 【Python机器学习实战】决策树与集成学习(六)——集成学习(4)XGBoost原理篇
XGBoost是陈天奇等人开发的一个开源项目,前文提到XGBoost是GBDT的一种提升和变异形式,其本质上还是一个GBDT,但力争将GBDT的性能发挥到极致,因此这里的X指代的"Extre ...
- 03机器学习实战之决策树CART算法
CART生成 CART假设决策树是二叉树,内部结点特征的取值为“是”和“否”,左分支是取值为“是”的分支,右分支是取值为“否”的分支.这样的决策树等价于递归地二分每个特征,将输入空间即特征空间划分为有 ...
- 机器学习实战python3 决策树ID3
代码及数据:https://github.com/zle1992/MachineLearningInAction 决策树 优点:计算复杂度不高,输出结果易于理解,对中间值的缺失不敏感,可以处理不相关特 ...
- 机器学习实战:决策树的存储读写文件报错(Python3)
错误原因:pickle模块存储的是二进制字节码,需要以二进制的方式进行读写 1. 报错一:TypeError: write() argument must be str, not bytes 将决策树 ...
- 03机器学习实战之决策树scikit-learn实现
sklearn.tree.DecisionTreeClassifier 基于 scikit-learn 的决策树分类模型 DecisionTreeClassifier 进行的分类运算 http://s ...
- 【Python机器学习实战】决策树与集成学习(三)——集成学习(1)
前面介绍了决策树的相关原理和实现,其实集成学习并非是由决策树演变而来,之所以从决策树引申至集成学习是因为常见的一些集成学习算法与决策树有关比如随机森林.GBDT以及GBDT的升华版Xgboost都是以 ...
随机推荐
- [Robot Framework] Robot Framework用Execute Javascript对XPath表示的元素执行Click操作
Execute Javascript document.evaluate("//a[contains(@href,'createBook')]", document, null, ...
- office 2007,SQL Server 2008,VS2010安装步骤
office 2007,SQL Server 2008,VS2010的安装顺序是不是office 2007,SQL Server 2008,VS2010呢? 前几天先安装了SQL Server 200 ...
- Mockito学习(zz)
junitmaven软件测试框架项目管理 Mockito是一个流行的Mocking框架.它使用起来简单,学习成本很低,而且具有非常简洁的API,测试代码的可读性很高.因此它十分受欢迎,用 户群越来越 ...
- ajax +jsp+iframe无刷新上传文件[转]
http://hi.baidu.com/zj360202/blog/item/f23e3711f929c774cb80c475.html ajax jsp 无刷新上传文件 2009-10-26 16: ...
- 百度地图经纬度和地址互转(Java代码)
这是基于springmvc+mybatis 的一个controller.如果不是这个框架,可以把方法实体抽到自己写的一个类中,然后再测试 package com.uwitec.controller.s ...
- ACM-ICPC 2018 徐州赛区网络预赛 B BE, GE or NE(博弈,记忆化搜索)
链接https://nanti.jisuanke.com/t/31454 思路 开始没读懂题,也没注意看数据范围(1000*200的状态,记忆化搜索随便搞) 用记忆化搜索处理出来每个状态的胜负情况 因 ...
- java Concurrent包学习笔记(五):Semaphore
一.Semaphore 是什么 信号量Semaphore是一个并发工具类,用来控制可同时并发的线程数,其内部维护了一组虚拟许可,构造函数初始化的时候可以指定许可的总数量 每次线程执行操作时先通过ac ...
- iptables说明(转)
原文:https://www.linuxidc.com/Linux/2016-09/134832.htm 前提基础: 当主机收到一个数据包后,数据包先在内核空间中处理,若发现目的地址是自身,则传到用户 ...
- Linux下启动tomcat报错,WARN org.apache.zookeeper.ClientCnxn - Session 0x0 for server null, unexpected error, closing socket connection and attempting reconnect java.net.ConnectException:
tomcat启动完了之后,一直不停的打印这种错误信息,看表面上,应该是zk节点下的数据是空的,连接不上服务,所以一直在尝试连接,然后一直又连不上: 完整的错误信息: 407662 [usf-ZooKe ...
- 查询正在执行的SQL语句DBCCINPUTBUFFER
DBCC INPUTBUFFER 返回进程下SQL语句 如果查询所有的进程如何呢? 创建一个存储过程 CREATE proc pr_dbccINPUTBUFFER(@spid varchar(200) ...