
Spark2.1集群安装(standalone模式)
机器部署
准备三台Linux服务器,安装好JDK1.7
下载Spark安装包
上传spark-2.1.0-bin-hadoop2.6.tgz安装包到Linux(intsmaze-131)上
解压安装包到指定位置tar -zxvf spark-2.1.0-bin-hadoop2.6.tgz -C /home/hadoop/app/spark2.0/
原文和作者一起讨论:http://www.cnblogs.com/intsmaze/p/6569036.html
微信:intsmaze
配置Spark
进入到Spark安装目录
cd /spark-2.1.0-bin-hadoop2.6/conf
mv spark-env.sh.template spark-env.sh
vi spark-env.sh
在该配置文件中添加如下配置
export JAVA_HOME=/home/hadoop/app/jdk1.7.0_65

export SPARK_MASTER_IP=intsmaze-131(指定standalone模式中主节点master是哪一台spark节点)

export SPARK_MASTER_PORT=7077
mv slaves.template slaves
vi slaves
在该文件中添加子节点所在的位置(Worker节点)
intsmaze-131

intsmaze-132

intsmaze-134
将配置好的Spark拷贝到其他节点上(注意节点的路径必须和master一样,否则master启动集群回去从节点中对应目录中去启动work,不一致会报No such file or directory)
scp -r spark-2.1.0-bin-hadoop2.6/ intsmaze-132:/home/hadoop/app/spark2.0/

scp -r spark-2.1.0-bin-hadoop2.6/ intsmaze-134:/home/hadoop/app/spark2.0/
Spark集群配置完毕,目前是1个Master,3个Work,在intsmaze-131(master节点)上启动Spark集群
/home/hadoop/app/spark2.0/spark-2.1.0-bin-hadoop2.6/sbin/start-all.sh(spark集群不需要启动hadoop集群等,与hadoop集群无关。如果配置为spark on yarn上,那么必须启动spark和yarn集群而不需要启动hadoop)
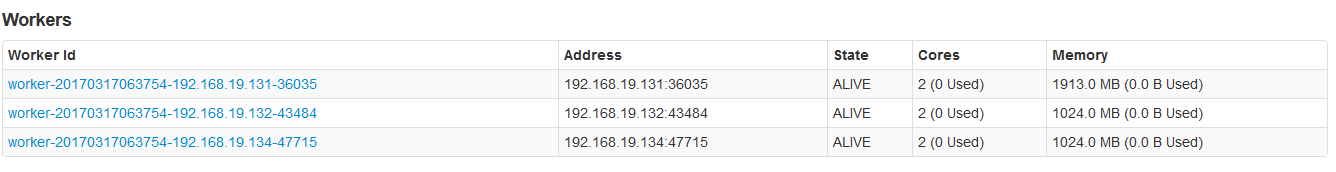
启动后执行jps命令,主节点上有Master进程和Work进程,其他子节点上有Work进程,登录Spark管理界面查看集群状态(主节点):http://intsmaze-131:8080/
执行第一个spark程序
/home/hadoop/app/spark2.0/spark-2.1.0-bin-hadoop2.6/bin/spark-submit \

 --class org.apache.spark.examples.SparkPi \

 --master spark://intsmaze-131:7077 \

 --executor-memory 1G \

 --total-executor-cores 2 /home/hadoop/app/spark2.0/spark-2.1.0-bin-hadoop2.6/examples/jars/spark-examples_2.11-2.1.0.jar \

 100
该算法是利用蒙特·卡罗算法求PI。
启动Spark Shell
spark-shell是Spark自带的交互式Shell程序,方便用户进行交互式编程,用户可以在该命令行下用scala编写spark程序。
 /home/hadoop/app/spark2.0/spark-2.1.0-bin-hadoop2.6/bin/spark-shell \

 --master spark://intsmaze-131:7077 \

--executor-memory 2g \

--total-executor-cores 2
参数说明:
--master spark://intsmaze-131:7077 指定Master的地址
--executor-memory 2g 指定每个worker可用内存为2G,现有集群该任务将无法启动,应该修改为512m。
--total-executor-cores 2 指定整个任务使用的cup核数为2个。
注意:如果给该任务分配的资源无法达到指定的,将无法成功启动job。比如服务器节点可以内存为为1G,你设置每个worker2G,将会无法启动任务。askSchedulerImpl: Initial job has not accepted any resources; check your cluster UI to ensure that workers are registered and have sufficient resources
如果启动spark shell时没有指定master地址,但是也可以正常启动spark shell和执行spark shell中的程序,其实是启动了spark的local模式,该模式仅在本机启动一个进程,没有与集群建立联系。Spark Shell中已经默认将SparkContext类初始化为对象sc。用户代码如果需要用到,则直接应用sc即可。
在spark shell中编写WordCount程序
1.首先启动hdfs
2.向hdfs上传一个文件到intsmaze-131:9000/words.txt
3.在spark shell中用scala语言编写spark程序
sc.textFile("hdfs://192.168.19.131:9000/words.txt").flatMap(_.split(" ")).map((_,1)).reduceByKey(_+_).saveAsTextFile("hdfs://192.168.19.131:9000/out")
4.使用hdfs命令查看结果
hdfs dfs -ls hdfs://intsmaze-131:9000/out/p*
说明:
sc是SparkContext对象,该对象时提交spark程序的入口

textFile(hdfs://intsmaze-131:9000/words.txt)是hdfs中读取数据

flatMap(_.split(" "))先map在压平

map((_,1))将单词和1构成元组

reduceByKey(_+_)按照key进行reduce,并将value累加

saveAsTextFile("hdfs://intsmaze-131:9000/out")将结果写入到hdfs中
配置Spark的高可用
到此为止,Spark集群安装完毕,但是有一个很大的问题,那就是Master节点存在单点故障,要解决此问题,就要借助zookeeper,并且启动至少两个Master节点来实现高可靠,配置方式比较简单:
Spark集群规划:intsmaze-131,intsmaze-132是Master;intsmaze-131,intsmaze-132,intsmaze-134是Worker
安装配置zk集群,并启动zk集群
停止spark所有服务,修改配置文件spark-env.sh,在该配置文件中删掉SPARK_MASTER_IP并添加如下配置
export SPARK_DAEMON_JAVA_OPTS="-Dspark.deploy.recoveryMode=ZOOKEEPER -Dspark.deploy.zookeeper.url=zk1,zk2,zk3 -Dspark.deploy.zookeeper.dir=/spark"在node4上执行sbin/start-all.sh脚本,然后在node5上执行sbin/start-master.sh启动第二个Master
Spark2.1集群安装(standalone模式)的更多相关文章
- flink部署操作-flink standalone集群安装部署
flink集群安装部署 standalone集群模式 必须依赖 必须的软件 JAVA_HOME配置 flink安装 配置flink 启动flink 添加Jobmanager/taskmanager 实 ...
- CentOS7+Hadoop2.7.2(HA高可用+Federation联邦)+Hive1.2.1+Spark2.1.0 完全分布式集群安装
1 2 2.1 2.2 2.3 2.4 2.5 2.6 2.7 2.8 2.9 2.9.1 2.9.2 2.9.2.1 2.9.2.2 2.9.3 2.9.3.1 2.9.3.2 2.9.3.3 2. ...
- 第5章 选举模式和ZooKeeper的集群安装 5-1 集群的一些基本概念
xx就是我们的master,也就是我们的主节点.心跳机制,当有一个节点挂掉之后,整个集群还是可以工作的.选举模式,我们现在的master是正常运行的,但是在某些情况下它宕机了死机了,那么这个时候它这个 ...
- 大数据技术之_19_Spark学习_01_Spark 基础解析 + Spark 概述 + Spark 集群安装 + 执行 Spark 程序
第1章 Spark 概述1.1 什么是 Spark1.2 Spark 特点1.3 Spark 的用户和用途第2章 Spark 集群安装2.1 集群角色2.2 机器准备2.3 下载 Spark 安装包2 ...
- CentOS6安装各种大数据软件 第十章:Spark集群安装和部署
相关文章链接 CentOS6安装各种大数据软件 第一章:各个软件版本介绍 CentOS6安装各种大数据软件 第二章:Linux各个软件启动命令 CentOS6安装各种大数据软件 第三章:Linux基础 ...
- spark集群安装并集成到hadoop集群
前言 最近在搞hadoop+spark+python,所以就搭建了一个本地的hadoop环境,基础环境搭建地址hadoop2.7.7 分布式集群安装与配置 本篇博客主要说明,如果搭建spark集群并集 ...
- Spark入门:第2节 Spark集群安装:1 - 3;第3节 Spark HA高可用部署:1 - 2
三. Spark集群安装 3.1 下载spark安装包 下载地址spark官网:http://spark.apache.org/downloads.html 这里我们使用 spark-2.1.3-bi ...
- 3 Spark 集群安装
第3章 Spark集群安装 3.1 Spark安装地址 1.官网地址 http://spark.apache.org/ 2.文档查看地址 https://spark.apache.org/docs/2 ...
- (转)ZooKeeper伪分布式集群安装及使用
转自:http://blog.fens.me/hadoop-zookeeper-intro/ 前言 ZooKeeper是Hadoop家族的一款高性能的分布式协作的产品.在单机中,系统协作大都是进程级的 ...
随机推荐
- 2017《JAVA技术》预备作业
1.阅读邹欣老师的博客,谈谈你期望的师生关系是什么样的? ==我期望的师生关系是长辈和晚辈,前辈和后生,朋友与朋友之间的关系,作为晚辈,要尊敬长辈,不能对长辈进行言语攻击和起冲突:作为后生,要谨遵教诲 ...
- Oracle_关联查询
1. 等值连接(Equijoin).非等值连接(Non-Equijoin).外连接(Outer join):-->左外连接-->右外连接.自连接(Self join) 交叉连接(Cross ...
- 点击弹窗后再刷新html页面
当alert弹出框点击确定以后,再让页面重新加载一下 具体的代码如下: <script type="text/javascript"> alert("签到成功 ...
- app与后台交互之间的几种安全认证机制
1.HTTP简单基本认证方式 这个是早期交互用得比较多的一种方式,主要是使用用户名和密码来交互,由于在每次的交互中,用户名和密码都会暴露给第三方,那么这么做是不可取的,风险十分大,所以这种认证方式并没 ...
- 模块化写法-IIFE解析
一.IIFE解释 全拼Imdiately Invoked Function Expression,立即执行的函数表达式. 像如下的代码所示,就是一个匿名立即执行函数: (function(windo ...
- ReentrantLock实现原理
以下是本篇文章的大纲 1 synchronized和lock 1.1 synchronized的局限性 1.2 Lock简介 2 AQS 3 lock()与unlock()实现原理 3.1 基础知识 ...
- SDOI Day1
好了做了SDOI day1的3道题,来讲下做法及感想吧 T1:排序(暴力,搜索) 题目:http://www.lydsy.com/JudgeOnline/problem.php?id=3990 我们可 ...
- 纯css实现京东导航菜单
纯CSS代码实现导航菜单,推荐在chrome预览! 预览请点击这里:mygithub <!doctype html> <html lang="en"> &l ...
- Struts2初步接触
使用idea快速搭建Struts2的Maven项目 首先使用intelij idea部署Maven项目 1.jar包引入 pom.xml 我们用的是阿里云 我用的是最新版的Struts2核心 ...
- 深入理解ajax系列第四篇——请求实例
前面的话 在使用ajax的过程中,常用的请求方式是GET和POST两种.本文将以实例的形式来详细说明这两种请求方式 GET GET是最常见的请求类型,最常用于向服务器查询某些信息.必要时,可以将查询字 ...