
Hadoop生态圈-HBase的HFile创建方式
Hadoop生态圈-HBase的HFile创建方式
作者:尹正杰
版权声明:原创作品,谢绝转载!否则将追究法律责任。
废话不多说,直接上代码,想说的话都在代码的注释里面。
一.环境准备
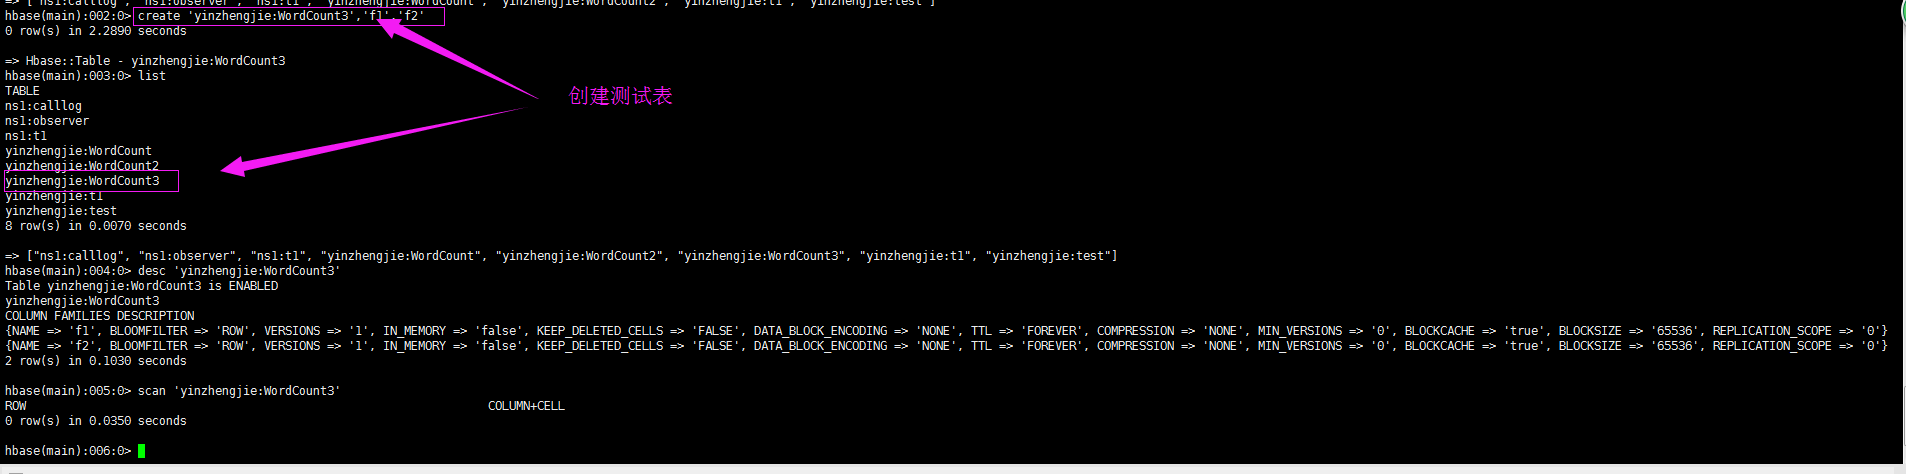
list

create 'yinzhengjie:WordCount3','f1','f2'

list

desc 'yinzhengjie:WordCount3'

scan 'yinzhengjie:WordCount3'
二.编写HFile创建方式的代码
1>.编写Map端代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E7%94%9F%E6%80%81%E5%9C%88/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.hbase.hfile;

 import org.apache.hadoop.io.IntWritable;

 import org.apache.hadoop.io.LongWritable;

 import org.apache.hadoop.io.Text;

 import org.apache.hadoop.mapreduce.Mapper;

 import java.io.IOException;

 public class HFileOutputMapper extends Mapper<LongWritable, Text, Text, IntWritable> {

     @Override

     protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

         //得到一行数据

         String line = value.toString();

         String[] arr = line.split(" ");

         //

         for (String word : arr){

             context.write(new Text(word),new IntWritable(1));

         }

     }

 }
2>.编写Reducer端代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E7%94%9F%E6%80%81%E5%9C%88/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.hbase.hfile;

 import org.apache.hadoop.hbase.Cell;

 import org.apache.hadoop.hbase.CellUtil;

 import org.apache.hadoop.hbase.KeyValue;

 import org.apache.hadoop.hbase.io.ImmutableBytesWritable;

 import org.apache.hadoop.hbase.util.Bytes;

 import org.apache.hadoop.io.IntWritable;

 import org.apache.hadoop.io.Text;

 import org.apache.hadoop.mapreduce.Reducer;

 import java.io.IOException;

 public class HFileOutputReducer extends Reducer<Text,IntWritable,ImmutableBytesWritable,Cell> {

     @Override

     protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {

         int sum = 0;

         for (IntWritable value : values) {

             sum += value.get();

         }

         if(key.toString().length() > 0){

             ImmutableBytesWritable outKey = new ImmutableBytesWritable(Bytes.toBytes(key.toString()));

             //创建cell

             Cell cell = CellUtil.createCell(Bytes.toBytes(key.toString()),

                     Bytes.toBytes("f1"), Bytes.toBytes("count"),System.currentTimeMillis(),

                     KeyValue.Type.Minimum,Bytes.toBytes(sum+""),null);

             context.write(outKey,cell);

         }

     }

 }
3>.编写主程序代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E7%94%9F%E6%80%81%E5%9C%88/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.hbase.hfile;

 import org.apache.hadoop.conf.Configuration;

 import org.apache.hadoop.fs.Path;

 import org.apache.hadoop.hbase.Cell;

 import org.apache.hadoop.hbase.HBaseConfiguration;

 import org.apache.hadoop.hbase.HTableDescriptor;

 import org.apache.hadoop.hbase.TableName;

 import org.apache.hadoop.hbase.client.Connection;

 import org.apache.hadoop.hbase.client.ConnectionFactory;

 import org.apache.hadoop.hbase.io.ImmutableBytesWritable;

 import org.apache.hadoop.hbase.mapreduce.HFileOutputFormat2;

 import org.apache.hadoop.io.IntWritable;

 import org.apache.hadoop.io.Text;

 import org.apache.hadoop.mapreduce.Job;

 import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

 import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

 public class App {

     public static void main(String[] args) throws Exception {

         System.setProperty("HADOOP_USER_NAME", "yinzhengjie");

         Configuration conf = HBaseConfiguration.create();

         conf.set("fs.defaultFS","file:///");

         Connection conn = ConnectionFactory.createConnection(conf);

         Job job = Job.getInstance(conf);

         job.setJobName("HFile WordCount");

         job.setJarByClass(App.class);

         job.setMapperClass(HFileOutputMapper.class);

         job.setReducerClass(HFileOutputReducer.class);

         //设置输出格式

         job.setOutputFormatClass(HFileOutputFormat2.class);

         //设置路径

         FileInputFormat.addInputPath(job,new Path("file:///D:\\BigData\\yinzhengjieData\\word.txt"));

         FileOutputFormat.setOutputPath(job,new Path("file:///D:\\BigData\\yinzhengjieData\\hfile"));

         //设置输出k-v

         job.setOutputKeyClass(ImmutableBytesWritable.class);

         job.setOutputValueClass(Cell.class);

         //设置map端输出k-v

         job.setMapOutputKeyClass(Text.class);

         job.setMapOutputValueClass(IntWritable.class);

         /**

          *      配置和"yinzhengjie:WordCount3"进行关联,也就是说"yinzhengjie:WordCount3"这个表必须在HBase数据库中存在,

          * 实际操作是以"yinzhengjie:WordCount3"为模板,便于生成HFile文件!

          */

         HFileOutputFormat2.configureIncrementalLoad(job, new HTableDescriptor(TableName.valueOf("yinzhengjie:WordCount3")),

                 conn.getRegionLocator(TableName.valueOf("yinzhengjie:WordCount3")) );

         job.waitForCompletion(true);

     }

 }
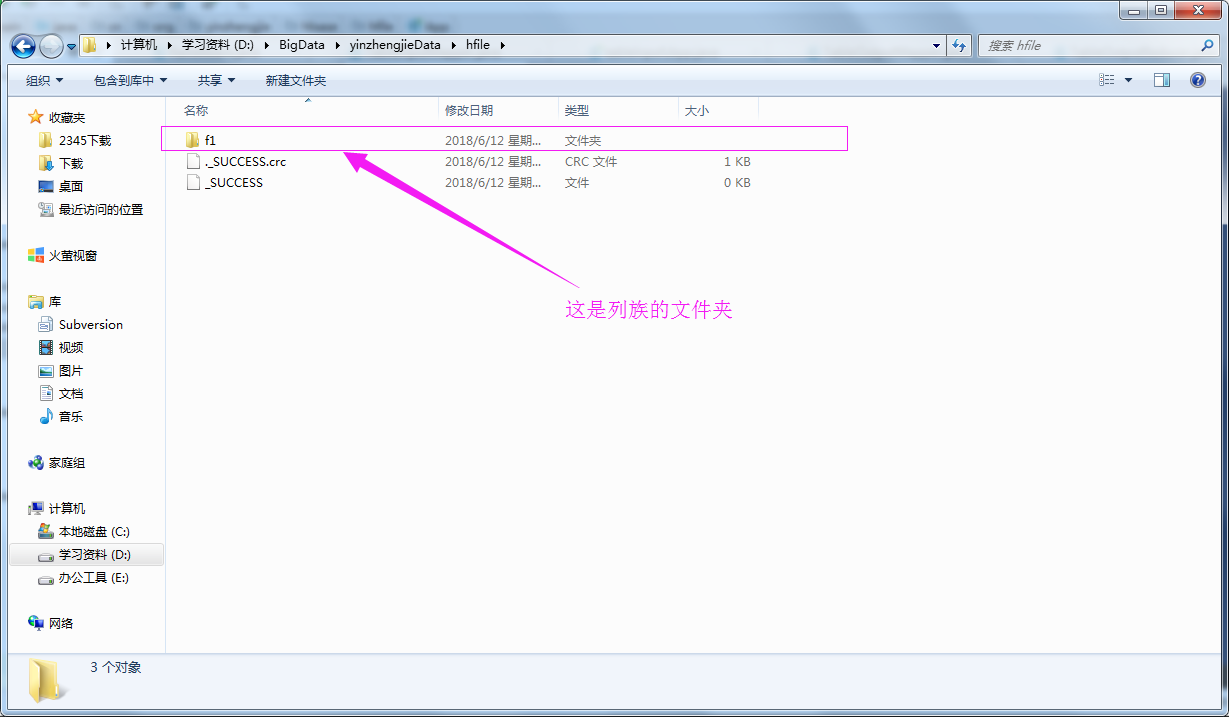
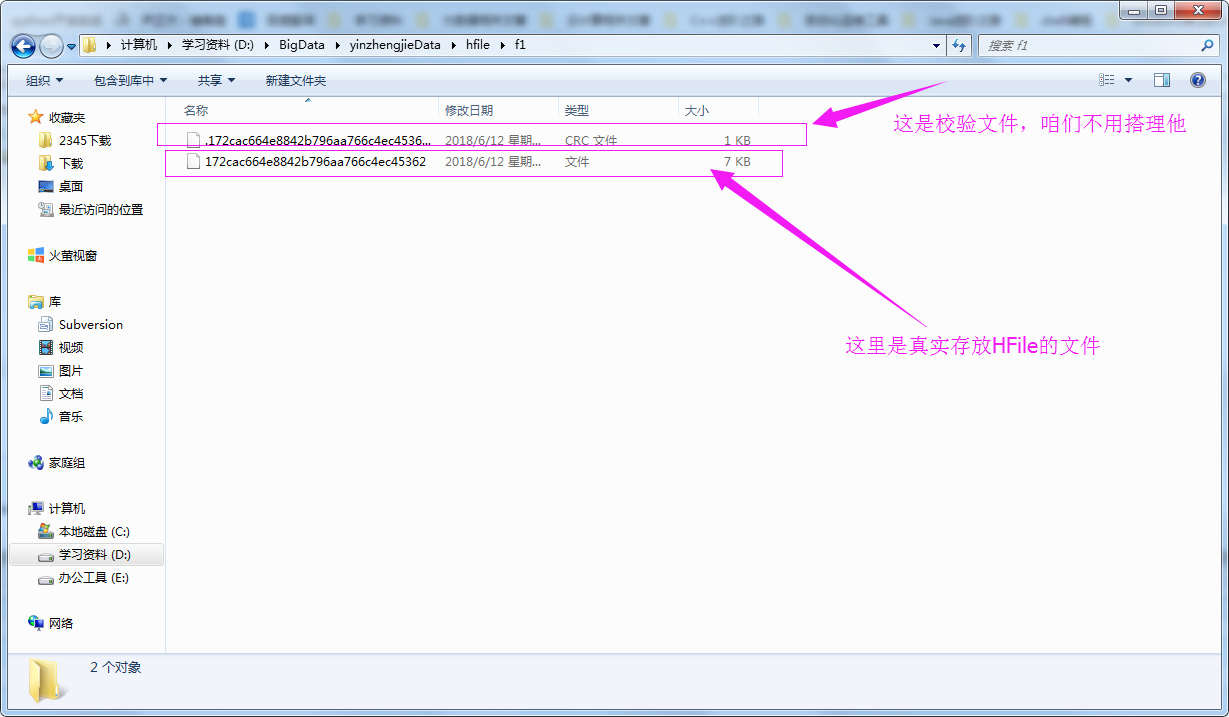
4>.查看测试结果
Hadoop生态圈-HBase的HFile创建方式的更多相关文章
- Hadoop生态圈-基于yum源的方式部署Cloudera Manager5.15.1
Hadoop生态圈-基于yum源的方式部署Cloudera Manager5.15.1 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 我之前分享过关于离线方式部署Cloudera ...
- Hadoop生态圈-hbase介绍-伪分布式安装
Hadoop生态圈-hbase介绍-伪分布式安装 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.HBase简介 HBase是一个分布式的,持久的,强一致性的存储系统,具有近似最 ...
- Hadoop生态圈-HBase性能优化
Hadoop生态圈-HBase性能优化 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任.
- Hadoop生态圈-Hbase的协处理器(coprocessor)应用
Hadoop生态圈-Hbase的协处理器(coprocessor)应用 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任.
- Hadoop生态圈-Hbase的rowKey设计原则
Hadoop生态圈-Hbase的rowKey设计原则 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任.
- Hadoop生态圈-Hbase的Region详解
Hadoop生态圈-Hbase的Region详解 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任.
- Hadoop生态圈-Hbase过滤器(Filter)
Hadoop生态圈-Hbase过滤器(Filter) 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任.
- Hadoop生态圈-Hbase的API常见操作
Hadoop生态圈-Hbase的API常见操作 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任.
- Hadoop生态圈-hbase常用命令
Hadoop生态圈-hbase常用命令 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任.
随机推荐
- 配置JDBC
在数据库和MyEclipse都安装好的情况下进行配置: 1.将JDBC(sqljdbc_4.0.2206.100_chs.exe)文件解压到C盘program files下面(也可以将解压后的文件Mi ...
- (2016.2.2)1001.A+B Format (20)解题思路
https://github.com/UNWILL2LOSE/object-oriented 解题思路 目标: *首先运算要求实现输入2个数后,输出类似于银行的支票上的带分隔符规则的数字. 代码实现思 ...
- 【动态规划】POJ-2229
一.题目 Description Farmer John commanded his cows to search for different sets of numbers that sum to ...
- java核心技术卷1知识点
1.comparable和comparator的区别. Comparable可以认为是一个内比较器,实现了Comparable接口的类有一个特点,就是这些类是可以和自己比较的. public inte ...
- JS面向对象(封装,继承)
在六月份找工作中,被问的最多的问题就是: js面向对象,继承,封装,原型链这些,你了解多少? 额,,,我怎么回答呢, 只能说,了解一些,不多不少,哈哈哈哈,当然,这是玩笑话. 不过之前学过java,来 ...
- C# QR二维码DEMO
QR二维码 二维码的一种 相关类库 ThoughtWorks.QRCode 第三方类库 DEMO功能 Encode 生成二维码图片 Encoding 编码 Correction Level 等级 Ve ...
- Eclipse HTML Editor
需插件: 1.GEF 3.1 安装程序下载 下载地址: http://download.eclipse.org/tools/gef/downloads/drops/R-3.1-200507071758 ...
- 【uoj#143】[UER #5]万圣节的数列 构造
题目描述 给出一个的数列,将其重新排列,使得其等差子序列的数目最小.输出一种可能的排列后的数列. 题解 构造 那天和 EdwardFrog 讨论 bzoj2124 的构造时突然有的灵感,最后发现就是这 ...
- JDBC数据库连接技术
[学习笔记]JDBC数据库连接技术(Java Database Connectivity) 一.JDBC简介 Java是通过JDBC技术实现对各种数据库的访问的,JDBC是Java数据库连接技术的简称 ...
- P4101 [HEOI2014]人人尽说江南好
题目描述 小 Z 是一个不折不扣的 ZRP(Zealot Round-game Player,回合制游戏狂热玩家),最近他 想起了小时候在江南玩过的一个游戏. 在过去,人们是要边玩游戏边填词的,比如这 ...