
django优化和扩展(一)
mysql优化基础
进行django产品开发或上线之前,有必要了解一下mysql的基础知识,orm太过抽象,导致很多朋友对于mysql了解得太少,而且orm不像sqlalchemy那样可以跟mysql走的那么近!如果要设计出合理的表结构(在orm中就是model类),显然把一个ip设置成64个字符是大大地浪费。本文结合mysql手册,做一些建表优化。
一、尽可能地使用最有效(最小)的数据类型
class Customer(models.Model):

    qq = models.CharField(u"QQ号",max_length=64,unique=True)

    name = models.CharField(u"姓名",max_length=32,blank=True,null=True)

    phone = models.BigIntegerField(u'手机号',blank=True,null=True)

    stu_id = models.CharField(u"学号",blank=True,null=True,max_length=64)
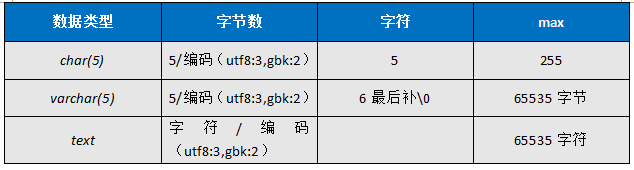
上面这个类从优化角度显然是不合理的,一个qq号占64个字符,姓名32个字符,手机号用的bigint,学号64位,一行数据得占多大空间,下面两张图写明了主要数据类型的区别!
(一)、整形列的应用
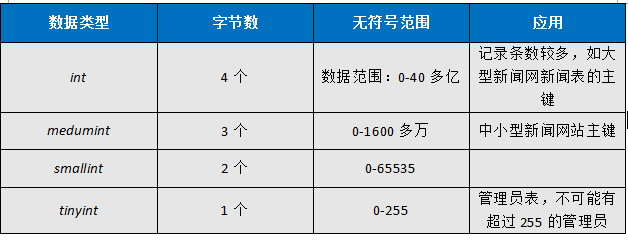
整形列的选择要慎重,一定要坚持最小化的原则,而且一定要选择无符号的整数,在orm无符号的声明如下:
class cj_user(models.Model):

    cjid = models.PositiveIntegerField() # Positive 开头一般都是无符号
# 在声明非主键字段时可以如上应用,如果优化主键,必须重写AutoField,因为orm默认生成的是int类型,且是有符号的,优化方法可以参照我最后写的
(二)、char、varchar、text的区别
讲之前问2个问题:
1,char(5)和varchar(5) 能不能存下'abcdefg'?
2,char(5)和varchar(20)同样存'abcd'各占几个字符?几个字节?
()中的数字都是字符数,如果要算字节数必须utf-8*3 gbk*2,但varchar是变长,内容多少就占多少,他有一点比较特殊,varchar(20)存'abc'的时候占4个字符,因为在末尾加\0
在工作中应尽量使用定长,如char和上面的整形列 都是定长,有利加速,变长通常用一对一的形式存在附加表中,也可以综合应用,但最佳的优化还是分表存储!手机,身份证、姓名、密码都是比较固定的字段,如密码,无论设几位,最后都会被加密成32位字符串!以下是我的用户表( FixCharField是我自定义的char,因为在orm中不支持char,CharField生成的是varchar变长类型。在本文的最后我会讲一下,如何自定义!)
class hwj_user(models.Model):

    xm = FixCharField(max_length=4)

    tel = FixCharField(max_length=11)

    sfz = FixCharField(max_length=18)

    pwd = FixCharField(max_length=32)
注:varchar(max)的单位是字节即最多存65535个字节,以utf-8为例,约2万多个汉字!
(三)主键和非空字段要用not null
手册上说:如果可能,声明列为NOT NULL。它使任何事情更快而且每列可以节省一位。这点orm中已经默认这么干了,当然这里也建议你不要把
null=True写上去
二、慎用索引
索引是会加快速度,但我觉除了主键、多对多的表无法避免外,其他都要慎用,因为索引会加快查询速度,却会降低写入速度,如果你的表有类似频繁写入的功能,如抢购等,那你就不要使用,像唯一这种都属于索引,尽量在业务中去判断他是否存在。
三、多设默认值
默认值的设置也是优化的一方面,也能使数据层避免产生错误,即便是not null的列,也应该给他设上default='',数值类型default=0等等!
四、随机排序的实现
由于orm不支持随机排序,如果要实现数据的随机排机,只能借助于python(也可以重写oder_by但太复杂了)
   ids = models.Tk.objects.filter(eid_id=exam_data.id).all().values('id')

    rand_id=[]

    for id in ids:

        rand_id.append(id["id"])

    rand_num = random.sample(rand_id,5)

    print(rand_num)

    tks = models.Tk.objects.filter(eid_id=exam_data.id,id__in=rand_num).all()
1,先取出所有的id,把他们放到列表
2,利用random.sample 在列中随机选择5个id
3,利用orm的id__in过滤出id所在行的记录
五、自定义数据类型
class FixCharField(models.Field):

    def __init__(self, *args, **kwargs):

        super(FixCharField, self).__init__(*args, **kwargs)

    def db_type(self, connection):

        return 'char(%s)' % self.max_length

class hwj(models.Model):

    my_field = FixCharField(max_length=25)
只是重写了,具体可看django源码
六、模板中的计数 上层循环计数
有的时候要输出上层循环的计数值,在相关书籍上也只看到当前循环{{ forloop.counter }},看了底层才知道还有forloop.parentloop.counter
以向是我模板中用反向查找实现了在题目下显示题目的方法,用嵌套循环实现的!
    {% for o in tks %}

    <div class="panel panel-info">

  <!-- Default panel contents -->

  <div class="panel-heading" name="ks{{ o.attr }}">{{ forloop.counter }}、{{ o.subject }}</div>

  <div class="panel-body">

     {% for i in o.op_set.all %}

  <p><input type="radio" name="dx{{ forloop.parentloop.counter }}" title="{{o.answer}}"  class="option-input radio" value="{{i.opstr}}"> {{i.opstr}} {{i.opname}}</p>

  <p style="padding:0; margin:0; height:5px;"></p>

{% endfor %}
马上开会了,今天就写到这里。
django优化和扩展(一)的更多相关文章
- Django 优化杂谈
Django 优化杂谈 Apr 21 2017 总结下最近看过的一些文章,然后想到的一些优化点,整理一下. 数据库连接池 http://mt.dbanotes.net/arch/instagram.h ...
- Python学习---Django的request扩展[获取用户设备信息]
关于Django的request扩展[获取用户设备信息] settings.py INSTALLED_APPS = [ ... 'app01', # 注册app ] STATICFILES_DIRS ...
- Flume FileChannel优化(扩展)实践指南
本文系微博运维数据平台(DIP)在Flume方面的优化扩展经验总结,在使用Flume FileChannel的场景下将吞吐率由10M/s~20M/s提升至80M/s~90M/s,分为四个部分进行介绍: ...
- 谱聚类算法(Spectral Clustering)优化与扩展
谱聚类(Spectral Clustering, SC)在前面的博文中已经详述,是一种基于图论的聚类方法,简单形象且理论基础充分,在社交网络中广泛应用.本文将讲述进一步扩展其应用场景:首先是User- ...
- django用户信息扩展
Django封装了好多东西,拿来用就可以了,帮我们封装类用户的登录认证,用户的表 所以Django自带有用户表,当扩展用户表后一些表就会被替换 用户认证相关的 功能放在django.contri ...
- PostgreSQL 欺骗优化器之扩展统计信息
一.什么是扩展统计 扩展统计对象, 追踪指定表.外部表或物化视图的数据. 目前支持的种类: 启用n-distinct统计的 ndistinct. 启用功能依赖性统计的dependencies. 启用最 ...
- 优化与扩展Mybatis的SqlMapper解析
接上一篇博文,这一篇来讲述怎么实现SchemaSqlMapperParserDelegate——解析SqlMapper配置文件. 要想实现SqlMapper文件的解析,还需要仔细分析一下mybatis ...
- ecshop二次开发系统缓存优化之扩展数据缓存的必要性与方法
1.扩展数据缓存的必要性 大家都知道ecshop系统使用的是静态模板缓存,在后台可以设置静态模板的缓存时间,只要缓存不过期,用户访问页面就相当于访问静态页面,速度可想而知,看似非常完美,但是ecsho ...
- django优化--ORM查询
ORM提供了两个方法用来优化查询效率 1. select_related 有两张表:表结构如下: class Scheme(models.Model): """ 套餐类 ...
随机推荐
- Java应用程序使用系统托盘资源
要想使自己开发的Java SE项目运行在自己的电脑系统托盘上,这并不是什么难事,总共需要如下几步即可: 1.线判断一下,系统托盘是否可用,否则接下来的程序将不可避免的报出异常咯 2.获得一个Syste ...
- quartz实现定时功能实例详解(servlet定时器配置方法)
Quartz是一个完全由java编写的开源作业调度框架,下面提供一个小例子供大家参考,还有在servlet配置的方法 Quartz是一个完全由java编写的开源作业调度框架,具体的介绍可到http:/ ...
- 基于Struts+Hibernate开发过程中遇到的错误
1.import javax.servlet.http.HttpServletRequest 导入包出错 导入包出错,通常是包未引入,HttpServletRequest包是浏览器通过http发出的 ...
- python,os操作文件,文件路径(上一级目录)
python获取文件上一级目录:取文件所在目录的上一级目录 os.path.abspath(os.path.join(os.path.dirname('settings.py'),os.path.pa ...
- Spring AOP (二)
下面介绍@AspectJ语法基础 一.切点表达式函数 AspectJ的切点表达式由关键字和操作参数组成,如execution(* greetTo(..)) 的切点表达式,execution为关键字,而 ...
- Java进阶(五十二)利用LOG4J生成服务日志
Java进阶(五十二)利用LOG4J生成服务日志 前言 由于论文写作需求,需要进行流程挖掘.前提是需要有真实的事件日志数据.真实的事件日志数据可以用来发现.监控和提升业务流程. 为了获得真实的事件日志 ...
- 蘑菇街Android组件与插件化
插件化的基石 -- apk动态加载 随着我街业务的蓬勃发展,产品和运营随时上新功能新活动的需求越来越强烈,经常可以听到"有个功能我想周x上,行不行".行么?当然是不行啦,上新功能得 ...
- OpenCV——PS 图层混合算法 (三)
具体的算法原理可以参考 PS图层混合算法之三(滤色, 叠加, 柔光, 强光) // PS_Algorithm.h #ifndef PS_ALGORITHM_H_INCLUDED #define PS_ ...
- 如何利用c中的指针实现两个8bit的数合并为16bit
对于从事单片机开发,进行单片机c语言开发的人来说,在对外部信息采集回来的数据进行处理,经常会用到,将采集到的第一个字节作为高8位,采集到的第二个字节作为低8位,从而构成1个16bit的数,得到一次完整 ...
- 开发Oracle 函数
函数用于返回特定的数据.如果在应用程序中,经常需要执行SQL语句来返回特定数据,那么可以基于这些操作建立特定的函数.建立函数的语法如下: CREATE [OR REPLACE] FUNCTION fu ...