
Spark SQL 读到的记录数与 hive 读到的不一致
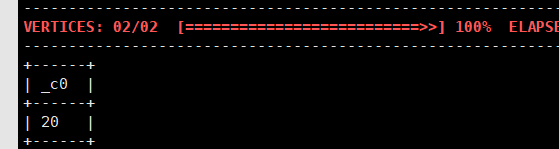
问题:我用 sqoop 把 Mysql 中的数据导入到 hive,使用了--delete-target-dir --hive-import --hive-overwrite 等参数,执行了两次。 mysql 中只有 20 条记录。在 hive shell 中,查询导入到的表的记录,得到结果 20 条,是对的。
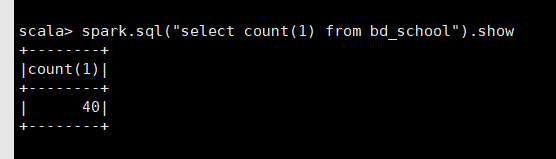
然而在 spark-shell 中,使用 spark sql 得到的结果却是 40 条。
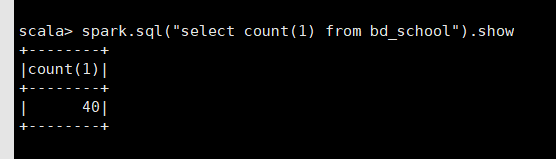
又执行了一次 sqoop 的导入,hive 中仍然查询到 20 条,而 spark shell 中却得到了 60 条!!
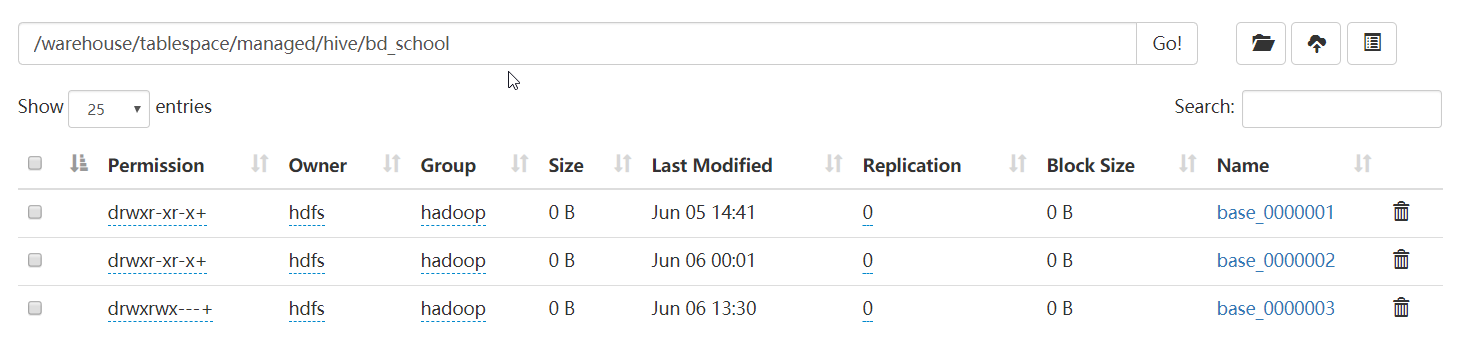
查了一下 HDFS 上,结果发现有 3 个文件
后来在网上看到有说 Hortonworks 中,用 Ambari 部署的 hive(V3.0),默认是开启 ACID 的,Spark 不支持 hive 的 ACID。更改 hive 的如下参数,关闭 ACID 功能。
hive.strict.managed.tables=false

hive.create.as.insert.only=false

metastore.create.as.acid=false
删除 hive 中的表,重新导入。
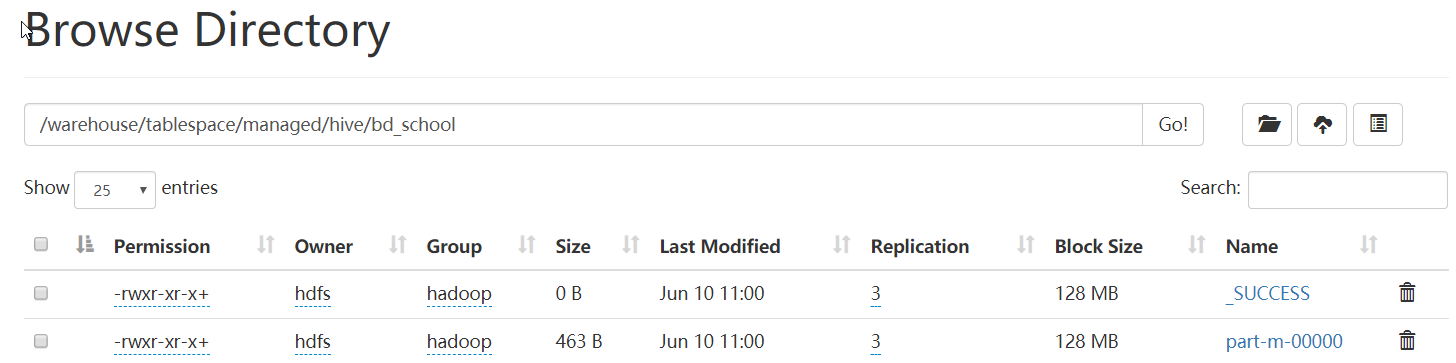
可以看到,表目录下的文件名变了,不是原来的 base_ 开头的了。
用 overwrite 的方式导入多次,也还是只有这两个文件,spark sql 读取的数据也没有出现翻倍的现象。
至此,问题算是解决了。但是不明白为什么 hive 开启 ACID 时,尽管表目录下有多个文件,但是 hive shell 能知道到底哪个是正确的,而 spark 则不知道。估计只有研究源码才能解决问题了。
Spark SQL 读到的记录数与 hive 读到的不一致的更多相关文章
- SQL Server 查询表的记录数(3种方法,推荐第一种)
http://blog.csdn.net/smahorse/article/details/8156483 --SQL Server 查询表的记录数 --one: 使用系统表. SELECT obje ...
- 【转】SQL Server 查询表的记录数(3种方法,推荐第一种)
--SQL Server 查询表的记录数 --one: 使用系统表. SELECT object_name (i.id) TableName, rows as RowCnt FROM sysindex ...
- spark SQL (五)数据源 Data Source----json hive jdbc等数据的的读取与加载
1,JSON数据集 Spark SQL可以自动推断JSON数据集的模式,并将其作为一个Dataset[Row].这个转换可以SparkSession.read.json()在一个Dataset[Str ...
- 查找 SQL SERVER 所有表记录数
-- 所有表的记录数 SELECT a.name, b.rowsFROM sysobjects AS a INNER JOIN sysindexes AS b ON a.id = b.idWHERE ...
- sqlserver sql语句查看分区记录数、查看记录所在分区
select count(1) ,$PARTITION.WorkDatePFN(workdate) from imgfile group by $PARTITION.WorkDatePFN(workd ...
- sql 查看表的记录数
select a.name as 表名,max(b.rows) as 记录条数 from sysobjects a ,sysindexes b where a.id=b.id and a.xtype= ...
- SQL 获取各表记录数的最快方法
select distinct o.name,i.rows from sysobjects o,sysindexes i where o.id=i.id and o.Xtype= 'U' and i ...
- 统计SQL Server所有表记录数
SELECT SCHEMA_NAME(t.schema_id) AS [schema] ,t.name AS tableName ,i.rows AS [rowCount] FROM sys.tabl ...
- Apache Spark 2.2.0 中文文档 - Spark SQL, DataFrames and Datasets Guide | ApacheCN
Spark SQL, DataFrames and Datasets Guide Overview SQL Datasets and DataFrames 开始入门 起始点: SparkSession ...
随机推荐
- Spring MVC的工作原理和机制
Spring MVC的工作原理和机制 参考: springMVC 的工作原理和机制 - 孤鸿子 - 博客园https://www.cnblogs.com/zbf1214/p/5265117.html ...
- linux应用之ntpdate命令联网同步时间
当Linux服务器的时间不对的时候,可以使用ntpdate工具来校正时间. 安装:yum install ntpdate ntpdate简单用法: # ntpdate ip # ntpdate 210 ...
- Linux-NoSQL之MongoDB
1.mongodb介绍 什么是MongoDB ? MongoDB 是由C++语言编写的,是一个基于分布式文件存储的开源数据库系统. 在高负载的情况下,添加更多的节点,可以保证服务器性能. MongoD ...
- linux命令学习笔记(49):at命令
在windows系统中,windows提供了计划任务这一功能,在控制面板 -> 性能与维护 -> 任务计划, 它的功能就是安排自动运行的任务. 通过'添加任务计划'的一步步引导,则可建立一 ...
- stl_multiset.h
stl_multiset.h // Filename: stl_multiset.h // Comment By: 凝霜 // E-mail: mdl2009@vip.qq.com // Blog: ...
- Android开发中高效的数据结构
android开发中,在java2ee或者android中常用的数据结构有Map,List,Set,但android作为移动平台,有些api(很多都是效率问题)显然不够理想,本着造更好轮子的精神,an ...
- Android: 一个两点触控的案例
下面是一个两点触控的案例代码: package com.zzj; import android.app.Activity; import android.os.Bundle; import andro ...
- AAC头部格式
一共有2种AAC头格式,一种是StreamMuxConfig,另一种是AudioSpecificConfig 1.AudioSpecificConfig 读写header的代码参考 ffmpeg ...
- noipd2t3列队
吉老师的题还真是难呢... 正解至今不会,只会平衡树的做法 这种用平衡树上一个点表示一段区间的题还真要做做...想起来挺难受的 建n棵平衡树表示每行的m-1个元素 再建一棵平衡树维护最后一列 中间要支 ...
- Poj 1887 Testing the CATCHER(LIS)
一.Description A military contractor for the Department of Defense has just completed a series of pre ...