
python库-urllib
urllib库提供了一系列操作url的功能,是python处理爬虫的入门级工具,网上的学习资料也很多。我做爬虫是一开始就用了Scrapy框架,并不是一步步从urllib开始的,反而是在后来解决一些小问题的时候用到了urllib库,感觉用起来很简洁也很实用,下面是我最近的一些应用总结。
1、urllib和urllib2
在python2.x的版本中有urllib和urllib2两个库,为什么这样我也没有好好去调研。两者能处理的问题有些相交,更多的是不同,在我的应用场景中,一个最重要的区别就是通过urllib2的方法可以修改header信息,而urllib不支持,后边的例子可以看到。
在python3的版本中,已经没有urllib2了,版本2中的urllib和urllib2合并在了一起,urllib自然也就支持修改头部信息
下面这两段代码是python2和python3的使用情况对比
 import urllib2

 req=urllib2.Request('https://www.python.org/')

 req.add_header('Range','bytes=0-20')

 res=urllib2.urlopen(req)

 data=res.read().decode('utf-8')

 print data
 python3:

 from urllib import request

 req=request.Request("https://www.python.org/")
 req.add_header('Range','bytes=0-20')
 res=request.urlopen(req)  res.read().decode('utf-8')
2、应用urllib爬取页面信息的完整小案例(python2)
我理解的整个爬虫的过程就是首先下载网页,然后对网页进行解析提取需要的数据,最后数据入库或者是文件等等。上面的代码已经将网页下载下来了,只不过由于修改了Range信息,所以只下载了网页的一部分。
下面的例子就是如何解析网页,我之前关于Scrapy的博客用到了Xpath的方式,下面这个例子是用的正则,其实解析网页就没有urllib什么事了...
豆瓣电影中排名前170名电影的得分之和:我用的urllib库,用urllib2也是可以的
import urllib

import re

ll=[]

for i in range(7):

     url='http://movie.douban.com/top250?start'+str(i*25)

     req=urllib.urlopen(url)

     page=req.read()

     reg='<span class="rating_num" property="v:average">([0-9]+.[0-9]+)</span>'

     regc=re.compile(reg)

     res=regc.findall(page)

     ll.extend(res)

sum=0

for i in range(170):

     sum+=float(ll[i])

print sum
3、应用urllib2发送get和post请求(python2)
get和post最简单的理解就是,get是把请求信息附加到url里,而post则是通过表单
(1)查看请求参数——看url,可以从网址栏看,也可以通过开发者工具看
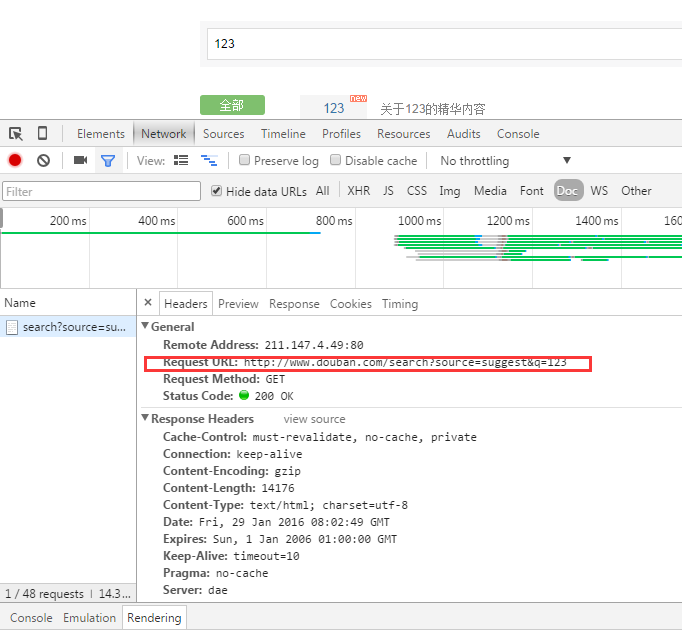
或者从,参数列表看:
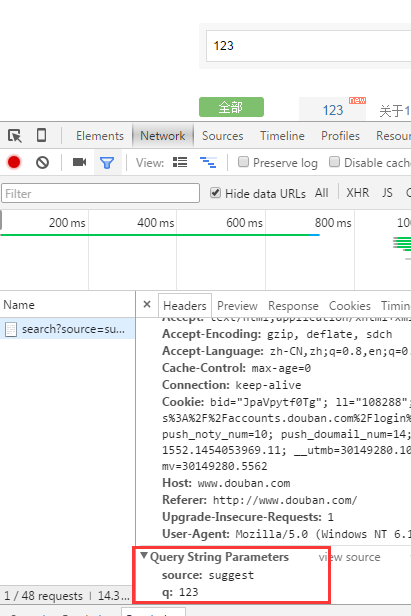
(2)get方式----把参数附加到url即可
 import urllib2

 url='http://www.douban.com/search?source=suggest&q=123'

 req=urllib2.Request(url)
(3)post方式
 import urllib

 import urllib2

 url="http://www.douban.com/search"

 data={'source':'suggest','q':''}

 data=urllib.urlencode(data)  # 编码成url的格式

 req=urllib2.Request(url=url,data=data)
4、爬虫真的很好玩~~
最后再说点有意思的,本人也是有喜欢的小明星哒,网上那么多的美图下也下不过来,肿么办呢?写个爬虫吧哈哈~前几天逛贴吧看美图突发奇想写个小爬虫,追星学习两不误呢~
import re

import urllib

def getHtml(url):

    page = urllib.urlopen(url)

    html = page.read()

    return html

def getImg(html):

    reg = r'src="(.+?\.jpg)" pic_ext'

    imgre = re.compile(reg)

    imglist = imgre.findall(html)

    x = 0

    for imgurl in imglist:

        urllib.urlretrieve(imgurl,'%s.jpg' % x)

        x = x + 1

html = getHtml("http://tieba.baidu.com/p/..........?pn=1") #改一下参数

getImg(html)
python库-urllib的更多相关文章
- python爬虫 - Urllib库及cookie的使用
http://blog.csdn.net/pipisorry/article/details/47905781 lz提示一点,python3中urllib包括了py2中的urllib+urllib2. ...
- Python爬虫Urllib库的高级用法
Python爬虫Urllib库的高级用法 设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我们需要设置一些Head ...
- Python爬虫Urllib库的基本使用
Python爬虫Urllib库的基本使用 深入理解urllib.urllib2及requests 请访问: http://www.mamicode.com/info-detail-1224080.h ...
- Python爬虫--Urllib库
Urllib库 Urllib是python内置的HTTP请求库,包括以下模块:urllib.request (请求模块).urllib.error( 异常处理模块).urllib.parse (url ...
- python之urllib库
urllib库 urllib库是Python中一个最基本的网络请求库.可以模拟浏览器的行为,向指定的服务器发送一个请求,并可以保存服务器返回的数据. urlopen函数: 在Python3的urlli ...
- python 之 Urllib库的基本使用
目录 python 之 Urllib库的基本使用 官方文档 什么是Urllib urlopen url参数的使用 data参数的使用 timeout参数的使用 响应 响应类型.状态码.响应头 requ ...
- Python使用urllib,urllib3,requests库+beautifulsoup爬取网页
Python使用urllib/urllib3/requests库+beautifulsoup爬取网页 urllib urllib3 requests 笔者在爬取时遇到的问题 1.结果不全 2.'抓取失 ...
- python中urllib, urllib2,urllib3, httplib,httplib2, request的区别
permike原文python中urllib, urllib2,urllib3, httplib,httplib2, request的区别 若只使用python3.X, 下面可以不看了, 记住有个ur ...
- python:利用urllib查找计算机二级准考证号
aaarticlea/png;base64,iVBORw0KGgoAAAANSUhEUgAAAaYAAAEACAIAAAB3VkWnAAAgAElEQVR4nOydZ3gUR9bv+WhExhHnDH
随机推荐
- BZOJ2823 [AHOI2012]信号塔 【最小圆覆盖】
题目链接 BZOJ2823 题解 最小圆覆盖模板 都懒得再写一次 #include<iostream> #include<cstdio> #include<cmath&g ...
- bzoj2724: [Violet 6]蒲公英(离散化+分块)
我好弱啊..这题调了2天QwQ 题目大意:给定一个长度为n(n<=40000)的序列,m(m<=50000)次询问l~r之间出现次数最多的数.(区间众数) 这题如果用主席树就可以不用处理一 ...
- [BZOJ3523][Poi2014]KLO-Bricks——全网唯一 一篇O(n)题解+bzoj最优解
Description 有n种颜色的砖块,第i种颜色的砖块有a[i]个,你需要把他们放成一排,使得相邻两个砖块的颜色不相同,限定第一个砖块的颜色是start,最后一个砖块的颜色是end,请构造出一种合 ...
- YBT 5.2 树形动态规划
题解在代码中 二叉苹果树[loj 10153] /* 若要留q条边便是要留q+1个点 所以记忆化搜索 dp[pos][ans]=max(dp[pos][ans],dp[l[pos]][k]+dp[r[ ...
- 使用C#解析并运行JavaScript代码
如果想在C#编程中解析并运行JavaScript代码,常见的方式有两种: 利用COM组件“Microsoft Script Control”,可参见:C#使用技巧之调用JS脚本方法一 利用JScrip ...
- java中静态变量与静态方法的继承(转)
总结: 1.静态变量与静态方法说继承并不确切,静态方法与变量是属于类的方法与变量.而子类也属于超类,比如说Manage extends Employee,则Manage也是一个Employee,所以子 ...
- 集成淘宝sdk
204是安全图片的问题, 请先检测以下几点: .请检测百川控制台是否已经申请初级API. .请检测百川控制台“我的产品后台”是否开通电商SDK应用.(重点检测很多用户疏忽这一点) .debug版本的可 ...
- stout代码分支之十二:巧妙的EXIT
在c++中,为了便于定位问题,进程异常退出时,需要获取返回码和错误信息.stout中将这种功能巧妙的封装成EXIT类. #define EXIT(status) __Exit(status).stre ...
- oracle to_char格式数值
C:\Users\XXX>sqlplus / as sysdba SQL :: Copyright (c) , , Oracle. All Rights Reserved. 连接到: Oracl ...
- Spring知识点复习
Spring知识点复习 一.专业术语 侵入式设计 引入框架,对现有的类的结构有影响,即需要实现或继承某些特定类.如:Struts框架 非侵入式设计 引入框架,对现有的类结构没有影响.如:Hiberna ...