
代码实战之AdaBoost
尝试用sklearn进行adaboost实战 & SAMME.R算法流程,博客地址
- 初试AdaBoost
- SAMME.R算法流程
- sklearn之AdaBoostClassifier类
- 完整实战demo
初试AdaBoost
一个简单的例子,来介绍AdaBoostClassifier。
例子放在Github上,可以直接fork。
#coding=utf-8

#python 3.5

'''

Created on 2017年11月24日

@author: Scorpio.Lu

'''

'''

在scikit-learn库中,有AdaBoostRegression(回归)和AdaBoostClassifier(分类)两个。

在对和AdaBoostClassifier进行调参时,主要是对两部分进行调参:1) AdaBoost框架调参;2)弱分类器调参

'''

#导包

from sklearn.model_selection import cross_val_score

from sklearn.datasets import load_iris

from sklearn.ensemble import AdaBoostClassifier

#载入数据,sklearn中自带的iris数据集

iris=load_iris()

'''

AdaBoostClassifier参数解释

base_estimator:弱分类器,默认是CART分类树:DecisionTressClassifier

algorithm:在scikit-learn实现了两种AdaBoost分类算法,即SAMME和SAMME.R,

           SAMME就是原理篇介绍到的AdaBoost算法,指Discrete AdaBoost

           SAMME.R指Real AdaBoost,返回值不再是离散的类型,而是一个表示概率的实数值,算法流程见后文

                            两者的主要区别是弱分类器权重的度量,SAMME使用了分类效果作为弱分类器权重,SAMME.R使用了预测概率作为弱分类器权重。

           SAMME.R的迭代一般比SAMME快,默认算法是SAMME.R。因此,base_estimator必须使用支持概率预测的分类器。

loss:这个只在回归中用到,不解释了

n_estimator:最大迭代次数,默认50。在实际调参过程中,常常将n_estimator和学习率learning_rate一起考虑

learning_rate:每个弱分类器的权重缩减系数v。f_k(x)=f_{k-1}*a_k*G_k(x)。较小的v意味着更多的迭代次数,默认是1,也就是v不发挥作用。

另外的弱分类器的调参,弱分类器不同则参数不同,这里不详细叙述

'''

#构建模型

clf=AdaBoostClassifier(n_estimators=100)  #弱分类器个数设为100

scores=cross_val_score(clf,iris.data,iris.target)

print(scores.mean())
SAMME.R算法流程
- 初始化样本权值:$ w_i=1/N,i=1,2,…,N $
- Repeat for $ m=1,2,…,M $:
- 训练一个弱分类器,得到样本的类别预测概率分布 $ p_m(x)=P(y=1|x)∈[0,1] $
- $f_m(x)=\frac{1}{2}log\frac{p_m(x)}{1-p_m(x)}$
- $w_i=w_iexp[-y_if_m(x_i)]$,同时,要进行归一化使得权重和为1
- 得到强分类模型:$sign{\sum_{m=1}^{M}f_m(x)}$
AdaBoostClassifier类
现在我们来说点理论的东西。关于AdaBoostClassifier。
sklearn.ensemble.AdaBoostClassifier的构造函数如下:
AdaBoostClassifier(base_estimator=None, n_estimators=50, learning_rate=1.0, algorithm=’SAMME.R’, random_state=None)
各个参数已经在代码里介绍过了,这里不再叙述。有一点要注意,理论上可以选择任何一个弱分类器,不过需要有样本权重。
另外有方法:
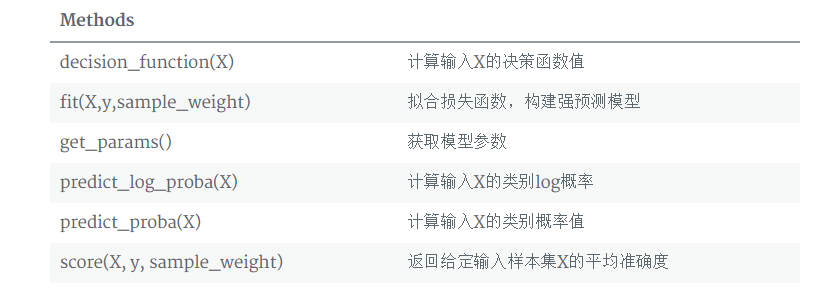
另外一些方法请见官网sklearn-AdaBoost
完整实战demo
现在再来一个完整的demo,来看看AdaBoost的分类效果
#coding=utf-8

#python 3.5

'''

Created on 2017年11月27日

@author: Scorpio.Lu

'''

import numpy as np

import matplotlib.pyplot as plt

from sklearn.ensemble import AdaBoostClassifier

from sklearn.tree import DecisionTreeClassifier

from sklearn.datasets import make_gaussian_quantiles

#用make_gaussian_quantiles生成多组多维正态分布的数据

#这里生成2维正态分布,设定样本数1000,协方差2

x1,y1=make_gaussian_quantiles(cov=2., n_samples=200, n_features=2, n_classes=2, shuffle=True, random_state=1)

#为了增加样本分布的复杂度,再生成一个数据分布

x2,y2=make_gaussian_quantiles(mean=(3,3), cov=1.5, n_samples=300, n_features=2, n_classes=2, shuffle=True, random_state=1)

#合并

X=np.vstack((x1,x2))

y=np.hstack((y1,1-y2))

#plt.scatter(X[:,0],X[:,1],c=Y)

#plt.show()

#设定弱分类器CART

weakClassifier=DecisionTreeClassifier(max_depth=1)

#构建模型。

clf=AdaBoostClassifier(base_estimator=weakClassifier,algorithm='SAMME',n_estimators=300,learning_rate=0.8)

clf.fit(X, y)

#绘制分类效果

x1_min=X[:,0].min()-1

x1_max=X[:,0].max()+1

x2_min=X[:,1].min()-1

x2_max=X[:,1].max()+1

x1_,x2_=np.meshgrid(np.arange(x1_min,x1_max,0.02),np.arange(x2_min,x2_max,0.02))

y_=clf.predict(np.c_[x1_.ravel(),x2_.ravel()])

y_=y_.reshape(x1_.shape)

plt.contourf(x1_,x2_,y_,cmap=plt.cm.Paired)

plt.scatter(X[:,0],X[:,1],c=y)

plt.show()
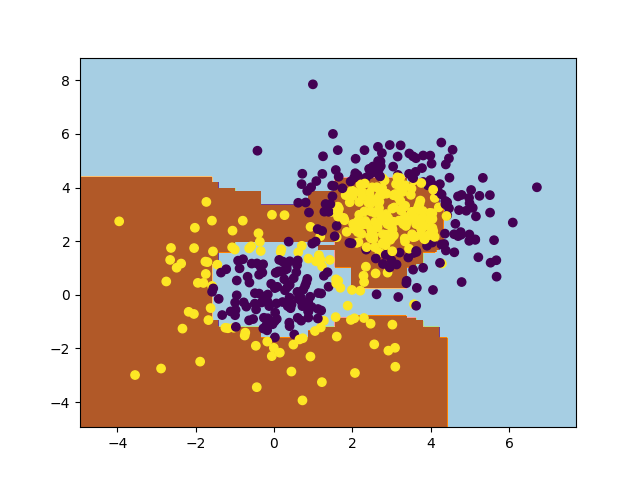
训练完成后的错误率大概是0.116。分类效果图如下:
作者 Scorpio.Lu
转载请注明出处!
代码实战之AdaBoost的更多相关文章
- Scala 深入浅出实战经典 第64讲:Scala中隐式对象代码实战详解
王家林亲授<DT大数据梦工厂>大数据实战视频 Scala 深入浅出实战经典(1-87讲)完整视频.PPT.代码下载:百度云盘:http://pan.baidu.com/s/1c0noOt6 ...
- Scala 深入浅出实战经典 第63讲:Scala中隐式类代码实战详解
王家林亲授<DT大数据梦工厂>大数据实战视频 Scala 深入浅出实战经典(1-87讲)完整视频.PPT.代码下载:百度云盘:http://pan.baidu.com/s/1c0noOt6 ...
- Scala 深入浅出实战经典 第52讲:Scala中路径依赖代码实战详解
王家林亲授<DT大数据梦工厂>大数据实战视频 Scala 深入浅出实战经典(1-64讲)完整视频.PPT.代码下载:百度云盘:http://pan.baidu.com/s/1c0noOt6 ...
- Scala 深入浅出实战经典 第51讲:Scala中链式调用风格的实现代码实战及其在Spark中应用
王家林亲授<DT大数据梦工厂>大数据实战视频 Scala 深入浅出实战经典(1-64讲)完整视频.PPT.代码下载:百度云盘:http://pan.baidu.com/s/1c0noOt6 ...
- Scala 深入浅出实战经典 第49课 Scala中Variance代码实战(协变)
王家林亲授<DT大数据梦工厂>大数据实战视频 Scala 深入浅出实战经典(1-64讲)完整视频.PPT.代码下载:百度云盘:http://pan.baidu.com/s/1c0noOt6 ...
- Scala 深入浅出实战经典 第48讲:Scala类型约束代码实战及其在Spark中的应用源码解析
王家林亲授<DT大数据梦工厂>大数据实战视频 Scala 深入浅出实战经典(1-64讲)完整视频.PPT.代码下载:百度云盘:http://pan.baidu.com/s/1c0noOt6 ...
- Scala 深入浅出实战经典 第47讲:Scala多重界定代码实战及其在Spark中的应用
王家林亲授<DT大数据梦工厂>大数据实战视频 Scala 深入浅出实战经典(1-64讲)完整视频.PPT.代码下载:百度云盘:http://pan.baidu.com/s/1c0noOt6 ...
- Scala 深入浅出实战经典 第40讲:Set、Map、TreeSet、TreeMap操作代码实战
王家林亲授<DT大数据梦工厂>大数据实战视频 Scala 深入浅出实战经典(1-64讲)完整视频.PPT.代码下载:百度云盘:http://pan.baidu.com/s/1c0noOt6 ...
- Scala 深入浅出实战经典 第39讲:ListBuffer、ArrayBuffer、Queue、Stack操作代码实战
王家林亲授<DT大数据梦工厂>大数据实战视频 Scala 深入浅出实战经典(1-64讲)完整视频.PPT.代码下载:百度云盘:http://pan.baidu.com/s/1c0noOt6 ...
随机推荐
- 读<架构漫谈>系列有感
读了这一系列博文,我对架构也有了大致的了解.在简单的阅读之后,我解决了几个问题. 第一个问题,什么是架构? 要学习架构,首先要知道架构.那么,什么是架构呢?引用<架构漫谈(一)>里的话就是 ...
- 微信开发-charles抓包
在微信开发过程中有一块不能使用开发者工具进行调试,需要查看请求的返回,故使用了charles抓包工具. 环境配置 1.http://www.charlesproxy.com/getssl/ 下载cha ...
- asp.net webform设计思路的思考
我使用asp.net的webform框架进行web应用程序的开发已经差不多四年了,在整个开发生涯中,也使用过一年asp.net的mvc框架.因为网上经常有讨论webform框架和mvc框架的优劣,所以 ...
- java 值传递 数组传递
在java中,不允许程序员选择值传递还是地址传递各个参数,基本类型总是按值传递.对于对象来说,是将对象的引用也就是副本传递给了方法,在方法中只有对对象进行修改才能影响该对象的值,操作对象的引用时是无法 ...
- BOM嵌套简单写法
WITHTREE AS( SELECT a.FItemID cfitemid,b.FItemID pfitemid FROM dbo.ICBOMChild a,dbo.ICBOM b WHERE a. ...
- MySQL在Read Uncommitted级别下写操作加X锁
很多文章认为MySQL在读未提交(Read Uncommitted)的隔离级别下,写操作是不加锁的,然而实际上并不是,在RU级别下,写操作加有X锁. 实践出真知 以前,我也认为RU隔离级别下,写操作不 ...
- Oracle数据库导入导出 imp/exp备份还原
Oracle数据导入导出imp/exp Oracle数据导入导出imp/exp 在cmd的dos命令提示符下执行,而不是在sqlplus里面,但是格式一定要类似于: imp/exp 用户名/密 ...
- List泛型集合
List和数组 相同点: 都可以控制元素类型 不同点: List的长度是可变的,所以list比数组更容易掌控 List属性 1.Count 获取集合中实际包含的元素个数 2.Capcity 集合中可以 ...
- BZOJ2199[Usaco2011 Jan]奶牛议会——2-SAT+tarjan缩点
题目描述 由于对Farmer John的领导感到极其不悦,奶牛们退出了农场,组建了奶牛议会.议会以“每头牛 都可以获得自己想要的”为原则,建立了下面的投票系统: M只到场的奶牛 (1 <= M ...
- BZOJ1131[POI2008]Sta——树形DP
题目描述 给出一个N个点的树,找出一个点来,以这个点为根的树时,所有点的深度之和最大 输入 给出一个数字N,代表有N个点.N<=1000000 下面N-1条边. 输出 输出你所找到的点,如果具有 ...