
[转帖]可直接拿来用的kafka+prometheus+grafana监控告警配置
kafka配置jmx_exporter
点击:https://github.com/prometheus/jmx_exporter,选择下面的jar包下载:
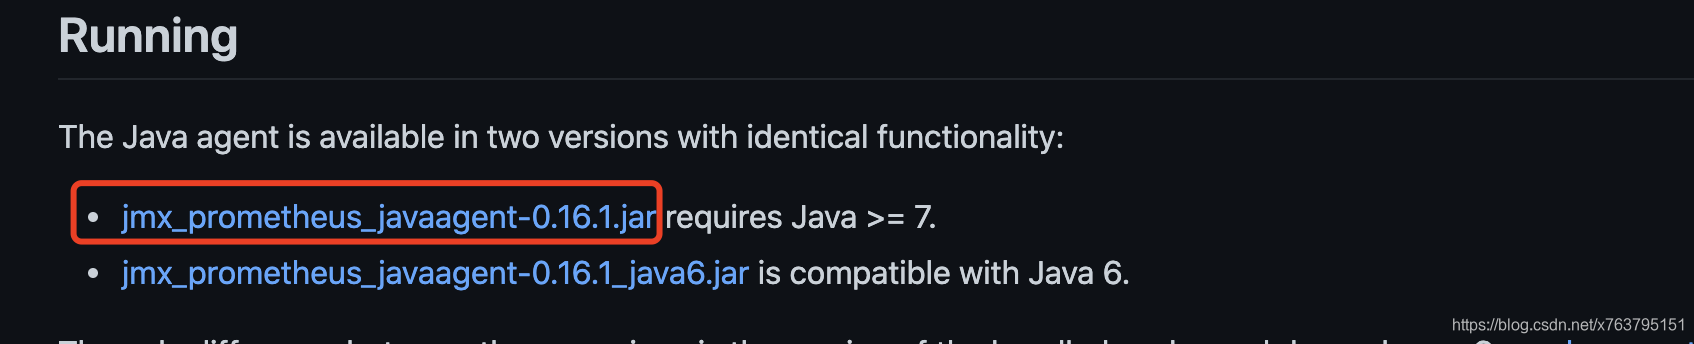
将下载好的这个agent jar包上传到kafka的broker节点所在服务器上,每个broker都需要,比如上传到如下路径:
/opt/agent/jmx_prometheus_javaagent-0.16.1.jar
修改kafka启动脚本: bin/kafka-server-start.sh,增加java agent配置如下:
-
JMX_EXPORTER_OPTS="-javaagent:/opt/agent/jmx_prometheus_javaagent-0.16.1.jar=9095:/opt/agent/kafka_broker.yml"
-
export KAFKA_JMX_OPTS="$KAFKA_JMX_OPTS $JMX_EXPORTER_OPTS"
这两行代码可以添加在脚本首部。
这里指定了9095作为端口,jmx_exporter用到的kafka_broker.yml 配置如下:https://github.com/xxd763795151/kafka-exporter/blob/main/kafka_broker.yml
将kafka每个broker都这样配置,重启kafka。
Prometheus配置
修改prometheus的配置prometheus.yml,增加如下配置:
-
- job_name: 'kafka'
-
metrics_path: /metrics
-
static_configs:
-
- targets: ['kafka1:9095', 'kafka2:9095', 'kafka3:9095']
-
labels:
-
env: "test"
p.s. 注意job_name不要修改,值就是"kafka",要不我下面的grafana不能直接用,还需要每个面板依次修改。
Grafana配置
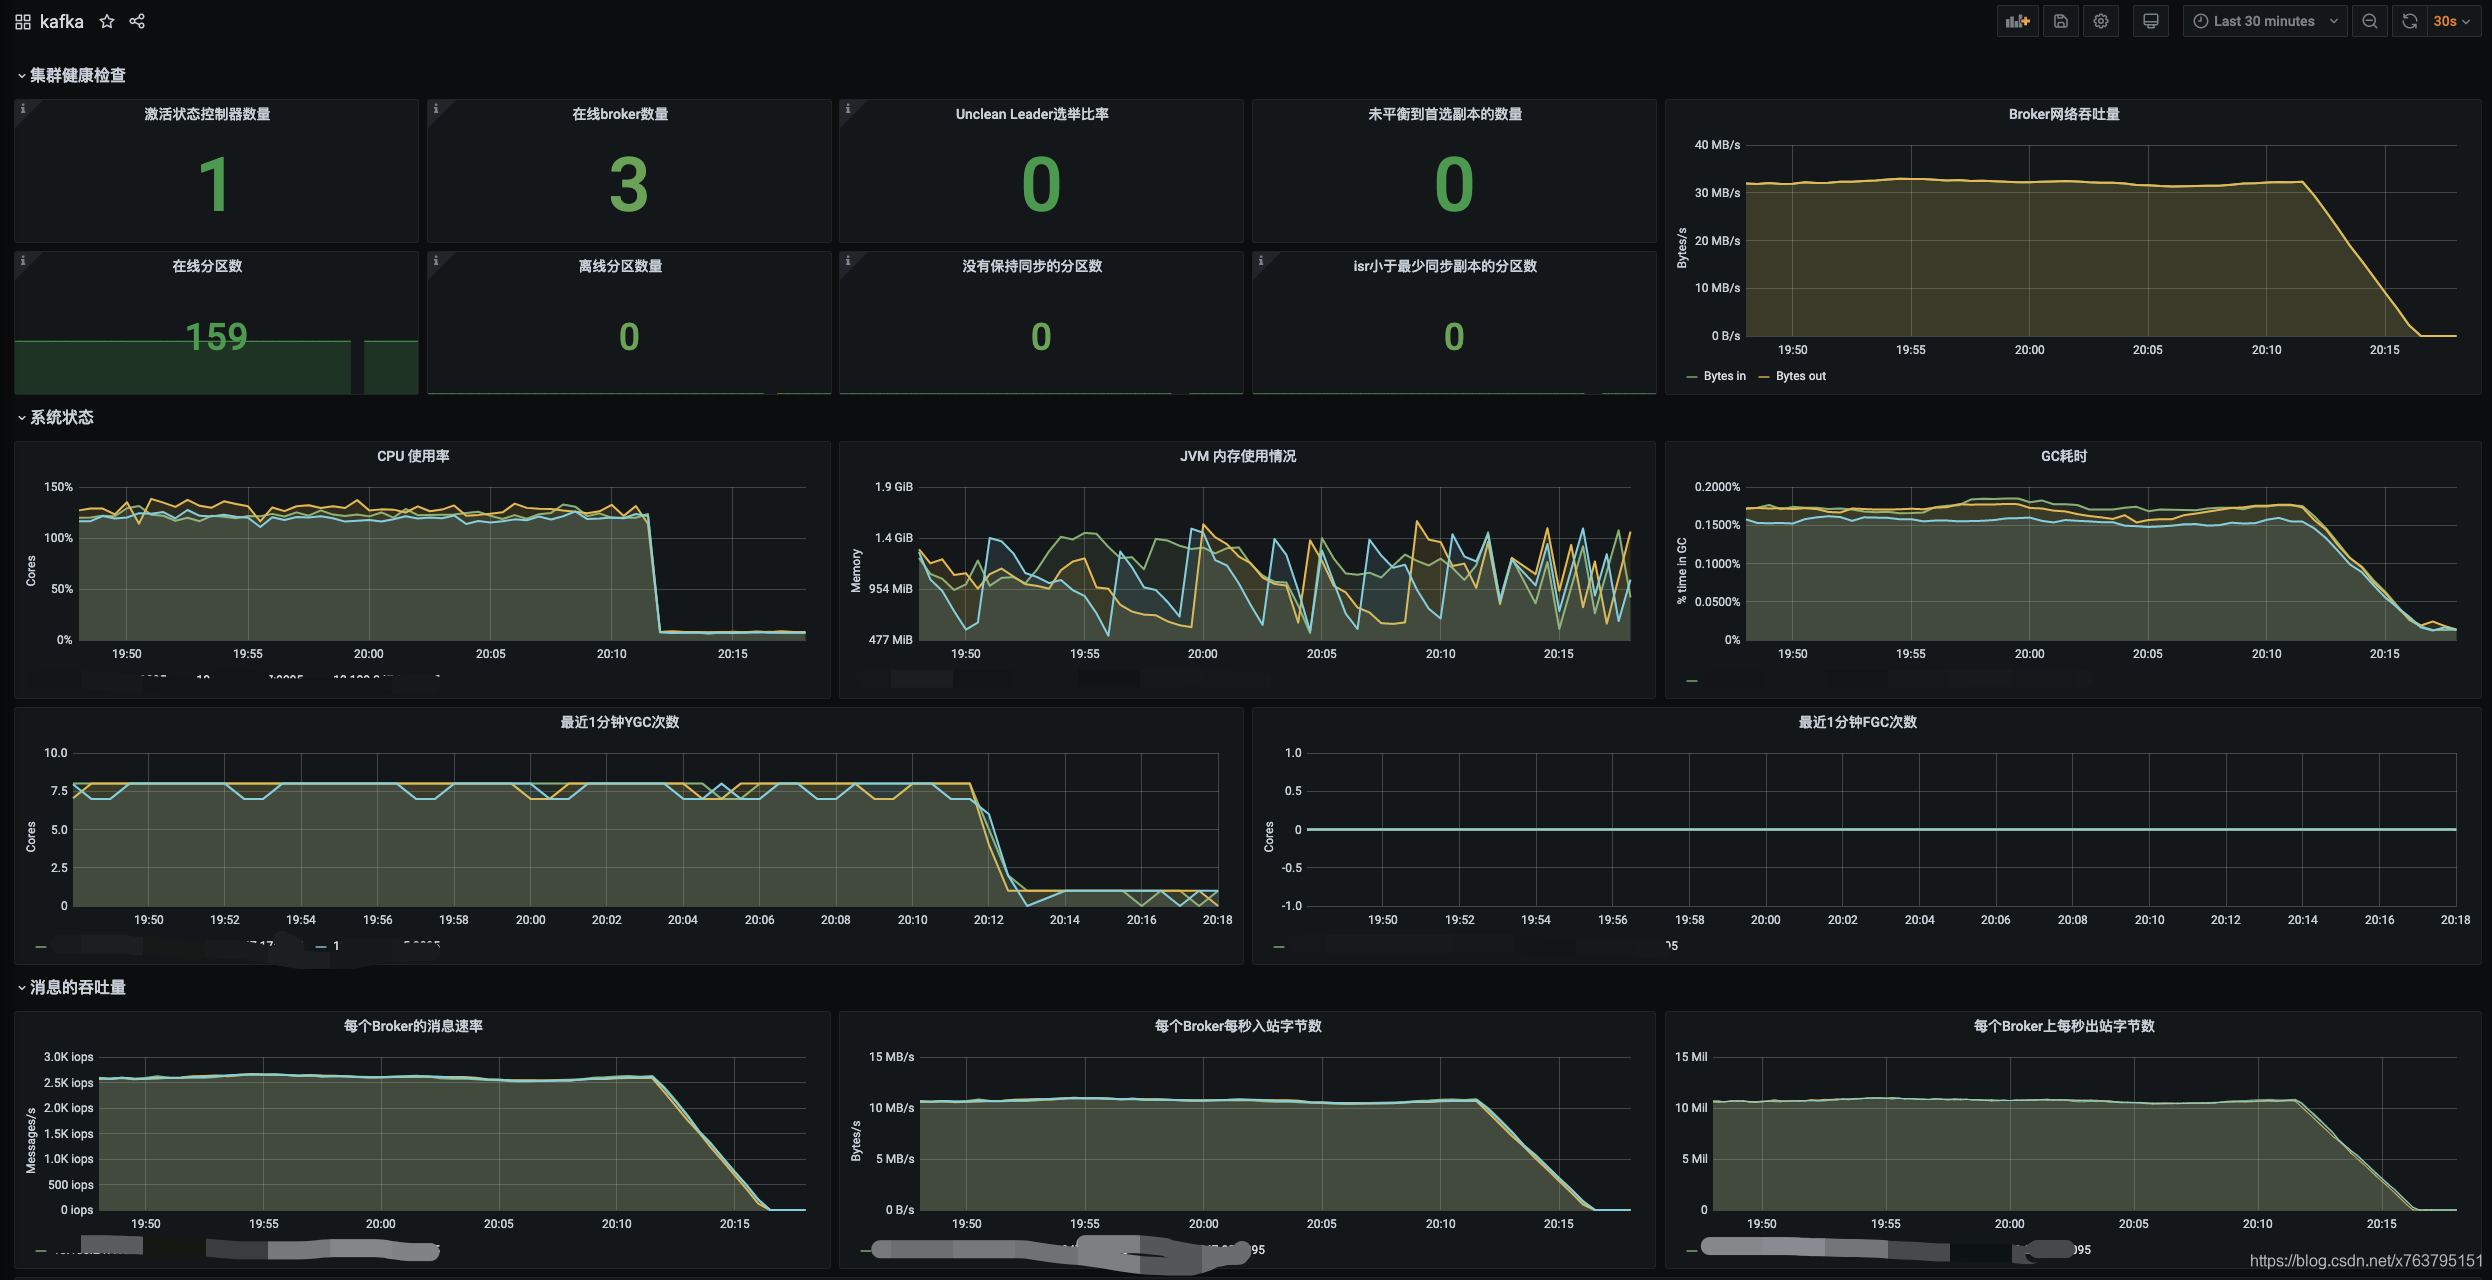
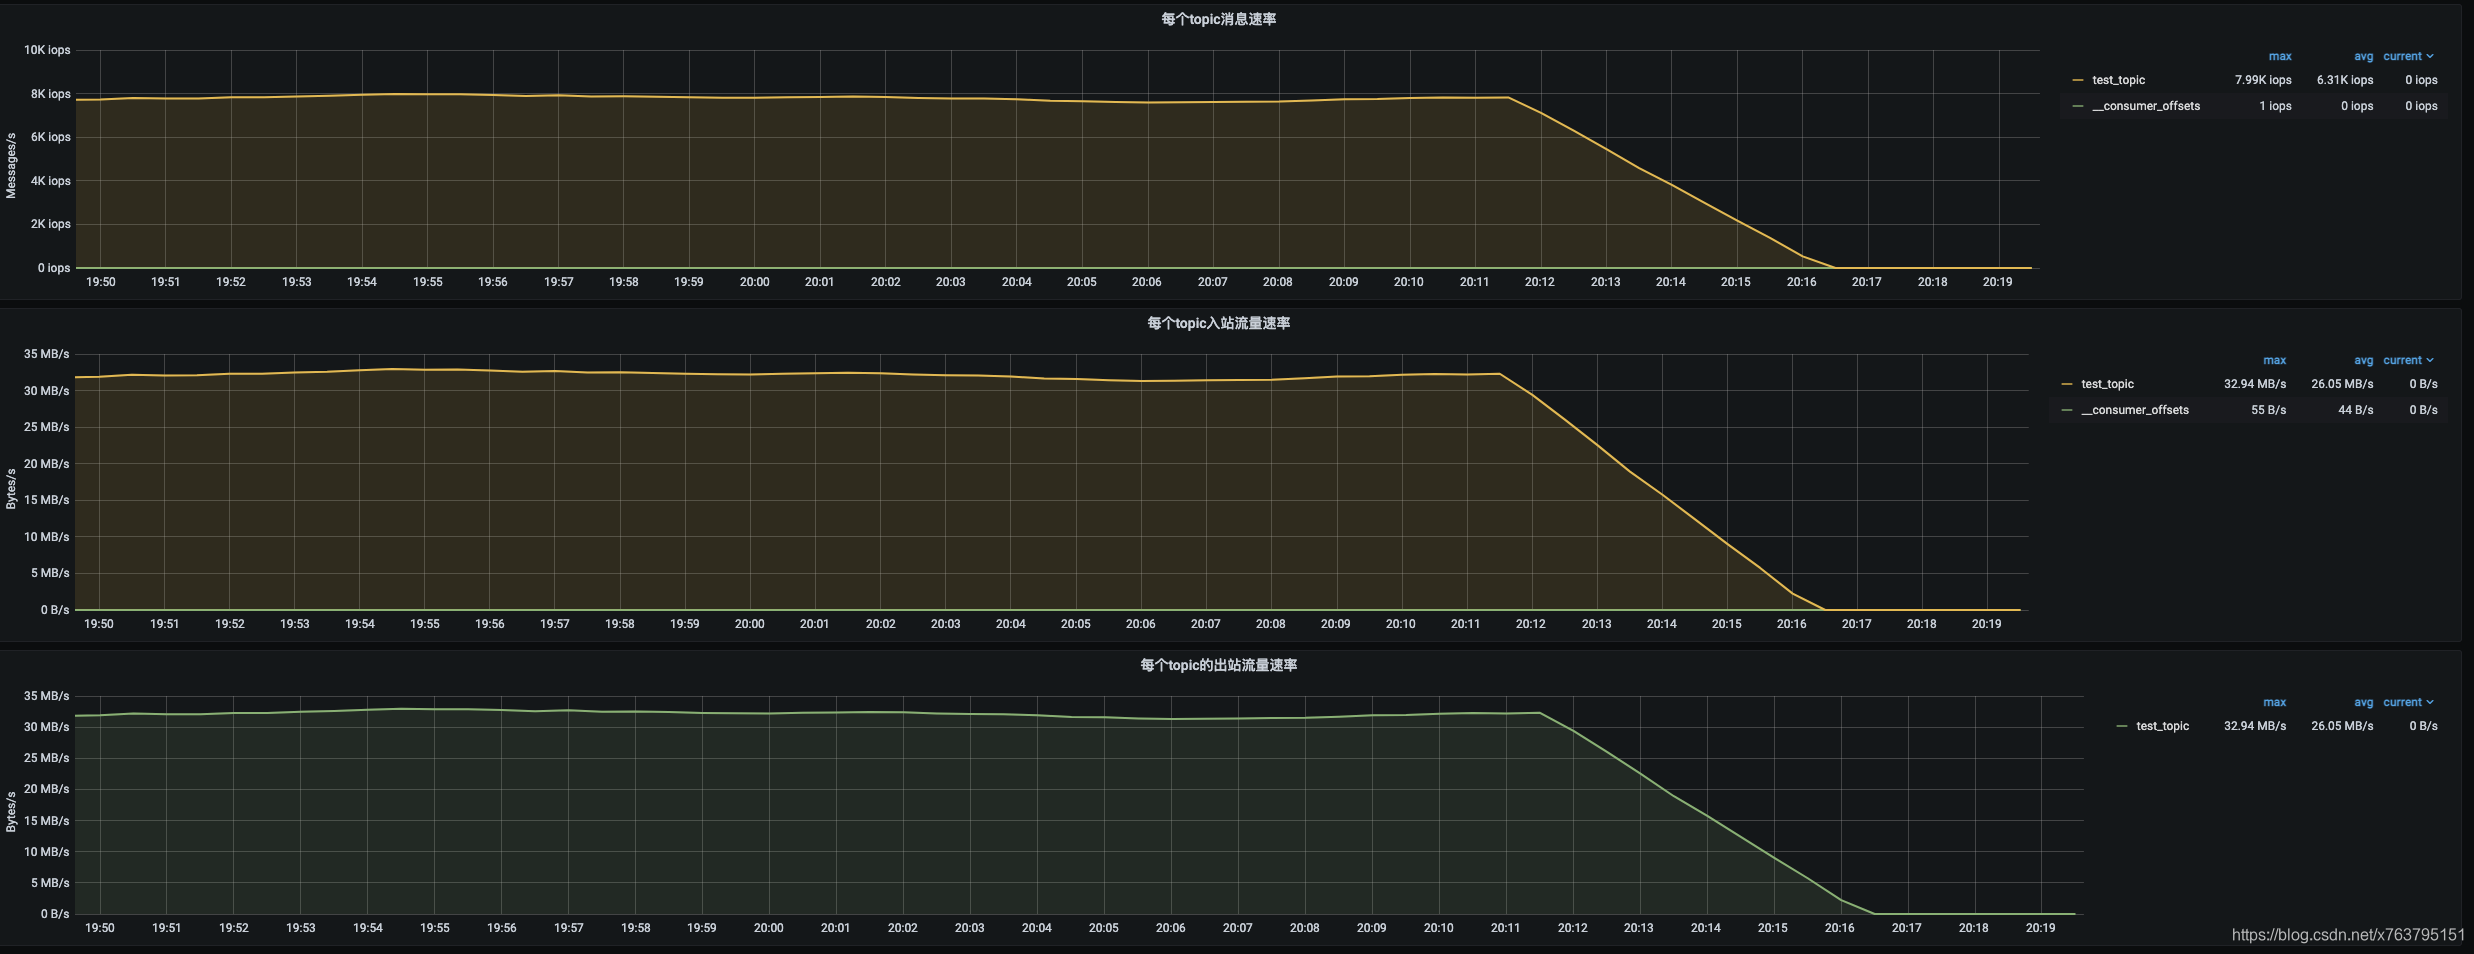
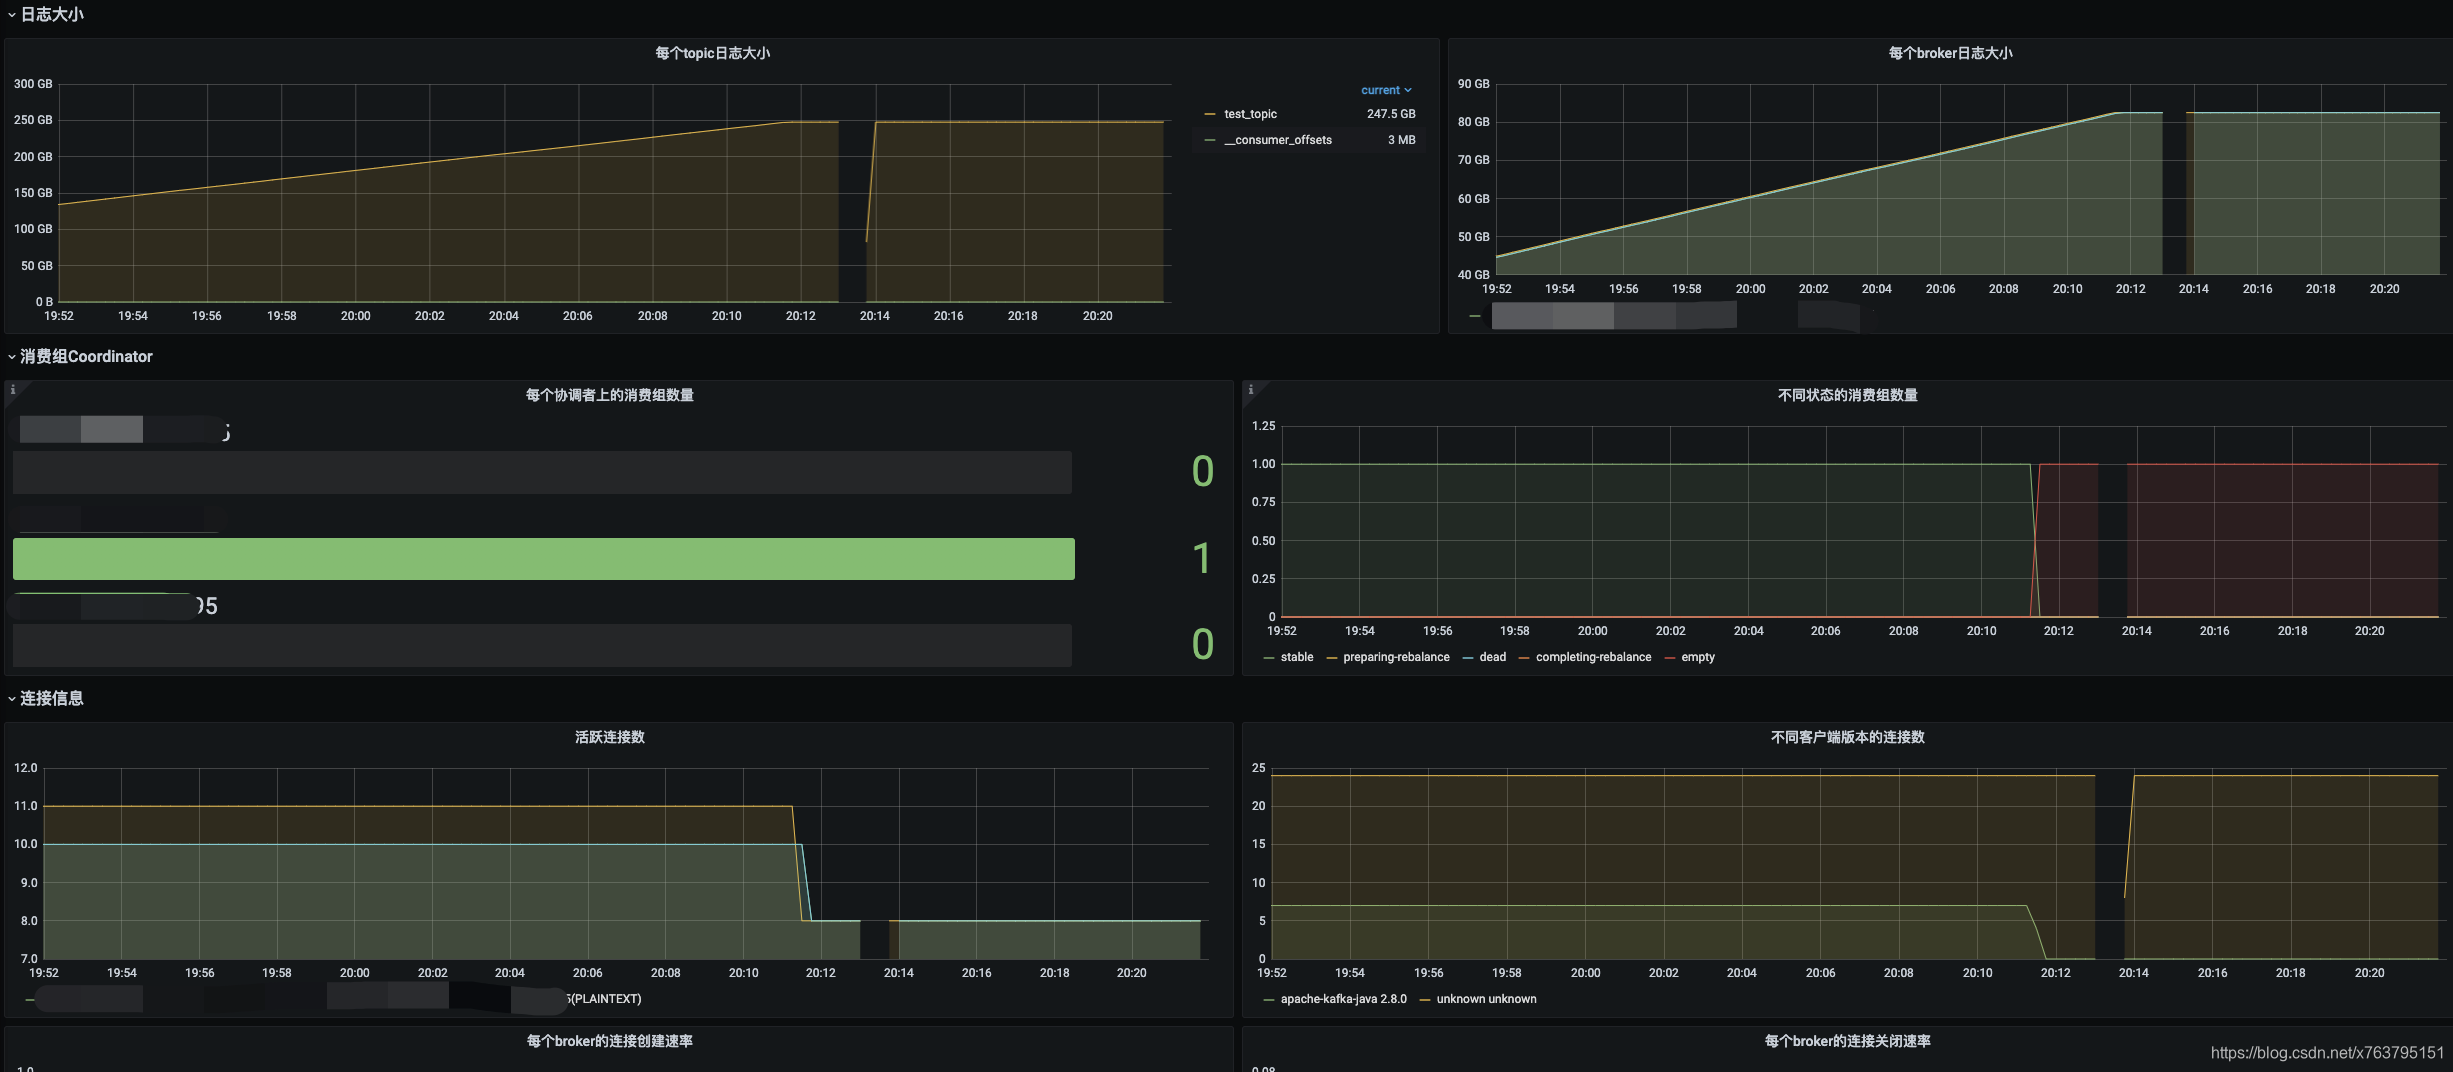
下面的Grafana面板我已经配置好,可以直接拿来用,之后可以根据需要增加或删除相关面板:https://github.com/xxd763795151/kafka-exporter/blob/main/grafana.json
贴几个截图:

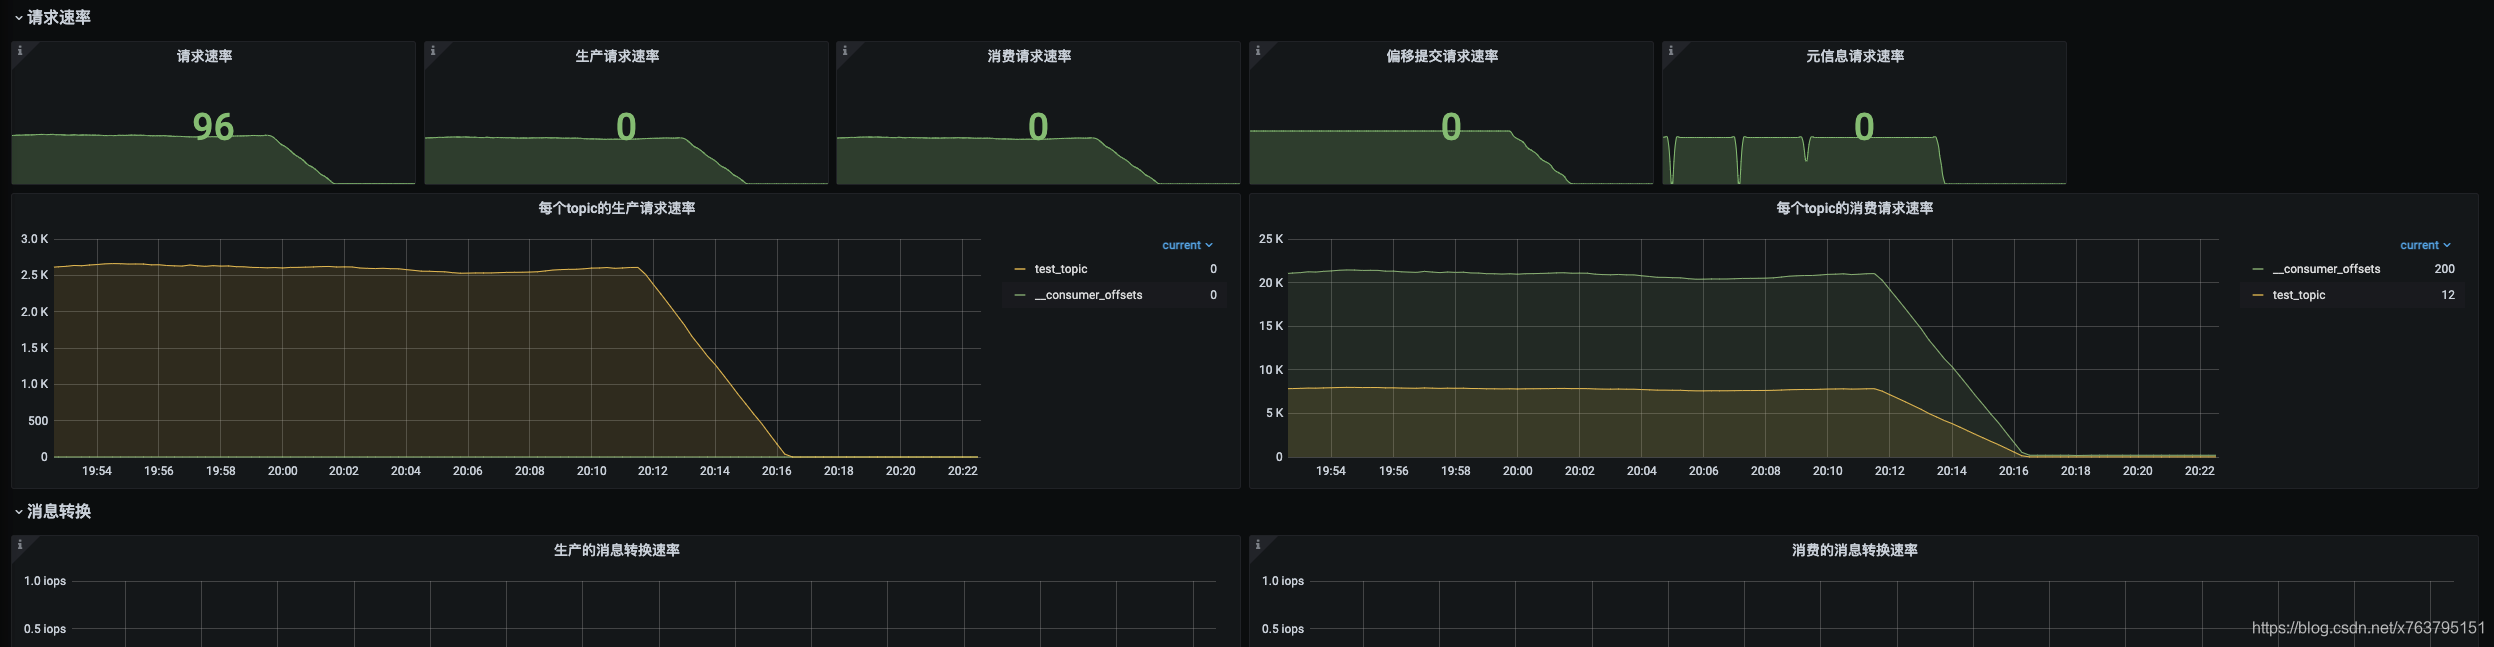
消息积压
在kafka的broker端无法直接获取消息积压等指标信息,这些数据在消费端上,我们也不太可能去连接所有的消费端获取监控信息。
所以,我单独写了一个kafka-exporter可以获取消息积压的监控指标:https://github.com/xxd763795151/kafka-exporter
点击这个链接进入github仓库后,根据说明进行部署并配置启动后,然后在prometheus.yml增加如下配置:
-
- job_name: 'kafka-exporter'
-
metrics_path: /prometheus
-
static_configs:
-
- targets: ['kafka-expoter-host:9097']
-
labels:
-
env: "test"
上面的grafana配置里已经包含了消息积压的面板:
 如果后续有其它指标在jmx里不提供,也可以继续补充kafka-exporter,刮取更多需要的metrics。
告警
最新的配置代码会提交在这里: https://github.com/xxd763795151/kafka-exporter/blob/main/kafka_alert.yml
示例如下:

末语
我从grafana 官方上搜索了几个dashboard,但指标实在太少。感谢从这篇博文里找到的grafana配置可以参考,提供了很多指标的面板,可以让我对着kafka官方监控jmx说明进行整理,让我在grafana面板的配置上,省了一半的功夫:
https://www.confluent.io/blog/monitor-kafka-clusters-with-prometheus-grafana-and-confluent/
[转帖]可直接拿来用的kafka+prometheus+grafana监控告警配置的更多相关文章
- [转帖]Prometheus+Grafana监控Kubernetes
原博客的位置: https://blog.csdn.net/shenhonglei1234/article/details/80503353 感谢原作者 这里记录一下自己试验过程中遇到的问题: . 自 ...
- [转帖]安装prometheus+grafana监控mysql redis kubernetes等
安装prometheus+grafana监控mysql redis kubernetes等 https://www.cnblogs.com/sfnz/p/6566951.html plug 的模式进行 ...
- [转帖]插曲:大白话带你认识Kafka
插曲:大白话带你认识Kafka 2019-11-18 21:58:27 从事Java 阅读数 2更多 分类专栏: java Kafaka 版权声明:本文为博主原创文章,遵循CC 4.0 BY-SA ...
- [转帖]基于docker 搭建Prometheus+Grafana
基于docker 搭建Prometheus+Grafana https://www.cnblogs.com/xiao987334176/p/9930517.html need good study 一 ...
- [转帖]Linux网络管理员不得不了解的系统目录/proc/sys/net/(网络配置)
Linux网络管理员不得不了解的系统目录/proc/sys/net/(网络配置) https://blog.csdn.net/u013485792/article/details/76416836 需 ...
- [ZZ] [精彩盘点] TesterHome 社区 2018年 度精华帖
原文地址: https://testerhome.com/topics/17646 相逢即是缘分,总有一篇适合您! 感觉好的请点赞收藏 ,感觉分类不严谨的,欢迎反馈给我! 测试方法&测试管理 ...
- 《转》Spring4 Freemarker框架搭建学习
这里原帖地址:http://www.cnblogs.com/porcoGT/p/4537064.html 完整配置springmvc4,最终视图选择的是html,非静态文件. 最近自己配置spring ...
- Windows 7 封装与定制不完全教程
Windows 7 封装与定制不完全教程 从定制Win7母盘到封装详细教程 手把手教你定制WIN7小母盘 Windows 7 封装与定制不完全教程 [教程] Windows 7 封装与定制不完全教程( ...
- Open Source
资源来源于http://www.cnblogs.com/Leo_wl/category/246424.html RabbitMQ 安装与使用 摘要: RabbitMQ 安装与使用 前言 吃多了拉就是队 ...
- 你都用python来做什么?
首页发现话题 提问 你都用 Python 来做什么? 关注问题写回答 编程语言 Python 编程 Python 入门 Python 开发 你都用 Python 来做什么? 发现很 ...
随机推荐
- BlockCanary原理解析
一.背景 为了解决应卡顿,分析耗时. 二.原理 Looper中的loop方法: public static void loop() { ... for (;;) { ... // This must ...
- Altas&Ranger快速入门
Altas&Ranger快速入门 一.元数据 企业内部远行多种类型的数据库,有关系型数据库.非关系型数据库.图数据库.时序数据库等,常见有mysql.redis.Mongodb.oracle. ...
- 初识GaussDB(for Cassandra)
摘要:GaussDB(for Cassandra)是一款基于华为自主研发的计算存储分离架构的分布式云数据库服务. "local quorum查询某个分区键的条数,每次查询,条数都不一样.&q ...
- 解读知识蒸馏模型TinyBert
摘要:本篇文章的重点在于改进信息瓶颈的优化机制,并且围绕着高纬空间中互信息难以估计,以及信息瓶颈优化机制中的权衡难题这两个点进行讲解. 本文分享自华为云社区<[云驻共创]美文赏析:大佬对变分蒸馏 ...
- 火山引擎 ByteHouse 与白鲸开源完成兼容性认证,加速数据价值释放
更多技术交流.求职机会,欢迎关注字节跳动数据平台微信公众号,回复[1]进入官方交流群 数据作为新型生产要素,已快速融入生产.分配.流通.消费和社会服务管理等各环节,深刻改变着生产方式.生活方式和治理方 ...
- 火山引擎DataLeap数据质量解决方案和最佳实践(二):解决方案
更多技术交流.求职机会,欢迎关注字节跳动数据平台微信公众号,回复[1]进入官方交流群 DataLeap流批数据质量解决方案 产品功能架构 火山引擎DataLeap流批数据质量解决方案有 4 个大的功能 ...
- 火山引擎 DataLeap:3 小时分享,体系化讲透企业数据治理如何做?
更多技术交流.求职机会,欢迎关注字节跳动数据平台微信公众号,回复[1]进入官方交流群 数据治理伴随着数据全生命周期的进程,涉及事前规范检查.事中监控管理.事后优化复盘等过程,关键重点领域包括数据质量的 ...
- MyBatis Mapper.XML 标签使用说明
直接将值返回给对象 <select id="list" resultType="com.vipsoft.base.entity.UserInfo"> ...
- 轻松导航:教你在Excel中添加超链接功能
前言 超链接是指在网页或电子文档中常见的元素,它的主要作用是将一个文本或图像与另一网页.文件或资源链接起来,从而使用户能够通过点击该链接跳转到目标资源.超链接可以起到导航以及引用的作用.超链接通常有以 ...
- 阿里云云通信作为 CPaaS 全球代表服务商,上榜 Gartner 报告
近日,国际知名研究机构Gartner发布2022年<CPaaS市场指南(Market Guide for Communications Platform as a Service, 2022)& ...