
seq2seq(1)- EncoderDecoder架构
零
seq2seq是从序列到序列的学习过程,最重要的是输入序列和输出序列是可变长的,这种方式就非常灵活了,典型的机器翻译就是这样一个过程。
一
最基本的seq2seq网络架构如下所示:
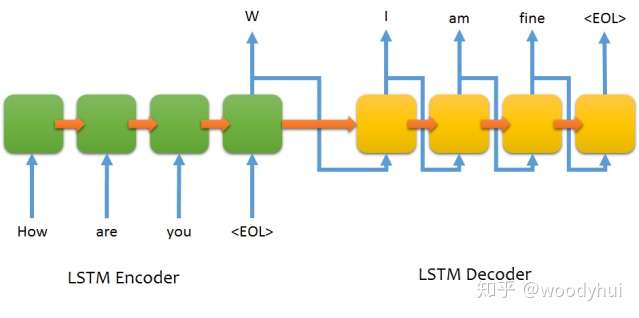
可以看到,encoder构成一个RNN的网络,decoder也是一个RNN的网络。训练过程和推断过程有一些不太一样的地方,介绍如下。
训练过程:
- encoder构成一个RNN网络,输入为源语言的文本,输出最后一个timestep的hidden state,同时不需要output,将最后一个hidden state作为decoder的初始化state;
- decoder也构成一个RNN网络,输入为目标语言的文本,这个地方要注意的是输入需要往后lag一个位置,输出就是正常的目标语言文本即可,选用categorical cross entropy进行多分类训练。
# input sentence

How are you

# output sentence

I am fine

# encoder input

["How", "are", "you"]

# decoder input

["<start tag>", "I", "am", "fine"]

# decoder target

["I", "am", "fine", "<end tag>"]
推断过程:
推断过程只有encoder input了,所以有个greedy/sampling/beam-search等decoding的方法,下面讨论最简单的greedy方法。
- 将源语言的输入经过encoder编码成最后timestep的hidden state;
- 目标语言的输入设定成一个单词<start tag>,喂给decoder,产出一个目标单词;
- 将上一步的目标的单词作为目标语言新的输入,继续2的步骤,直到遇到<end tag>,或者产生的预测sequence长度超过阈值。
二
以上就是最基本的seq2seq架构,优点就是简单,缺点也很明显,我们人类一般翻译文本的时候,目标语言单词往往只和源语言文本其中有限一两个单词有关,而上面的做法,将源语言文本编码成一个固定长度的hidden state,导致decoder过程中每个单词都是受固定state的影响,而没有差异化和重点,由此下一篇会介绍seq2seq优化的比较重要的一个机制 - Attention Mechanism。
seq2seq(1)- EncoderDecoder架构的更多相关文章
- 6. 从Encoder-Decoder(Seq2Seq)理解Attention的本质
1. 语言模型 2. Attention Is All You Need(Transformer)算法原理解析 3. ELMo算法原理解析 4. OpenAI GPT算法原理解析 5. BERT算法原 ...
- 深度学习的seq2seq模型——本质是LSTM,训练过程是使得所有样本的p(y1,...,yT‘|x1,...,xT)概率之和最大
from:https://baijiahao.baidu.com/s?id=1584177164196579663&wfr=spider&for=pc seq2seq模型是以编码(En ...
- RNN/LSTM/GRU/seq2seq公式推导
概括:RNN 适用于处理序列数据用于预测,但却受到短时记忆的制约.LSTM 和 GRU 采用门结构来克服短时记忆的影响.门结构可以调节流经序列链的信息流.LSTM 和 GRU 被广泛地应用到语音识别. ...
- seq2seq和attention应用到文档自动摘要
一.摘要种类 抽取式摘要 直接从原文中抽取一些句子组成摘要.本质上就是个排序问题,给每个句子打分,将高分句子摘出来,再做一些去冗余(方法是MMR)等.这种方式应用最广泛,因为比较简单.经典方法有Lex ...
- seq2seq模型以及其tensorflow的简化代码实现
本文内容: 什么是seq2seq模型 Encoder-Decoder结构 常用的四种结构 带attention的seq2seq 模型的输出 seq2seq简单序列生成实现代码 一.什么是seq2seq ...
- NMT 机器翻译
本文近期学习NMT相关知识,学习大佬资料,汇总便于后期复习用,有问题,欢迎斧正. 目录 RNN Seq2Seq Attention Seq2Seq + Attention Transformer Tr ...
- TACOTRON:端到端的语音合成
tacotron主要是将文本转化为语音,采用的结构为基于encoder-decoder的Seq2Seq的结构.其中还引入了注意机制(attention mechanism).在对模型的结构进行介绍之前 ...
- CNN卷积神经网络的改进(15年最新paper)
回归正题,今天要跟大家分享的是一些 Convolutional Neural Networks(CNN)的工作. 大家都知道,CNN 最早提出时,是以一定的人眼生理结构为基础,然后逐渐定下来了一些经典 ...
- Google工程师亲授 Tensorflow2.0-入门到进阶
第1章 Tensorfow简介与环境搭建 本门课程的入门章节,简要介绍了tensorflow是什么,详细介绍了Tensorflow历史版本变迁以及tensorflow的架构和强大特性.并在Tensor ...
随机推荐
- [OS][FS]查看ext3文件系统分区的superblock
本文将介绍怎样读取一个分区的superblock: 1. 首先我们查看一下在磁盘上有哪些分区,通过fdisk -l 这里有三个分区,我们下面查看/dev/sda3(这是一个device file) 2 ...
- 使用x-template 定义模板
demo <script type="text/x-template" id="myFirstScriptComponent"> <p> ...
- 【position】
background-position 定位的position的区别 background-position 相对的位置是(容器的宽度-子元素的宽度) 当子元素的宽度大于容器的宽度 backgroun ...
- (转)Sql Server 保留几位小数的两种做法
原文地址:http://blog.csdn.net/skyandcode/article/details/23523815 问题: 数据库里的 float momey 类型,都会精确到多位小数.但有时 ...
- POJ3233:Matrix Power Series(矩阵快速幂+递推式)
传送门 题意 给出n,m,k,求 \[\sum_{i=1}^kA^i\] A是矩阵 分析 我们首先会想到等比公式,然后得到这样一个式子: \[\frac{A^{k+1}-E}{A-E}\] 发现要用矩 ...
- 洛谷 P2593 [ZJOI2006]超级麻将【dp】
设f[i][j][k][0/1]表示选到i时,i-1选j张,i选k张,之前选的所有牌是否选择了对子 然后分情况讨论转移即可 #include<iostream> #include<c ...
- bzoj 1444: [Jsoi2009]有趣的游戏【AC自动机+dp+高斯消元】
https://blog.sengxian.com/solutions/bzoj-1444 orz 一直是我想错了,建出AC自动机之后,实际上这个定义是设f[i]为经过i节点的 * 期望次数 * ,因 ...
- bzoj 3714: [PA2014]Kuglarz【最小生成树】
参考:https://blog.csdn.net/aarongzk/article/details/48883741 没想到吧.jpg 来自题解: "如果用sum[i]表示前i个杯子底球的总 ...
- [App Store Connect帮助]八、维护您的 App(5)生成产品报告
您可以生成产品报告,详细介绍您所在机构中 App 目录的信息和设置,包括 App 内购买项目,以及 Game Center排行榜和成就的元数据. 首先您以不同类型请求产品报告,之后您会收到一封电子邮件 ...
- IE兼容之中文汉字请求乱码-network
IE兼容之中文汉字请求乱码 IE控制台报错: IE网络报错: 解决方法: encodeURI('--- @ -- 子卿 -'); // "---%20@%20--%20%E5%AD%90%E ...