
python序列化_json,pickle,shelve模块
序列化
序列化是指把内存里的数据类型转变成字符串,以使其能存储到硬盘或通过网络传输到远程,因为硬盘或网络传输时只能接受bytes
- 把内存数据 转成字符,叫序列化
- 把字符 转成内存数据,叫反序列化
模块 json
json.dumps() 序列化一个对象
import json

data = {

    'roles':[

        {'role':'monster','type':'pig','life':50},

        {'role':'hero','type':'关羽','life':80},

    ]

}

d = json.dumps(data) #转成字符串

print(type(d))

print(d)
打印结果:
<class 'str'>

{"roles": [{"role": "monster", "type": "pig", "life": 50}, {"role": "hero", "type": "\u5173\u7fbd", "life": 80}]}
json.lodads() 从一个对象加载数据
import json

data = {

    'roles':[

        {'role':'monster','type':'pig','life':50},

        {'role':'hero','type':'关羽','life':80},

    ]

}

d = json.dumps(data) #仅转成字符串

d2 = json.loads(d)

print(type(d2),d2)

#<class 'dict'>

#{'roles': [{'role': 'monster', 'type': 'pig', 'life': 50}, {'role': 'hero', 'type': '关羽', 'life': 80}]}
json.dump() 将一个对象序列化存入文件
import json

data = {

    'roles':[

        {'role':'monster','type':'pig','life':50},

        {'role':'hero','type':'关羽','life':80},

    ]

}

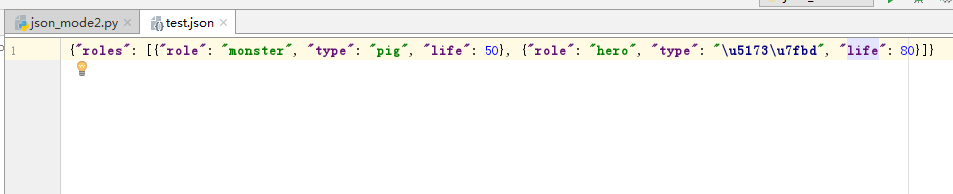
f = open('test.json',mode='w')

json.dump(data, f) #转成字符并写入文件
结果:会将 data中的数据写入文件
json.load() 从一个打开的文件句柄加载数据
import json

f = open('test.json','r')

data = json.load(f)

print(data['roles'])
打印:
[{'role': 'monster', 'type': 'pig', 'life': 50}, {'role': 'hero', 'type': '关羽', 'life': 80}]
import json

f = open('json_file.json','w',encoding='utf-8')

data1 = {'name':'nurato','skill':'螺旋丸'}

data2 = [1,2,3,'sunshine']

json.dump(data1, f)

json.dump(data2, f)
结果:
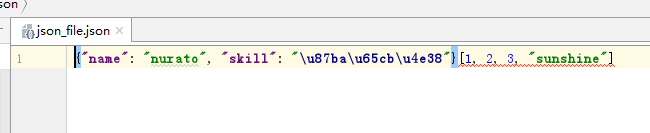
说明: 可以dump多次数据并写入文件
我们现在json.load 一下
f = open('json_file.json','r',encoding='utf-8')

json.load(f)

# 程序报错:json.decoder.JSONDecodeError
只load 一次,并且json格式有问题,会报错
------------------------------------------------分割线------------------------------------------------
模块pickle
import pickle

data1 = {'name':'nurato','skill':'螺旋丸'}

f = open('data.pkl','wb')

pickle.dump(data1,f)
结果:创建了一个 名为 data.pkl 的文件
import pickle

f = open('data.pkl','rb')

d = pickle.load(f)

print(type(d))

print(d)

#<class 'dict'>

#{'name': 'nurato', 'skill': '螺旋丸'}
关于json 和 pickle
JSON:
优点:跨语言、体积小
缺点:只能支持int\str\list\tuple\dict
Pickle:
优点:专为python设计,支持python所有的数据类型
缺点:只能在python中使用,存储数据占空间大
---------------------------------------分割线-------------------------------------------
序列化 shelve 模块
import shelve

f = shelve.open('shelve_test') #打开一个文件

names = ['python', 'html', 'java']

info = {'name': 'jack', 'age': 25}

f['names'] = names

f['info_dic'] = info

f.close()
结果:会创建 shelve_test 文件
import shelve

f = shelve.open('shelve_test') #打开一个文件

print(list(f.keys()))  #['names', 'info_dic']

print(list(f.items())) #[('names', ['python', 'html', 'java']), ('info_dic', {'name': 'jack', 'age': 25})]

print(f.get('names')) #['python', 'html', 'java']

print(f.get('info_dic')) #{'name': 'jack', 'age': 25}
增加内容:
import shelve

f = shelve.open('shelve_test') #打开一个文件

f['book'] = [1,2,3,4,5] #增加内容

f.close()

f2 = shelve.open('shelve_test')

print(list(f2.keys()))  # ['names', 'info_dic', 'book']

print(f2['book'])
我们来修改一下内容:(只能通过 f['book'] = [1,2,'肖申克的救赎',4,5]) 这样的方式重新赋值来更改
f['book'][0] = 'new book' 这样的方式是不可以的。
import shelve

f = shelve.open('shelve_test')  # 打开一个文件

f['book'] = [1,2,'肖申克的救赎',4,5]

f.close()

f2 = shelve.open('shelve_test')

print(f2['book'])  # [1, 2, '肖申克的救赎', 4, 5]
删除内容:
import shelve

f = shelve.open('shelve_test') #打开一个文件

del f['book']

f.close()

f2 = shelve.open('shelve_test')

print(list(f2.items()))

# 打印 : [('names', ['python', 'html', 'java']), ('info_dic', {'name': 'jack', 'age': 25})]
python序列化_json,pickle,shelve模块的更多相关文章
- Python(序列化json,pickle,shelve)
序列化 参考:https://www.cnblogs.com/yuanchenqi/articles/5732581.html # dic = str({'1':'111'}) # # f = ope ...
- python序列化: json & pickle & shelve 模块
一.json & pickle & shelve 模块 json,用于字符串 和 python数据类型间进行转换pickle,用于python特有的类型 和 python的数据类型间进 ...
- python 常用模块 time random os模块 sys模块 json & pickle shelve模块 xml模块 configparser hashlib subprocess logging re正则
python 常用模块 time random os模块 sys模块 json & pickle shelve模块 xml模块 configparser hashlib subprocess ...
- day6_python序列化之 json & pickle & shelve 模块
一.json & pickle & shelve 模块 json,用于字符串 和 python数据类型间进行转换pickle,用于python特有的类型 和 python的数据类型间进 ...
- Python全栈之路----常用模块----序列化(json&pickle&shelve)模块详解
把内存数据转成字符,叫序列化:把字符转成内存数据类型,叫反序列化. Json模块 Json模块提供了四个功能:序列化:dumps.dump:反序列化:loads.load. import json d ...
- Day 21 序列化模块_Json,Pickle,Shelve
序列化 , 数据类型,列表 元组, 字符串 只有字符串能被写入文件中. 能在网络上传输的只能是bytes - 字符串 把要传输的和要存储的内容转换成字符串. 字符串 转换回 要传输和存储的内容 序列化 ...
- Python序列化,json&pickle&shelve模块
1. 序列化说明 序列化可将非字符串的数据类型的数据进行存档,如字典.列表甚至是函数等等 反序列化,将通过序列化保存的文件内容反序列化即可得到数据原本的样子,可直接使用 2. Python中常用的序列 ...
- 12 python json&pickle&shelve模块
1.什么叫序列化 序列化是指把内存里的数据类型转变成字符串,以使其能存储到硬盘或通过网络传输到远程,因为硬盘或网络传输时只能接受bytes(字节) 2.用于序列化的两个模块,json和pickle ...
- Python学习 :json、pickle&shelve 模块
数据交换格式 json 模块 json (JavaScript Object Notation)是一种轻量级的数据交换语言,以文字为基础,且易于让人阅读.尽管 json 是JavaScript的一个子 ...
随机推荐
- FZU 2122 ——又见LKity——————【KMP字符串匹配】
Problem 2122 又见LKity Accept: 413 Submit: 1425Time Limit: 1000 mSec Memory Limit : 32768 KB Pr ...
- nyoj 139——我排第几个|| nyoj 143——第几是谁? 康托展开与逆康托展开
讲解康托展开与逆康托展开.http://wenku.baidu.com/view/55ebccee4afe04a1b071deaf.html #include<bits/stdc++.h> ...
- Java Web SpringMVC AJAX,实现页面懒加载数据
因为做的微信端的网页,所以在显示后台数据的时候,要么分页,要么全部加载数据,开始分页对于用户来说,其实体验不是很好,毕竟要去不断的点击下一页,但是如果我把全部数据读取出来的话,但用户可能也就看前面几条 ...
- webbrowser使用已过期资源的一个报错
如果webbrowser控件已更新,仍使用一个HtmlElement就会出现以下错误: 2013-12-23 17:33:48,375 [18] ERROR xx.xxx<Run>b__0 ...
- C# 使用cookie实现登录
首先,我们需要做的是什么? 我们成功登录之后,跳转到主界面,然后主界面的登录按钮变成头像啥的.下一次打开网页就要判断有没有登录过,有cookie就不需要登录,直接显示头像 1.成功登录后,客户端请求服 ...
- Mac 10.11.4 安装mysql-5.7.13 默认密码问题
今天下载了一个最新版的mysql dmg安装包来安装mysql,安装的整个过程竟然都没有提示输入root用户默认密码,我也没太在意,然后连接数据库时竟然提示输入密码,当时就一脸懵逼了.尝试各种密码,为 ...
- Jmeter各部件的作用
JMeter主要组件介绍 1.测试计划(Test Plan)是使用 JMeter 进行测试的起点,它是其它 JMeter 测试元件的容器. 2.线程组(Thread Group)代表一定数量的并发用户 ...
- requireJS的优化工具 ---- r.js
requireJS是javascript的模块加载器,是基于AMD规范实现的. r.js是其提供的对模块进行打包和构建的一个工具 下载 r.js 创建r.js 的配置文件 build.js build ...
- Js 对象数组,转化为字符串
var str = [{"cuid":"23910","content":"是","type":&q ...
- C/S与B/S架构的区别和优缺点
C/S 架构的概念 C/S是Client/Server,即客户端/服务器端架构,一种典型的两层架构. 客户端包含一个或多个在用户的电脑上运行的程序 服务器端有两种,一种是数据库服务器端,客户端通过数据 ...