
java实现wordCount的map
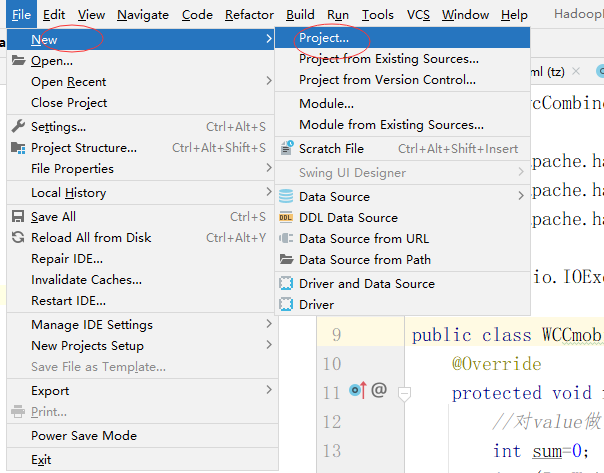
打开IDEA,File——new ——Project,新建一个项目
我们已经安装好了maven,不用白不用
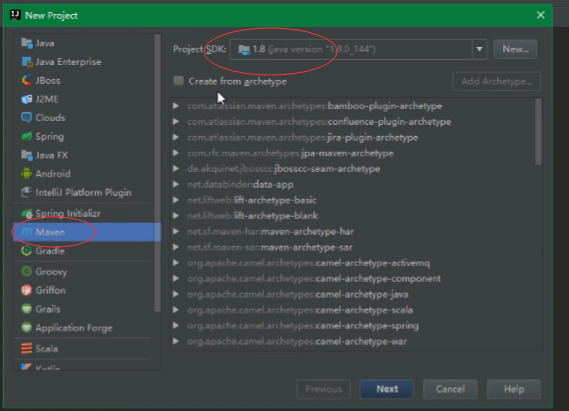
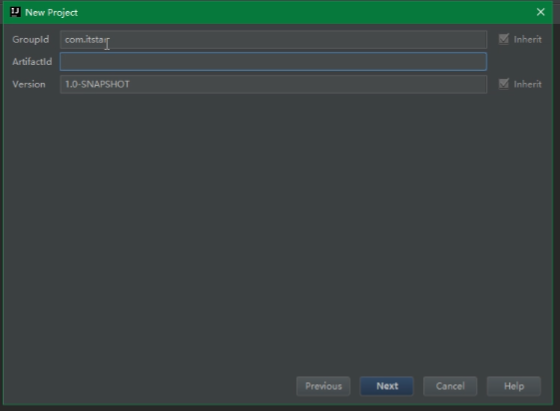
这里不要选用骨架,Next。在写上Groupid,Next。
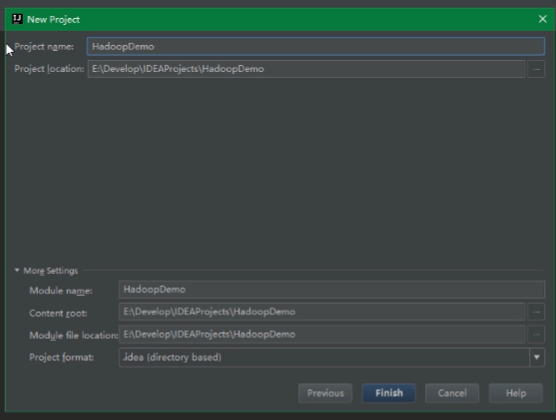
写上项目名称,finish。ok。
一个项目就建好了,他长这样:
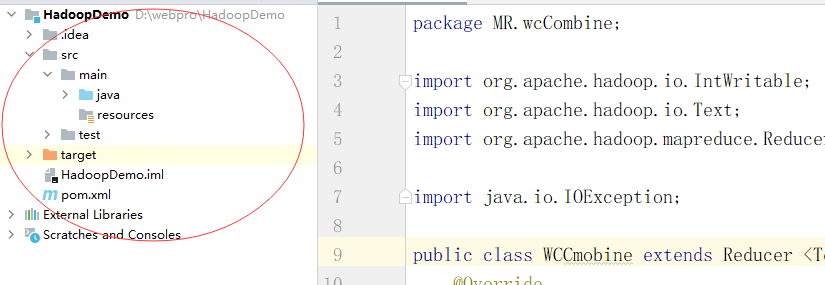
新建的项目要配置一下maven。毕竟我们马上就要用它。然后导入依赖
打开pom.xml
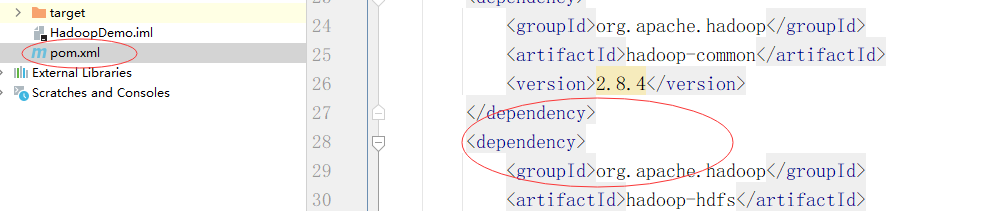
不愿意一个一个敲的话,可以使用cv大法。
<dependencies>
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-common</artifactId>
        <version>2.8.4</version>
    </dependency>
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-hdfs</artifactId>
        <version>2.8.4</version>
    </dependency>
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-client</artifactId>
        <version>2.8.4</version>
    </dependency>
    <dependency>
        <groupId>log4j</groupId>
        <artifactId>log4j</artifactId>
        <version>1.2.17</version>
    </dependency>
    <dependency>
        <groupId>org.slf4j</groupId>
        <artifactId>slf4j-api</artifactId>
        <version>1.7.7</version>
    </dependency>
    <dependency>
        <groupId>junit</groupId>
        <artifactId>junit</artifactId>
        <version>4.12</version>
        <scope>test</scope>
    </dependency>
</dependencies>
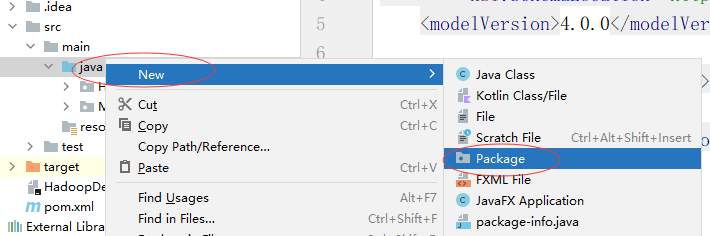
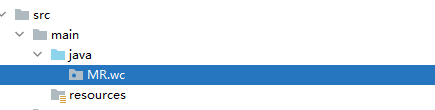
等待下载的时候我们可以创建项目了。打开src——main——java,右键Package,我们在这里新建一个package。我们在这里包里面写一个wordcount的案例
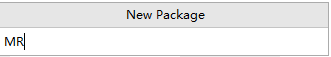
名字就叫MR
 .
mr下再建一个包:wc。如图:
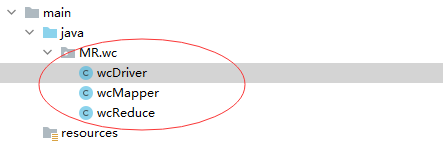
在wc下新建一个java类:wcMapper。这个类负责读取单词,生成map(键值对)
再创建一个wcReduce类。这个类负责聚合,把key相同的数据放到一起,并且累加value。
再创建一个wcDriver类,驱动类主要用于关联Mapper 和 Reducer 以及 提交整个程序。就像这样:
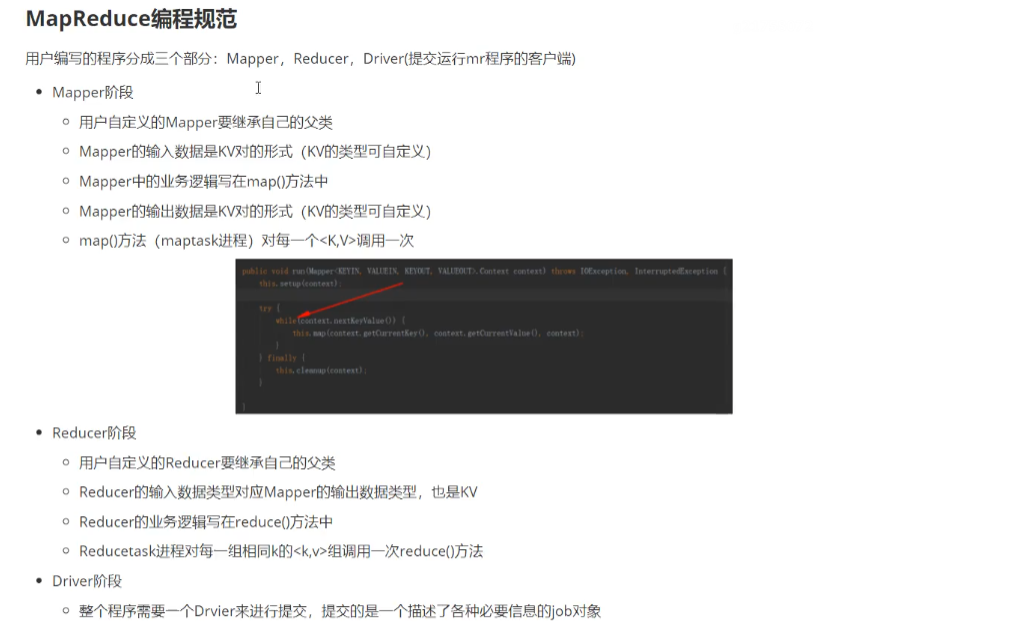
在写代码之前,我们先看一个mapreduce编程规范:
继续看代码,我们先写wcMapper类
package MR.wc;

/**
 * 按行读取数据,拆成一个一个的单词
 * */
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

/**继承Mapper类,这个类要是hadoop.mapreduce.Mapper
 * 这里有一个泛型, Mapper<KEYIN, VALUEIN, KEYOUT, VALUEOUT>KEYIN,VALUEIN 规定数据是以什么类型进入map程序(MR程序提供了几种类型)
 * KEYIN这个参数表示读取文件的行数,一般是数字类型。由于是文件可能会很大,一般不用int,而是用long
 * VALUEIN这个参数表示读取数据的格式,也就是单词的格式,这里就是字符串
 * 我们的对象要在节点之间通过网络传输,就需要序列化。但是java的序列化是一个重量级序列化框架,一个对象被序列化后,会附带很多额外的信息
 * (各种校验信息,header,继承体系等),不便于在网络中高效传输。所以hadoop开发了一套序列化机制(writable),精简,高效
 *
 *
 */
public class wcMapper extends Mapper<LongWritable, Text,Text, IntWritable> {
    Text ko=new Text();
    IntWritable vo=new IntWritable(1);//value值默认为1
    //重写map方法,key跟value是我们读取进来的数据,数据处理玩以后就放到congtext(上下文)里面
    @Override
    protected void map(LongWritable key, Text value, Mapper<LongWritable, Text, Text, IntWritable>.Context context) throws IOException, InterruptedException {
        //读取到的这一行数据先转成String类型
        String line = value.toString();
        //按照空格切分单词
        String[] words = line.split(" ");
        //处理数据
        for (String word : words) {
            //keyout设置成单词
            ko.set(word);
            //通过上下把处理好的数据写出
            context.write(ko,vo);
        }
    }}
到这里,map这个过程就写完了,这个过程就实现了按行读取数据,并且把单词转化成了key,value的形式,给每个单词的value值标成了1,然后通过上下文把数据写出,在wc这个程序中,实际上就是把这个key,value传给了wcRecude。让reduce过程去按照key聚合value。
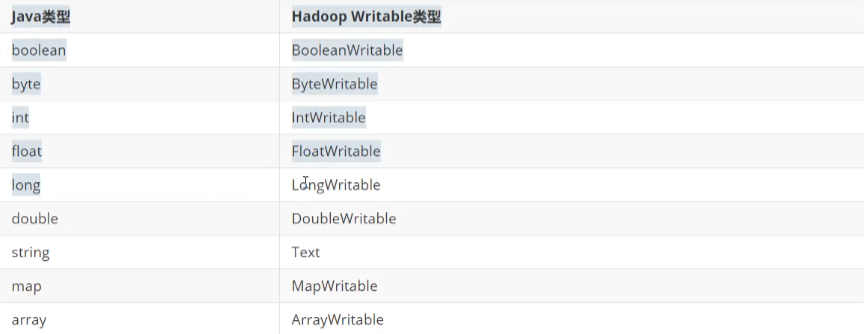
常用java类型对应的HadoopWritable类型:
java实现wordCount的map的更多相关文章
- Spark:用Scala和Java实现WordCount
http://www.cnblogs.com/byrhuangqiang/p/4017725.html 为了在IDEA中编写scala,今天安装配置学习了IDEA集成开发环境.IDEA确实很优秀,学会 ...
- Java集合框架之map
Java集合框架之map. Map的主要实现类有HashMap,LinkedHashMap,TreeMap,等等.具体可参阅API文档. 其中HashMap是无序排序. LinkedHashMap是自 ...
- Java中如何遍历Map对象的4种方法
在java中遍历Map有不少的方法.我们看一下最常用的方法及其优缺点. 既然java中的所有map都实现了Map接口,以下方法适用于任何map实现(HashMap, TreeMap, LinkedHa ...
- JAVA的容器---List,Map,Set (转)
JAVA的容器---List,Map,Set Collection├List│├LinkedList│├ArrayList│└Vector│ └Stack└SetMap├Hashtable├HashM ...
- 转!! Java中如何遍历Map对象的4种方法
在Java中如何遍历Map对象 How to Iterate Over a Map in Java 在java中遍历Map有不少的方法.我们看一下最常用的方法及其优缺点. 既然java中的所有map都 ...
- Java 集合系列 15 Map总结
java 集合系列目录: Java 集合系列 01 总体框架 Java 集合系列 02 Collection架构 Java 集合系列 03 ArrayList详细介绍(源码解析)和使用示例 Java ...
- Java 集合系列 08 Map架构
java 集合系列目录: Java 集合系列 01 总体框架 Java 集合系列 02 Collection架构 Java 集合系列 03 ArrayList详细介绍(源码解析)和使用示例 Java ...
- 【转】Java中如何遍历Map对
在Java中如何遍历Map对象 How to Iterate Over a Map in Java 在java中遍历Map有不少的方法.我们看一下最常用的方法及其优缺点. 既然java中的所有map都 ...
- 【转】Java中如何遍历Map对象的4种方法
原文网址:http://blog.csdn.net/tjcyjd/article/details/11111401 在Java中如何遍历Map对象 How to Iterate Over a Map ...
随机推荐
- mysql事务管理和mysql用户管理
1.什么是事务? 事务是一条或者是一组语句组成一个单元,这个单元要么全部执行,要么全不执行. 2.事务特性:ACID: A:atomicity原子性:整个事务中的所有操作要么全部成功执行,要么全部失败 ...
- 234. Palindrome Linked List - LeetCode
Question 234. Palindrome Linked List Solution 题目大意:给一个链表,判断是该链表中的元素组成的串是否回文 思路:遍历链表添加到一个list中,再遍历lis ...
- unity---公共模块MonoController
公共模块 如果有很多类使用Update()函数,会导致性能浪费 如果函数统一在一个Update()中执行 代码 上述,需要将脚本挂载到物体上, 故新建了一个管理类MonoMgr Mgr另外的作用 可以 ...
- css属性补充与JS数据类型
目录 溢出属性(overflow) 定位(position) z-index属性 opacity不透明度 JavaScript简介 变量与注释 数据类型 数值(Number) 字符串(String) ...
- Vue基础之 动态组件
为什么会有动态组件> vue 通过组件机制 实现的页面功能的模块化处理,通常情况下 我们在vue中使用组件 就是先定义组件 然后再需要的地方 插入组件即可 但是在某些情况下 需要根据不同的需求 ...
- ML第一周学习小结
最近的学习内容为<Python机器学习基础教程>这本书 从第一章开始,慢慢来,比较快. 一下为我的本周机器学习小结,以及下周的Flag. 本周收获 总结一下本周学习内容: 1.了解到机器学 ...
- Hive参数与性能企业级调优
Hive作为大数据平台举足轻重的框架,以其稳定性和简单易用性也成为当前构建企业级数据仓库时使用最多的框架之一. 但是如果我们只局限于会使用Hive,而不考虑性能问题,就难搭建出一个完美的数仓,所以Hi ...
- 测试软件稳定性、健壮性之Monkey工具--简洁与深入
搭建环境这章节没做详细说明,因为我是前期做APP自动化是已经将 SDK 以及JDK给安装配置好了,这次是直接上来演示monkey的功能点以及运用 一.什么是稳定性测试? 通过随机点击屏幕一段时间,看看 ...
- 2 万字 + 20张图| 细说 Redis 九种数据类型和应用场景
作者:小林coding 计算机八股文网(操作系统.计算机网络.计算机组成.MySQL.Redis):https://xiaolincoding.com 大家好,我是小林. 我们都知道 Redis 提供 ...
- Linux/Ubuntu 安装Redis
更新记录 2022年6月15日 发布. 2022年6月12日 开始编写. 安装Redis 更新源 sudo apt update 安装redis sudo apt install redis-serv ...