
安装 python 爬虫框架 Scrapy
官方安装说明文档:https://doc.scrapy.org/en/latest/intro/install.html#installing-scrapy
一、scrapy 需要以下依赖
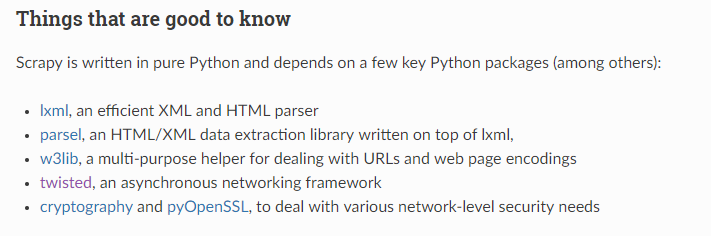
二、一般来说,你可以通过以下命令直接安装 Scrapy(依赖会被自动安装)
pip3 install scrapy
注:关于pip 和 pip3 的区别,请看 这里
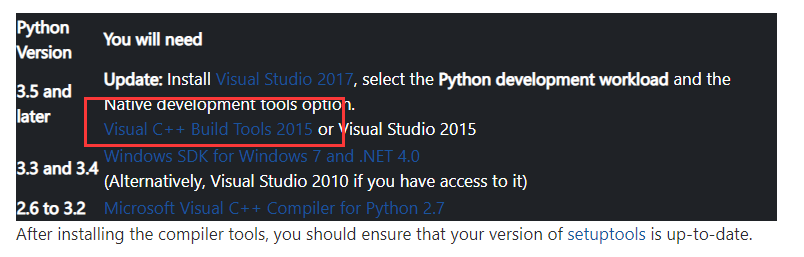
三、一个常见的问题是:安装 twisted 时,会报 “Microsoft visual c++ 14.0 is required” 错误
解决办法有两个:
1、老老实实安装 Visual C++ Build Tools 2015 套件,套件比较大(大概4G),安装时间比较久,传送门:Visual C++ Build Tools 2015
2、用安装 whl 文件的方式安装 Twisted
打开:https://www.lfd.uci.edu/~gohlke/pythonlibs/,crtl + f 查找 twisted,选择适合自己的版本下载

注:这个网站打开有点慢,翻墙的话,会好一点
四、进入 Twisted 的下载目录,shift + 鼠标右键,选择 “在此处打开 Powershell 窗口”,执行以下命令,安装 Twisted
pip3 install Twisted-19.2.1-cp37-cp37m-win32.whl
五、正常安装 Scrapy
pip3 install scrapy
六、如遇到其他错误,可以重复以上步骤,使用 whl 文件方式安装 python 扩展
非官方:https://www.lfd.uci.edu/~gohlke/pythonlibs/
本文链接:https://www.cnblogs.com/tujia/p/11169180.html
安装 python 爬虫框架 Scrapy的更多相关文章
- Linux 安装python爬虫框架 scrapy
Linux 安装python爬虫框架 scrapy http://scrapy.org/ Scrapy是python最好用的一个爬虫框架.要求: python2.7.x. 1. Ubuntu14.04 ...
- Ubuntu14.04下如何安装Python爬虫框架Scrapy
按照官方文档的说明,安装scrapy 需要以下程序或者库: (1).Python 2.7 (2).lxml. Most linux distributions ships PRepackaged ve ...
- win环境安装python爬虫框架scrapy
#官网下载python for windows #https://www.python.org/downloads/ #安装后在“计算机->属性->高级系统设置->环境变量-> ...
- 教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http://www.xiaohuar.com/,让你体验爬取校花的成就感. Scr ...
- 【转载】教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
原文:教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神 本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http:/ ...
- Python爬虫框架Scrapy实例(三)数据存储到MongoDB
Python爬虫框架Scrapy实例(三)数据存储到MongoDB任务目标:爬取豆瓣电影top250,将数据存储到MongoDB中. items.py文件复制代码# -*- coding: utf-8 ...
- 《Python3网络爬虫开发实战》PDF+源代码+《精通Python爬虫框架Scrapy》中英文PDF源代码
下载:https://pan.baidu.com/s/1oejHek3Vmu0ZYvp4w9ZLsw <Python 3网络爬虫开发实战>中文PDF+源代码 下载:https://pan. ...
- Python爬虫框架Scrapy教程(1)—入门
最近实验室的项目中有一个需求是这样的,需要爬取若干个(数目不小)网站发布的文章元数据(标题.时间.正文等).问题是这些网站都很老旧和小众,当然也不可能遵守 Microdata 这类标准.这时候所有网页 ...
- 《精通Python爬虫框架Scrapy》学习资料
<精通Python爬虫框架Scrapy>学习资料 百度网盘:https://pan.baidu.com/s/1ACOYulLLpp9J7Q7src2rVA
随机推荐
- graylog-日志收集
1.linux主机日志收集 使用syslog协议将系统日志发送到graylog上进行收集,可以指定端口 touch /etc/rsyslog.d/graylog.conf *.* @192.168.9 ...
- Feign 报错:The bean 'service-producer.FeignClientSpecification', defined in null, could not be registered. A bean with that name has already been defined in null and overriding is disabled.
报错: 2019-09-17 20:34:47.635 ERROR 59509 --- [ main] o.s.b.d.LoggingFailureAnalysisReporter : ******* ...
- 牛客NOIP暑期七天营-提高组5
A:deco的abs. 水题,先%,然后相邻两个数min()一下差值. #include<bits/stdc++.h> #define ll long long using namespa ...
- Linux计划作业练习
1.crontab -eu zh //每天晚上10天提醒用户可以去睡觉了 * */10 * * * go to sleep 2.查询crontab的工作内容 3.当crontab命令格式出错时 ...
- MongoDB 部署复制集(副本集)
部署MongoDB复制集(副本集) 环境 操作系统:Ubuntu 18.04 MongoDB: 4.0.3 服务器 首先部署3台服务器,1台主节点 + 2台从节点 3台服务器的内容ip分别是: 1 ...
- .Net 下基于Redlock redis 分布式锁实现
Redlock-cs (C#/.NET implementation). RedLock.net (C#/.NET implementation). Includes async and lock e ...
- linux grep 查询多行的方法
linux grep 查询多行的方法 经常查询 git log 中使用的方法, 如下 git log |grep "xxxx" 如果想查询多行的话, 就有些尴尬, 如果想查询多行的 ...
- Sherlock and His Girlfriend(信息学奥赛一本通 1623)
[题目描述] 原题来自:Codeforces Round #400 B. Sherlock 有了一个新女友(这太不像他了!).情人节到了,他想送给女友一些珠宝当做礼物. 他买了 n 件珠宝.第 i 件 ...
- 第09组 Alpha冲刺(3/6)
队名:观光队 组长博客 作业博客 组员实践情况 王耀鑫 过去两天完成了哪些任务 文字/口头描述 完成服务器连接数据库部分代码 展示GitHub当日代码/文档签入记录 接下来的计划 服务器网络请求,vu ...
- SpringSecurity匿名用户访问权限
在SpringSecurity中定义一个匿名访问权限,实现未登录用户可以访问默写页面 <http use-expressions="false" entry-point-re ...