
MapReduce-实践1
MR进阶实践1: -file 分发多个文件
【-file 适合场景】分发文件在本地,小文件
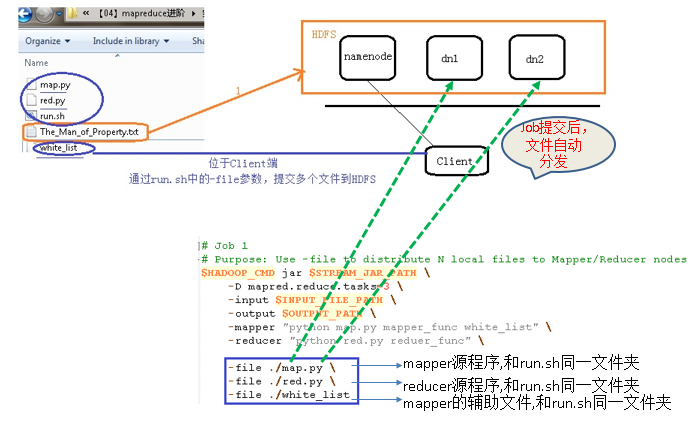
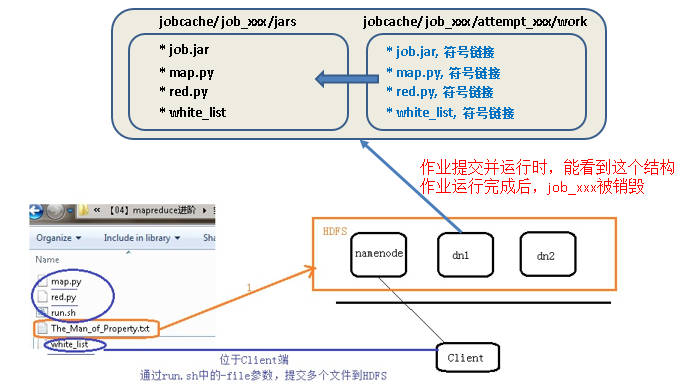
HADOOP_CMD="/usr/local/src/hadoop-1.2.1/bin/hadoop"

STREAM_JAR_PATH="/usr/local/src/hadoop-1.2.1/contrib/streaming/hadoop-streaming-1.2.1.jar"

INPUT_FILE_PATH="/02_filedistribute_input/The_Man_of_Property.txt"

OUTPUT_PATH="/02_filedistribute_output"

$HADOOP_CMD fs -rmr-skipTrash $OUTPUT_PATH

# job1: use -file to distribute  local file to cluster

# these  files will bestored in the same directory in each datanode

$HADOOP_CMD jar$STREAM_JAR_PATH \

    -input $INPUT_FILE_PATH \

    -output $OUTPUT_PATH \

    -mapper "python map.py mapper_funcwhite_list" \

    -reducer "python red.pyreducer_func" \

    -file ./map.py \

    -file ./red.py \

    -file ./white_list
HADOOP_CMD="/usr/local/src/hadoop-1.2.1/bin/hadoop"

STREAM_JAR_PATH="/usr/local/src/hadoop-1.2.1/contrib/streaming/hadoop-streaming-1.2.1.jar"

INPUT_FILE_PATH="/02_filedistribute_input/The_Man_of_Property.txt"

OUTPUT_PATH="/02_filedistribute_output"

$HADOOP_CMD fs -rmr-skipTrash $OUTPUT_PATH

# job1: use -file todistribute  files

# these  files will be stored in the same directory in each datanode

$HADOOP_CMD jar$STREAM_JAR_PATH \

    -input $INPUT_FILE_PATH \

    -output $OUTPUT_PATH \

    -mapper "python map.py mapper_funcwhite_list" \

    -reducer "pythonred.py reducer_func" \

    -jobconf “mapred.reduce.tasks=” \  # deprecated option, not suggested

    -file ./map.py \

    -file ./red.py \

    -file ./white_list
HADOOP_CMD="/usr/local/src/hadoop-1.2.1/bin/hadoop"

STREAM_JAR_PATH="/usr/local/src/hadoop-1.2.1/contrib/streaming/hadoop-streaming-1.2.1.jar"

INPUT_FILE_PATH="/02_filedistribute_input/The_Man_of_Property.txt"

OUTPUT_PATH="/02_filedistribute_output"

$HADOOP_CMD fs -rmr-skipTrash $OUTPUT_PATH

# job1: use -file todistribute  files

# these  files will bestored in the same directory in each datanode

$HADOOP_CMD jar$STREAM_JAR_PATH \

    -D mapred.reduce.tasks= \

    -input $INPUT_FILE_PATH \

    -output $OUTPUT_PATH \

    -mapper "python map.py mapper_funcwhite_list" \

    -reducer "pythonred.py reducer_func" \

    -file ./map.py \

    -file ./red.py \

    -file ./white_list
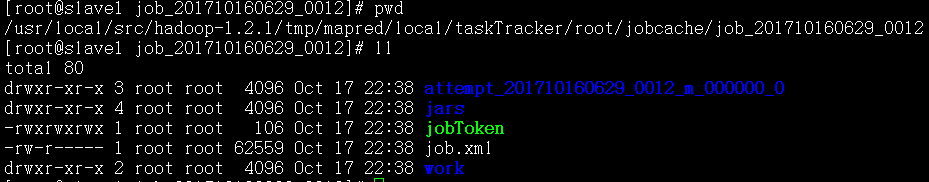
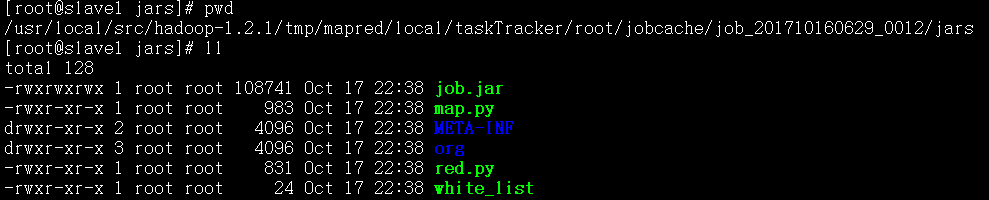

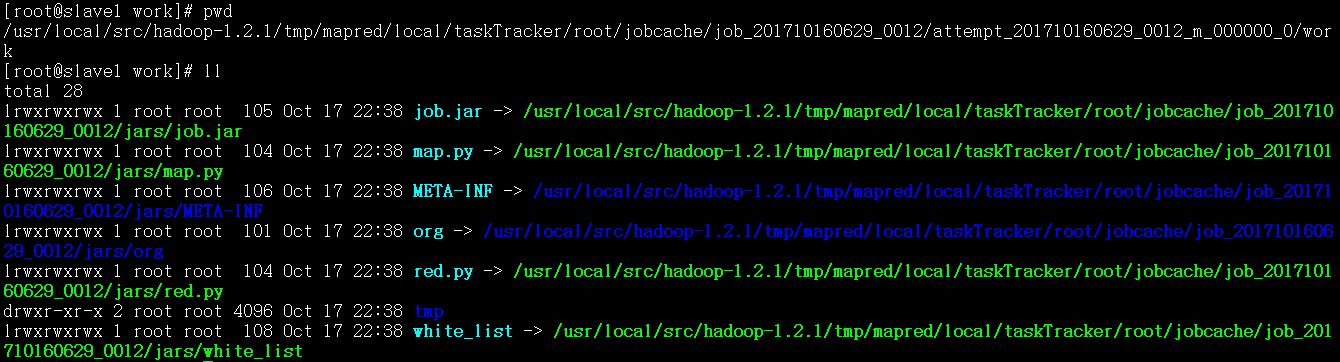
MR进阶实践2: -cacheFile 将放在HFDS上的文件分发给计算节点
# hadoop fs -put ./white_list /

# rm -rf ./white_list
HADOOP_CMD="/usr/local/src/hadoop-1.2.1/bin/hadoop"

STREAM_JAR_PATH="/usr/local/src/hadoop-1.2.1/contrib/streaming/hadoop-streaming-1.2.1.jar"

INPUT_FILE_PATH="/03_cachefiledistribute_input/The_Man_of_Property.txt"

OUTPUT_PATH="/03_cachefiledistribute_output"

$HADOOP_CMD fs -rmr-skipTrash $OUTPUT_PATH

# job2: use -cacheFileto distribute HDFS file to compute node

$HADOOP_CMD jar$STREAM_JAR_PATH \

    -input $INPUT_FILE_PATH \

    -output $OUTPUT_PATH \

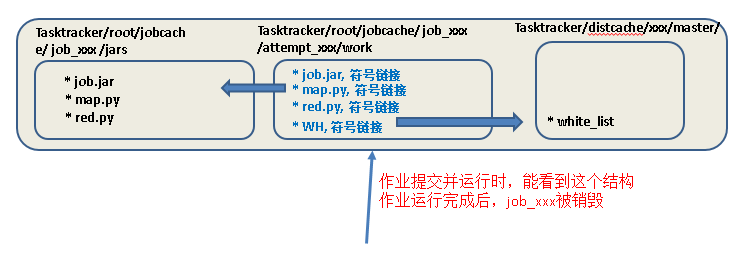
    -mapper "python map.py mapper_func WH" \

    #这里也一定要用WH符号链接,因为作业开始运行后创建的attemps目录中只能看到WH,和map.py符号链接位于同一目录

    -reducer "pythonred.py reducer_func" \

    -cacheFile “hdfs://master:9000/white_list#WH”

    #WH一定要,每个attemp中要生成该符号链接,指向Tasktracer/distcache中的whitelist

    -file ./map.py \

    -file ./red.py
MR进阶实践3: -cacheArchive 将位于HFDS上的压缩文件分发给计算节点
# hadoop fs –put ./w.tar.gz  /

# hadoop fs –ls /

查看是否已经上传成功
HADOOP_CMD="/usr/local/src/hadoop-1.2.1/bin/hadoop"

STREAM_JAR_PATH="/usr/local/src/hadoop-1.2.1/contrib/streaming/hadoop-streaming-1.2.1.jar"

INPUT_FILE_PATH="/03_cachefiledistribute_input/The_Man_of_Property.txt"

OUTPUT_PATH="/03_cachefiledistribute_output"

$HADOOP_CMD fs -rmr-skipTrash $OUTPUT_PATH

# job3: use -cacheArchive to distribute HDFS compressed file to compute node

$HADOOP_CMD jar$STREAM_JAR_PATH \

    -input $INPUT_FILE_PATH \

    -output $OUTPUT_PATH \

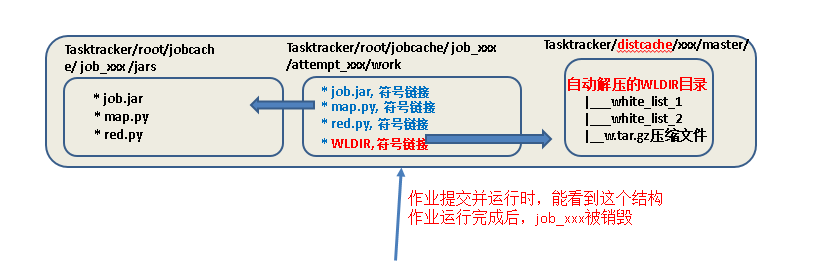
    -mapper "python map.py mapper_func WLDIR" \

    #这里也一定要用WH.gz符号链接名,因为attemps中只能看到WH.gz

    -reducer "pythonred.py reducer_func" \

    -cacheArchive “hdfs://master:9000/w.tar.gz#WLDIR”

    #WLDIR一定要,每个attemp中要生成该符号链接,指向Tasktracer/distcache中已经自动解压的文件夹,文件夹中有white_list_1,white_list_2

    -file ./map.py \

    -file ./red.py
MapReduce-实践1的更多相关文章
- 大数据系列之分布式计算批处理引擎MapReduce实践-排序
清明刚过,该来学习点新的知识点了. 上次说到关于MapReduce对于文本中词频的统计使用WordCount.如果还有同学不熟悉的可以参考博文大数据系列之分布式计算批处理引擎MapReduce实践. ...
- 大数据系列之分布式计算批处理引擎MapReduce实践
关于MR的工作原理不做过多叙述,本文将对MapReduce的实例WordCount(单词计数程序)做实践,从而理解MapReduce的工作机制. WordCount: 1.应用场景,在大量文件中存储了 ...
- 大数据系列之数据仓库Hive命令使用及JDBC连接
Hive系列博文,持续更新~~~ 大数据系列之数据仓库Hive原理 大数据系列之数据仓库Hive安装 大数据系列之数据仓库Hive中分区Partition如何使用 大数据系列之数据仓库Hive命令使用 ...
- Hadoop MapReduce开发最佳实践(上篇)
body{ font-family: "Microsoft YaHei UI","Microsoft YaHei",SimSun,"Segoe UI& ...
- 化繁为简(三)—探索Mapreduce简要原理与实践
目录-探索mapreduce 1.Mapreduce的模型简介与特性?Yarn的作用? 2.mapreduce的工作原理是怎样的? 3.配置Yarn与Mapreduce.演示Mapreduce例子程序 ...
- MapReduce 原理与 Python 实践
MapReduce 原理与 Python 实践 1. MapReduce 原理 以下是个人在MongoDB和Redis实际应用中总结的Map-Reduce的理解 Hadoop 的 MapReduce ...
- 【原创 Hadoop&Spark 动手实践 3】Hadoop2.7.3 MapReduce理论与动手实践
开始聊MapReduce,MapReduce是Hadoop的计算框架,我学Hadoop是从Hive开始入手,再到hdfs,当我学习hdfs时候,就感觉到hdfs和mapreduce关系的紧密.这个可能 ...
- Hadoop化繁为简(三)—探索Mapreduce简要原理与实践
目录-探索mapreduce 1.Mapreduce的模型简介与特性?Yarn的作用? 2.mapreduce的工作原理是怎样的? 3.配置Yarn与Mapreduce.演示Mapreduce例子程序 ...
- [转] Hadoop MapReduce开发最佳实践(上篇)
前言 本文是Hadoop最佳实践系列第二篇,上一篇为<Hadoop管理员的十个最佳实践>. MapRuduce开发对于大多数程序员都会觉得略显复杂,运行一个WordCount(Hadoop ...
- Mapreduce简要原理与实践
探索Mapreduce简要原理与实践 目录-探索mapreduce 1.Mapreduce的模型简介与特性?Yarn的作用? 2.mapreduce的工作原理是怎样的? 3.配置Yarn与Mapred ...
随机推荐
- SparkStreming之updateStateByKey
正文 上一篇简单的写了一个socketTextStream的demo,这个问题就是每一次不能将之前和之后的数据进行合并统一.接下来我们通过demo进行把着这个问题解决. val conf = new ...
- 单例模式(Singleton)看了就懂
单例,故名思议,一个只能创建一个实例的类. 单例被广泛应用于Spring的bean(默认).线程池.数据库连接池.缓存,还有其他一些无状态的类如servlet. 一个没必要多例的类实现了单例可以节约空 ...
- 由throw new Error() 引发的探讨
问题复现 在工作时遇到了需要抛出异常并且需要自己捕获处理的地方,于是在抛出的地方写下 function parseExcel(con) { try { // doSomething } catch ( ...
- 树莓派3 B+ 的摄像头简单使用(video-streamer)
一.首先在某东上购买树莓派摄像头 我的买的硬件张这个样子的(CSI接口摄像头): 正视图 ...
- 详细解读-this-关键字在全局、函数、对象、jQuery中的基础用法!
一.前言 1. Javascript是一门基于对象的动态语言,也就是说,所有东西都是对象,一个很典型的例子就是函数也被视为普通的对象.Javascript可以通过一定的设计模式来实现面向对象的编程,其 ...
- 什么是PWM信号
PWM信号脉宽调制PWM是开关型稳压电源中的术语.这是按稳压的控制方式分类的,除了PWM型,还有PFM型和PWM.PFM混合型.脉宽宽度调制式(PWM)开关型稳压电路是在控制电路输出频率不变的情况下, ...
- struts jar包
这些错误很让我摸不着头脑,经多方查阅资料后,在Struts 2.2.x中应该导入如下7个JAR文件 1) commons-fileupload-1.2.1.jar 2) commons-io- ...
- Beautiful Dream hdu3418 (直接做或二分)
Beautiful Dream Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Others)T ...
- bzoj4236 JOIOJI hash 模拟
JOIOJI桑是JOI君的叔叔."JOIOJI"这个名字是由"J.O.I"三个字母各两个构成的. 最近,JOIOJI桑有了一个孩子.JOIOJI桑想让自己孩子的 ...
- javascript(js)创建对象的模式与继承的几种方式
1.js创建对象的几种方式 工厂模式 为什么会产生工厂模式,原因是使用同一个接口创建很多对象,会产生大量的重复代码,为了解决这个问题,产生了工厂模式. function createPerson(na ...