
redis源码学习-skiplist
1.初步认识跳跃表
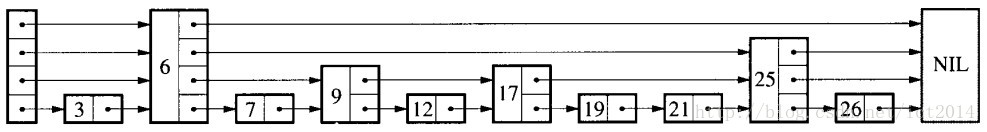
图中所示,跳跃表与普通链表的区别在于,每一个节点可以有多个后置节点,图中是一个4层的跳跃表
第0层: head->3->6->7->9->12->17->19->21->25->26->tail

第1层: head->6->9->17->25->tail

第2层: head->6->25->tail

第3层: head->6->tail
传统意义的单链表是一个线性结构,向有序的链表中插入一个节点需要O(n)的时间,查找操作需要O(n)的时间。如果我们使用图中所示的跳跃表,就可以减少查找所需时间为O(n/2),因为我们可以先通过每个节点的最上面的指针先进行查找,这样子就能跳过一半的节点。比如我们想查找19,首先和6比较,大于6之后,在和9进行比较,然后在和12进行比较......最后比较到21的时候,发现21大于19,说明查找的点在17和21之间,从这个过程中,我们可以看出,查找的时候跳过了3、7、12等点,因此查找的复杂度为O(n/2)。
2.redis中实现的skiplist
结构体 zskiplist
typedef struct zskiplist {

  // 表头节点和表尾节点

  struct zskiplistNode *header, *tail;

  // 表中节点的数量

  unsigned long length;

  // 表中层数最大的节点的层数

  int level;

 } zskiplist;

 // 节点

 typedef struct zskiplistNode {

  // 成员对象

  robj *obj;

  // 分值

  double score;

  // 后退指针

  struct zskiplistNode *backward; // 前一个节点

  // 层

  struct zskiplistLevel {

      // 前进指针

      struct zskiplistNode *forward; // 下一个节点

      // 跨度

      unsigned int span;  // 当前节点在第i层到下一个节点forward需要跨过的节点数

  } level[];

} zskiplistNode;
redis实现的跳跃表特点:
1.zskiplistNode中保存着前置节点backward

2.跳跃表的层数最大值32,每次插入新节点都会生成一个随机的level(1~32)作为新节点的层数

3.删除节点可能会引起跳跃表层数的下降,插入节点可能会引起跳跃表层数上升

4.查找节点的时间复杂度平均为 O(logn)

5.插入和删除的成本都比较低,拥有平衡二叉树的查找性能
创建一条skiplist
   // 创建一条长度为0的skiplist

     zskiplist *zslCreate(void) {

     int j;

     zskiplist *zsl;

 // 分配空间

 zsl = zmalloc(sizeof(*zsl));

 zsl->level = 1; // 起始层数

 zsl->length = 0; // 跳跃表长度

 // 初始化表头节点

 // T = O(1)

 zsl->header = zslCreateNode(ZSKIPLIST_MAXLEVEL,0,NULL);

 for (j = 0; j < ZSKIPLIST_MAXLEVEL; j++) {

     zsl->header->level[j].forward = NULL;

     zsl->header->level[j].span = 0;

 }

 zsl->header->backward = NULL;

 // 设置表尾

 zsl->tail = NULL;

 return zsl;

}

// 创建新节点

 zskiplistNode *zslCreateNode(int level, double score, robj *obj) {

 // 分配空间

 zskiplistNode *zn = zmalloc(sizeof(*zn)+level*sizeof(struct zskiplistLevel));

 // 设置属性

 zn->score = score;

 zn->obj = obj;

 return zn;

}
插入一个节点
 zskiplistNode *zslInsert(zskiplist *zsl, double score, robj *obj) {

   zskiplistNode *update[ZSKIPLIST_MAXLEVEL], *x;

   unsigned int rank[ZSKIPLIST_MAXLEVEL];

   int i, level;

   redisAssert(!isnan(score)); // 保证score合法性

   // level越高每一次forward跨越的节点越多,先大间距的查找,随着level的减小,查找范围逐渐缩小

   x = zsl->header;

   for (i = zsl->level-1; i >= 0; i--) {

       // rank[i]用来记录当前节点x与header的距离,随着x的移动,rank[i]实时更新

       rank[i] = i == (zsl->level-1) ? 0 : rank[i+1];

       // 沿着前进指针遍历跳跃表

       // T_wrost = O(N^2), T_avg = O(N log N)

       while (x->level[i].forward &&

           (x->level[i].forward->score < score ||

               // 比对分值

               (x->level[i].forward->score == score &&

               // 比对成员, T = O(N)

               compareStringObjects(x->level[i].forward->obj,obj) < 0))) {

           // 记录沿途跨越了多少个节点

           rank[i] += x->level[i].span;

           // 移动至下一指针

           x = x->level[i].forward;

       }

       // 第i层第一个大于 score的节点,将作为插入节点obj在第i层连接的的前一个节点

       update[i] = x;

   }

   /* we assume the key is not already inside, since we allow duplicated

    * scores, and the re-insertion of score and redis object should never

    * happen since the caller of zslInsert() should test in the hash table

    * if the element is already inside or not.

    *

    * zslInsert() 的调用者会确保同分值且同成员的元素不会出现,

    * 所以这里不需要进一步进行检查,可以直接创建新元素。

    */

   // 获取一个随机值作为新节点的层数

   // T = O(N)

   level = zslRandomLevel();

   // 如果新节点的层数比表中其他节点的层数都要大

   // 那么初始化表头节点中未使用的层,并将它们记录到 update 数组中

   // 将来也指向新节点

   if (level > zsl->level) {

       // 初始化未使用层

       // T = O(1)

       for (i = zsl->level; i < level; i++) {

           rank[i] = 0;

           update[i] = zsl->header;

           update[i]->level[i].span = zsl->length;

       }

       // 更新表中节点最大层数

       zsl->level = level;

   }

   // 创建新节点

   x = zslCreateNode(level,score,obj);

   // 将前面记录的指针指向新节点,并做相应的设置

   // update[i]保存着第i层x的前置节点,rank[i]保存的是第i层x的前置节点离header的距离,rank[0]+1即是x离header的距离

   for (i = 0; i < level; i++) {

       // 设置新节点的 forward 指针

       x->level[i].forward = update[i]->level[i].forward;

       // 将沿途记录的各个节点的 forward 指针指向新节点

       update[i]->level[i].forward = x;

       /* update span covered by update[i] as x is inserted here */

       // 用x前置节点到x后置节点的跨度减去x到前置节点的距离等于x到后置节点的跨度

       x->level[i].span = update[i]->level[i].span - (rank[0] - rank[i]);

       // 更新新节点插入之后,沿途节点的 span 值

       // 其中的 +1 计算的是新节点

       update[i]->level[i].span = (rank[0] - rank[i]) + 1;   // (rank[0] - rank[i]) 为x距离update[i]的距离

   }

   /* increment span for untouched levels */

   // 未接触的节点的 span 值也需要增一,因为这些节点到后置节点中间插入了一个节点x

   // T = O(1)

   for (i = level; i < zsl->level; i++) {

       update[i]->level[i].span++;

   }

   // 设置新节点的后退指针

   x->backward = (update[0] == zsl->header) ? NULL : update[0];

   if (x->level[0].forward)

       x->level[0].forward->backward = x;

   else

       zsl->tail = x;  // x是跳跃表的尾部节点

   // 跳跃表的节点计数增一

   zsl->length++;

   return x;

 }
删除一个节点
int zslDelete(zskiplist *zsl, double score, robj *obj) {

   zskiplistNode *update[ZSKIPLIST_MAXLEVEL], *x;

   int i;

 // 遍历跳跃表,查找目标节点,并记录所有沿途节点

 // T_wrost = O(N^2), T_avg = O(N log N)

 x = zsl->header;

 for (i = zsl->level-1; i >= 0; i--) {

     // 遍历跳跃表的复杂度为 T_wrost = O(N), T_avg = O(log N)

     while (x->level[i].forward &&

         (x->level[i].forward->score < score ||

             // 比对分值

             (x->level[i].forward->score == score &&

             // 比对对象,T = O(N)

             compareStringObjects(x->level[i].forward->obj,obj) < 0)))

         // 沿着前进指针移动

         x = x->level[i].forward;

     // 第i层上obj的前一个节点

     update[i] = x;

 }

 /* We may have multiple elements with the same score, what we need

  * is to find the element with both the right score and object.

  *

  * 检查找到的元素 x ,只有在它的分值和对象都相同时,才将它删除。

  */

 x = x->level[0].forward; // 指向目标节点

 if (x && score == x->score && equalStringObjects(x->obj,obj)) { // 目标节点与obj一样

     // T = O(1)

     zslDeleteNode(zsl, x, update); // 已知目标节点每一层的前置节点,删除目标节点

     // T = O(1)

     zslFreeNode(x); // 释放目标节点内存

     return 1;

 } else { // 目标节点与obj不匹配

     return 0; /* not found */

 }

 return 0; /* not found */

}

// update数组存储着要删除的节点x的前置节点

void zslDeleteNode(zskiplist *zsl, zskiplistNode *x, zskiplistNode **update) {

 int i;

 // 更新所有和被删除节点 x 有关的节点的指针,解除它们之间的关系

 // T = O(1)

 for (i = 0; i < zsl->level; i++) {

     if (update[i]->level[i].forward == x) {  // update[i]是第i层在x前面的节点而且是前置节点

         update[i]->level[i].span += x->level[i].span - 1; // 更新前置节点的span

         update[i]->level[i].forward = x->level[i].forward; // 更新前置节点的forward

     } else {  // update[i]是第i层在x前面的节点,没有和x建立连接

         update[i]->level[i].span -= 1;  // 减去中间少的1个

     }

 }

 // 更新被删除节点 x 的前进和后退指针

 if (x->level[0].forward) {

     x->level[0].forward->backward = x->backward;

 } else { // x是尾部节点

     zsl->tail = x->backward;

 }

 // 更新跳跃表最大层数(只在被删除节点是跳跃表中最高的节点时才执行)

 // T = O(1)

 while(zsl->level > 1 && zsl->header->level[zsl->level-1].forward == NULL)

     zsl->level--;

 // 跳跃表节点计数器减一

 zsl->length--;

}
redis源码学习-skiplist的更多相关文章
- Redis源码学习:字符串
Redis源码学习:字符串 1.初识SDS 1.1 SDS定义 Redis定义了一个叫做sdshdr(SDS or simple dynamic string)的数据结构.SDS不仅用于 保存字符串, ...
- Redis源码学习:Lua脚本
Redis源码学习:Lua脚本 1.Sublime Text配置 我是在Win7下,用Sublime Text + Cygwin开发的,配置方法请参考<Sublime Text 3下C/C++开 ...
- redis源码学习之slowlog
目录 背景 环境说明 redis执行命令流程 记录slowlog源码分析 制造一条slowlog slowlog分析 1.slowlog如何开启 2.slowlog数量限制 3.slowlog中的耗时 ...
- 柔性数组(Redis源码学习)
柔性数组(Redis源码学习) 1. 问题背景 在阅读Redis源码中的字符串有如下结构,在sizeof(struct sdshdr)得到结果为8,在后续内存申请和计算中也用到.其实在工作中有遇到过这 ...
- __sync_fetch_and_add函数(Redis源码学习)
__sync_fetch_and_add函数(Redis源码学习) 在学习redis-3.0源码中的sds文件时,看到里面有如下的C代码,之前从未接触过,所以为了全面学习redis源码,追根溯源,学习 ...
- redis源码学习之工作流程初探
目录 背景 环境准备 下载redis源码 下载Visual Studio Visual Studio打开redis源码 启动过程分析 调用关系图 事件循环分析 工作模型 代码分析 动画演示 网络模块 ...
- redis源码学习之lua执行原理
聊聊redis执行lua原理 从一次面试场景说起 "看你简历上写的精通redis" "额,还可以啦" "那你说说redis执行lua脚本的原理&q ...
- Redis源码学习-Master&Slave的命令交互
0. 写在前面 Version Redis2.2.2 Redis中可以支持主从结构,本文主要从master和slave的心跳机制出发(PING),分析redis的命令行交互. 在Redis中,serv ...
- Redis源码学习1-sds.c
https://github.com/huangz1990/redis-3.0-annotated/blob/unstable/src/sds.c#L120 /* SDSLib, A C dynami ...
随机推荐
- 机器学习之Apriori算法和FP-growth算法
1 关联分析 无监督机器学习方法中的关联分析问题.关联分析可以用于回答"哪些商品经常被同时购买?"之类的问题. 2 Apriori算法 频繁项集即出现次数多的数据集 支持度 ...
- MySQL中数据的基本查询方式
1.查询所有列 select * from 表名称; 2.查询指定列 select 字段名,字段名,字段名 from 表名称; 3.查询时添加常量列(临时备注) select 字段名,字段名,字段名, ...
- POJ2061 Subsequence 2017-05-25 19:49 83人阅读 评论(0) 收藏
Subsequence Time Limit: 1000MS Memory Limit: 65536K Total Submissions: 14709 Accepted: 6210 Desc ...
- ASP.NET MVC Owin 基本理解
一.OWIN OWIN(Open Web Interface for .Net),定义了一个服务器(IIS)和Web应用程序(MVC,Webform)通信的标准接口,并且通过抽象层使得这两个在微软平台 ...
- JAVA的初始化顺序
这里主要是介绍JAVA的类的初始化顺序,比较基础:主要是以例子演示为主: 例子一: 1 package com.cnblog.GDUTtiantian; 2 3 /** 4 * 5 * @author ...
- Linux下SVN配置hook经验总结
前几天给实验室搭建了一个内部测试的开发环境,LAMP.svn提交以及自动部署. 之前没干过这事儿,到最终搞定还是颇费了些周折.总结一下我的经验,主要是hook的自动执行问题. 拿我的post-comm ...
- nips 2016 吴恩达
一年一度的 NIPS 又来了.今年举办地是笔者最爱的欧洲城市巴塞罗那.阳光沙滩配学术,确实很爽.这次的会议的第一天开场的大部分时间安排给了 tutorial.其中人数爆满的依旧是吴恩达(AndrewN ...
- 【转载】Configure the max limit for concurrent TCP connections
转载地址:http://smallvoid.com/article/winnt-tcpip-max-limit.html To keep the TCP/IP stack from taking al ...
- IIS8.0配置网站,错误提示:用户 'IIS APPPOOL\你的网站名称'登录失败
项目在vs2013中能正常运行,配置到服务器(windows2012+IIS8.0),运行提示用户 'IIS APPPOOL\DefaultAppPool' 登录失败. 解决方案: 比如我的网站取名m ...
- Http/Https抓包工具Charles最新版破解教程(Windows|Mac)
Charles介绍 Charles是一款强大的http/https抓包工具,可以抓取各种数据请求,查看请求的头信息,请求信息,返回信息等.本文主要介绍Charles的破解过程,包括Windows平台和 ...