
Mongodb副本集+分片集群环境部署记录
前面详细介绍了mongodb的副本集和分片的原理,这里就不赘述了。下面记录Mongodb副本集+分片集群环境部署过程:
MongoDB Sharding Cluster,需要三种角色:
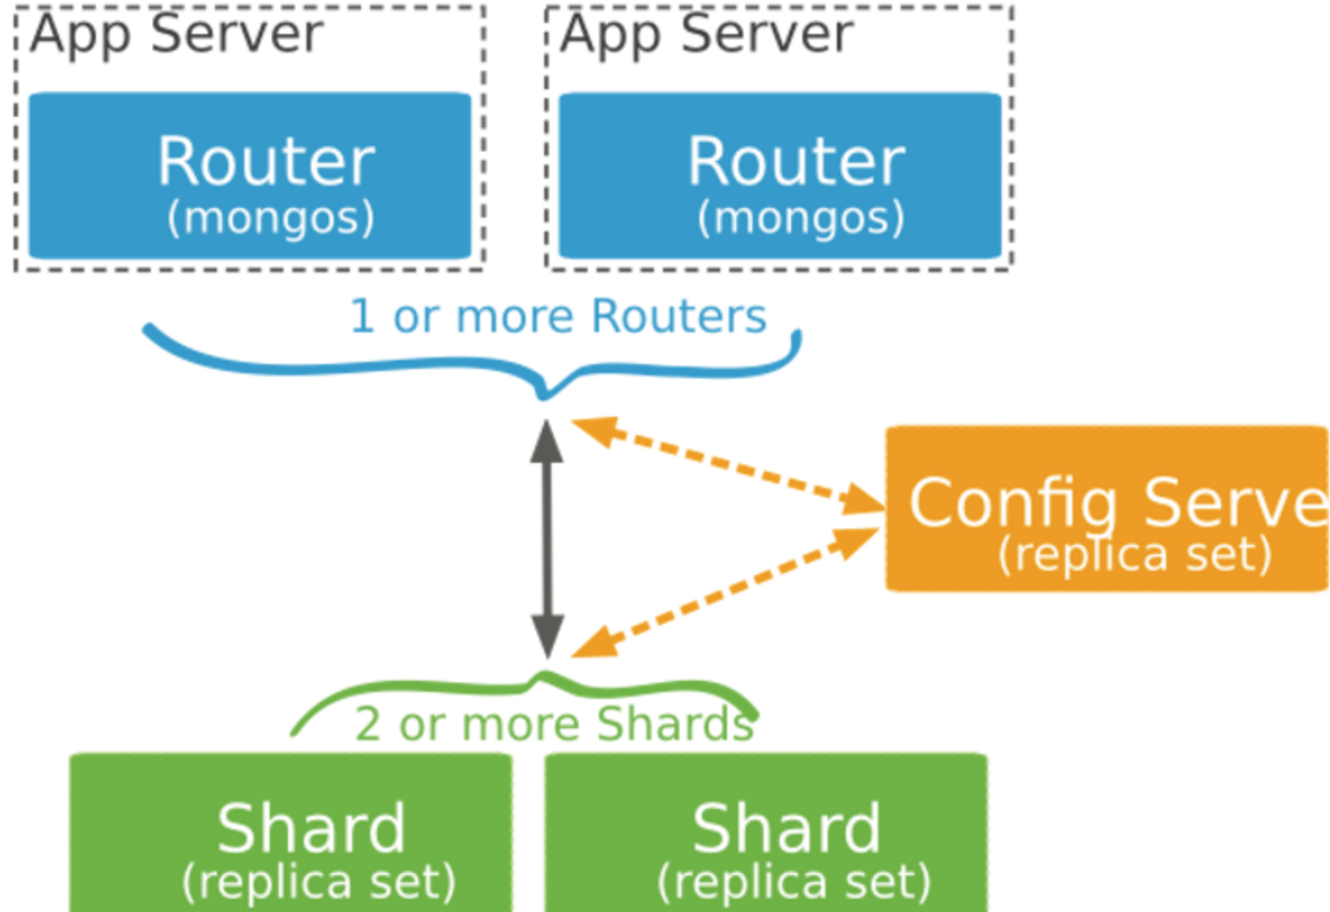
Shard Server: mongod 实例,用于存储实际的数据块,实际生产环境中一个shard server角色可由几台机器组个一个relica set承担,防止主机单点故障
Config Server: mongod 实例,存储了整个 Cluster Metadata,其中包括 chunk 信息。
Route Server: mongos 实例,前端路由,客户端由此接入,且让整个集群看上去像单一数据库,前端应用可以透明使用。
机器信息:
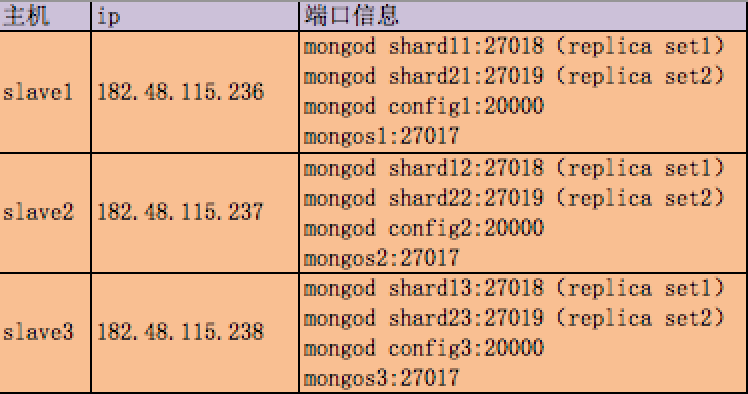
分别在3台机器运行一个mongod实例(称为mongod shard11,mongod shard12,mongod shard13)组织replica set1,作为cluster的shard1
分别在3台机器运行一个mongod实例(称为mongod shard21,mongod shard22,mongod shard23)组织replica set2,作为cluster的shard2
每台机器运行一个mongod实例,作为3个config server
每台机器运行一个mongos进程,用于客户端连接
1)安装mongodb (3台机器都要操作)

下载地址:https://pan.baidu.com/s/1hsoVcpQ           提取密码:6zp4

[root@slave1 src]# cd

[root@slave1 ~]# cd /usr/local/src/

[root@slave1 src]# ll mongodb-linux-x86_64-rhel62-3.0.6.tgz

[root@slave1 src]# tar -zvxf mongodb-linux-x86_64-rhel62-3.0.6.tgz

[root@slave1 src]# mv mongodb-linux-x86_64-rhel62-3.0.6 mongodb

2)创建sharding数据目录

根据本例sharding架构图所示,在各台sever上创建shard数据文件目录

slave1

[root@slave1 src]# mkdir /home/services/

[root@slave1 src]# mv mongodb /home/services/

[root@slave1 src]# cd /home/services/mongodb/

[root@slave1 mongodb]# mkdir -p data/shard11

[root@slave1 mongodb]# mkdir -p data/shard21

slave2

[root@slave2 src]# mkdir /home/services/

[root@slave2 src]# mv mongodb /home/services/

[root@slave2 src]# cd /home/services/mongodb/

[root@slave2 mongodb]# mkdir -p data/shard12

[root@slave2 mongodb]# mkdir -p data/shard22

slave3

[root@slave3 src]# mkdir /home/services/

[root@slave3 src]# mv mongodb /home/services/

[root@slave3 src]# cd /home/services/mongodb/

[root@slave3 mongodb]# mkdir -p data/shard13

[root@slave3 mongodb]# mkdir -p data/shard23

3)配置relica sets

3.1)配置shard1所用到的replica sets 1:

slave1

[root@slave1 ~]# /home/services/mongodb/bin/mongod --shardsvr --replSet shard1 --port 27018 --dbpath /home/services/mongodb/data/shard11 --oplogSize 100 --logpath /home/services/mongodb/data/shard11.log --logappend --fork

slave2

[root@slave2 ~]# /home/services/mongodb/bin/mongod --shardsvr --replSet shard1 --port 27018 --dbpath /home/services/mongodb/data/shard12 --oplogSize 100 --logpath /home/services/mongodb/data/shard12.log --logappend --fork

slave3

[root@slave3 ~]# /home/services/mongodb/bin/mongod --shardsvr --replSet shard1 --port 27018 --dbpath /home/services/mongodb/data/shard13 --oplogSize 100 --logpath /home/services/mongodb/data/shard13.log --logappend --fork

检车各个机器上的mongod进程是否正常起来了(ps -ef|grep mongod),27018端口是否正常起来了

3.2)初始化replica set 1

从3台机器中任意找一台,连接mongod

[root@slave1 ~]# /home/services/mongodb/bin/mongo --port 27018

......

> config = {"_id" : "shard1","members" : [{"_id" : 0,"host" : "182.48.115.236:27018"},{"_id" : 1,"host" : "182.48.115.237:27018"},{"_id" : 2,"host" : "182.48.115.238:27018"}]}

{

  "_id" : "shard1",

  "members" : [

    {

      "_id" : 0,

      "host" : "182.48.115.236:27018"

    },

    {

      "_id" : 1,

      "host" : "182.48.115.237:27018"

    },

    {

      "_id" : 2,

      "host" : "182.48.115.238:27018"

    }

  ]

}

> rs.initiate(config);

{ "ok" : 1 }

3.3)配置shard2所用到的replica sets 2:

slave1

[root@slave1 ~]# /home/services/mongodb//bin/mongod --shardsvr --replSet shard2 --port 27019 --dbpath /home/services/mongodb/data/shard21 --oplogSize 100 --logpath /home/services/mongodb/data/shard21.log --logappend --fork

slave2

[root@slave2 ~]# /home/services/mongodb//bin/mongod --shardsvr --replSet shard2 --port 27019 --dbpath /home/services/mongodb/data/shard22 --oplogSize 100 --logpath /home/services/mongodb/data/shard22.log --logappend --fork

slave3

[root@slave3 ~]# /home/services/mongodb//bin/mongod --shardsvr --replSet shard2 --port 27019 --dbpath /home/services/mongodb/data/shard23 --oplogSize 100 --logpath /home/services/mongodb/data/shard23.log --logappend --fork

3.4)初始化replica set 2

从3台机器中任意找一台,连接mongod

[root@slave1 ~]# /home/services/mongodb/bin/mongo --port 27019

......

> config = {"_id" : "shard2","members" : [{"_id" : 0,"host" : "182.48.115.236:27019"},{"_id" : 1,"host" : "182.48.115.237:27019"},{"_id" : 2,"host" : "182.48.115.238:27019"}]}

{

  "_id" : "shard2",

  "members" : [

    {

      "_id" : 0,

      "host" : "182.48.115.236:27019"

    },

    {

      "_id" : 1,

      "host" : "182.48.115.237:27019"

    },

    {

      "_id" : 2,

      "host" : "182.48.115.238:27019"

    }

  ]

}

> rs.initiate(config);

{ "ok" : 1 }

4)配置三台config server

slave1

[root@slave1 ~]# mkdir -p /home/services/mongodb/data/config

[root@slave1 ~]# /home/services/mongodb//bin/mongod --configsvr --dbpath /home/services/mongodb/data/config --port 20000 --logpath /home/services/mongodb/data/config.log --logappend --fork

slave2

[root@slave2 ~]# mkdir -p /home/services/mongodb/data/config

[root@slave2 ~]# /home/services/mongodb//bin/mongod --configsvr --dbpath /home/services/mongodb/data/config --port 20000 --logpath /home/services/mongodb/data/config.log --logappend --fork

slave3

[root@slave3 ~]# mkdir -p /home/services/mongodb/data/config

[root@slave3 ~]# /home/services/mongodb//bin/mongod --configsvr --dbpath /home/services/mongodb/data/config --port 20000 --logpath /home/services/mongodb/data/config.log --logappend --fork

5)配置mongs

在三台机器上分别执行:

slave1

[root@slave1 ~]# /home/services/mongodb/bin/mongos --configdb 182.48.115.236:20000,182.48.115.237:20000,182.48.115.238:20000 --port 27017 --chunkSize 5 --logpath /home/services/mongodb/data/mongos.log --logappend --fork

slave2

[root@slave2 ~]# /home/services/mongodb/bin/mongos --configdb 182.48.115.236:20000,182.48.115.237:20000,182.48.115.238:20000 --port 27017 --chunkSize 5 --logpath /home/services/mongodb/data/mongos.log --logappend --fork

slave3

[root@slave3 ~]# /home/services/mongodb/bin/mongos --configdb 182.48.115.236:20000,182.48.115.237:20000,182.48.115.238:20000 --port 27017 --chunkSize 5 --logpath /home/services/mongodb/data/mongos.log --logappend --fork

注意:新版版的mongodb的mongos命令里就不识别--chunkSize参数了

6)配置分片集群(Configuring the Shard Cluster)

从3台机器中任意找一台,连接mongod,并切换到admin数据库做以下配置

6.1)连接到mongs,并切换到admin

[root@slave1 ~]# /home/services/mongodb/bin/mongo 182.48.115.236:27017/admin

......

mongos> db

admin

mongos>

6.2)加入shards分区

如里shard是单台服务器,用"db.runCommand( { addshard : “[:]” } )"这样的命令加入

如果shard是replica sets,用"replicaSetName/[:port][,serverhostname2[:port],…]"这样的格式表示,例如本例执行:

mongos> db.runCommand( { addshard:"shard1/182.48.115.236:27018,182.48.115.237:27018,182.48.115.238:27018",name:"s1",maxsize:20480});

{ "shardAdded" : "s1", "ok" : 1 }

mongos> db.runCommand( { addshard:"shard2/182.48.115.236:27019,182.48.115.237:27019,182.48.115.238:27019",name:"s2",maxsize:20480});

{ "shardAdded" : "s2", "ok" : 1 }

注意:

可选参数

Name:用于指定每个shard的名字,不指定的话系统将自动分配

maxSize:指定各个shard可使用的最大磁盘空间,单位megabytes

6.3)Listing shards

mongos> db.runCommand( { listshards : 1 } )

{

        "shards" : [

                {

                        "_id" : "s1",

                        "host" : "shard1/182.48.115.236:27018,182.48.115.237:27018,182.48.115.238:27018"

                },

                {

                        "_id" : "s2",

                        "host" : "shard2/182.48.115.236:27019,182.48.115.237:27019,182.48.115.238:27019"

                }

        ],

        "ok" : 1

}

mongos>

上面命令列出了以上二个添加的shards,表示shards已经配置成功

6.4)激活数据库分片

命令:

db.runCommand( { enablesharding : “” } );

通过执行以上命令,可以让数据库跨shard,如果不执行这步,数据库只会存放在一个shard,一旦激活数据库分片,数据库中不同的collection将被存放在不同的shard上,

但一个collection仍旧存放在同一个shard上,要使单个collection也分片,还需单独对collection作些操作

Collecton分片

要使单个collection也分片存储,需要给collection指定一个分片key,通过以下命令操作:

db.runCommand( { shardcollection : “”,key : });

注意:

a)分片的collection系统会自动创建一个索引(也可用户提前创建好)

b)分片的collection只能有一个在分片key上的唯一索引,其它唯一索引不被允许

本案例:

mongos> db.runCommand({enablesharding:"test2"});

{ "ok" : 1 }

mongos> db.runCommand( { shardcollection : "test2.books", key : { id : 1 } } );

{ "collectionsharded" : "test2.books", "ok" : 1 }

mongos> use test2

switched to db test2

mongos> db.stats();

{

        "raw" : {

                "shard1/182.48.115.236:27018,182.48.115.237:27018,182.48.115.238:27018" : {

                        "db" : "test2",

                        "collections" : 3,

                        "objects" : 6,

                        "avgObjSize" : 69.33333333333333,

                        "dataSize" : 416,

                        "storageSize" : 20480,

                        "numExtents" : 3,

                        "indexes" : 2,

                        "indexSize" : 16352,

                        "fileSize" : 67108864,

                        "nsSizeMB" : 16,

                        "extentFreeList" : {

                                "num" : 0,

                                "totalSize" : 0

                        },

                        "dataFileVersion" : {

                                "major" : 4,

                                "minor" : 22

                        },

                        "ok" : 1,

                        "$gleStats" : {

                                "lastOpTime" : Timestamp(0, 0),

                                "electionId" : ObjectId("586286596422d63aa9f9f000")

                        }

                },

                "shard2/182.48.115.236:27019,182.48.115.237:27019,182.48.115.238:27019" : {

                        "db" : "test2",

                        "collections" : 0,

                        "objects" : 0,

                        "avgObjSize" : 0,

                        "dataSize" : 0,

                        "storageSize" : 0,

                        "numExtents" : 0,

                        "indexes" : 0,

                        "indexSize" : 0,

                        "fileSize" : 0,

                        "ok" : 1

                }

        },

        "objects" : 6,

        "avgObjSize" : 69,

        "dataSize" : 416,

        "storageSize" : 20480,

        "numExtents" : 3,

        "indexes" : 2,

        "indexSize" : 16352,

        "fileSize" : 67108864,

        "extentFreeList" : {

                "num" : 0,

                "totalSize" : 0

        },

        "ok" : 1

}

mongos> db.books.stats();

{

        "sharded" : true,

        "paddingFactorNote" : "paddingFactor is unused and unmaintained in 3.0. It remains hard coded to 1.0 for c                                        ompatibility only.",

        "userFlags" : 1,

        "capped" : false,

        "ns" : "test2.books",

        "count" : 0,

        "numExtents" : 1,

        "size" : 0,

        "storageSize" : 8192,

        "totalIndexSize" : 16352,

        "indexSizes" : {

                "_id_" : 8176,

                "id_1" : 8176

        },

        "avgObjSize" : 0,

        "nindexes" : 2,

        "nchunks" : 1,

        "shards" : {

                "s1" : {

                        "ns" : "test2.books",

                        "count" : 0,

                        "size" : 0,

                        "numExtents" : 1,

                        "storageSize" : 8192,

                        "lastExtentSize" : 8192,

                        "paddingFactor" : 1,

                        "paddingFactorNote" : "paddingFactor is unused and unmaintained in 3.0. It remains hard co                                        ded to 1.0 for compatibility only.",

                        "userFlags" : 1,

                        "capped" : false,

                        "nindexes" : 2,

                        "totalIndexSize" : 16352,

                        "indexSizes" : {

                                "_id_" : 8176,

                                "id_1" : 8176

                        },

                        "ok" : 1,

                        "$gleStats" : {

                                "lastOpTime" : Timestamp(0, 0),

                                "electionId" : ObjectId("586286596422d63aa9f9f000")

                        }

                }

        },

        "ok" : 1

}

7)测试

mongos> for (var i = 1; i <= 20000; i++) db.books.save({id:i,name:"12345678",sex:"male",age:27,value:"test"});

WriteResult({ "nInserted" : 1 })

mongos> db.books.stats();

{

        "sharded" : true,

        "paddingFactorNote" : "paddingFactor is unused and unmaintained in 3.0. It remains hard coded to 1.0 for compatibility only.",

        "userFlags" : 1,

        "capped" : false,

        "ns" : "test2.books",

        "count" : 20000,

        "numExtents" : 10,

        "size" : 2240000,

        "storageSize" : 5586944,

        "totalIndexSize" : 1250928,

        "indexSizes" : {

                "_id_" : 670432,

                "id_1" : 580496

        },

        "avgObjSize" : 112,

        "nindexes" : 2,

        "nchunks" : 5,

        "shards" : {

                "s1" : {

                        "ns" : "test2.books",

                        "count" : 12300,

                        "size" : 1377600,

                        "avgObjSize" : 112,

                        "numExtents" : 5,

                        "storageSize" : 2793472,

                        "lastExtentSize" : 2097152,

                        "paddingFactor" : 1,

                        "paddingFactorNote" : "paddingFactor is unused and unmaintained in 3.0. It remains hard coded to 1.0 for compatibility only.",

                        "userFlags" : 1,

                        "capped" : false,

                        "nindexes" : 2,

                        "totalIndexSize" : 760368,

                        "indexSizes" : {

                                "_id_" : 408800,

                                "id_1" : 351568

                        },

                        "ok" : 1,

                        "$gleStats" : {

                                "lastOpTime" : Timestamp(0, 0),

                                "electionId" : ObjectId("586286596422d63aa9f9f000")

                        }

                },

                "s2" : {

                        "ns" : "test2.books",

                        "count" : 7700,

                        "size" : 862400,

                        "avgObjSize" : 112,

                        "numExtents" : 5,

                        "storageSize" : 2793472,

                        "lastExtentSize" : 2097152,

                        "paddingFactor" : 1,

                        "paddingFactorNote" : "paddingFactor is unused and unmaintained in 3.0. It remains hard coded to 1.0 for compatibility only.",

                        "userFlags" : 1,

                        "capped" : false,

                        "nindexes" : 2,

                        "totalIndexSize" : 490560,

                        "indexSizes" : {

                                "_id_" : 261632,

                                "id_1" : 228928

                        },

                        "ok" : 1,

                        "$gleStats" : {

                                "lastOpTime" : Timestamp(0, 0),

                                "electionId" : ObjectId("58628704f916bb05014c5ea7")

                        }

                }

        },

        "ok" : 1

}
Mongodb副本集+分片集群环境部署记录的更多相关文章
- kafka 基础知识梳理及集群环境部署记录
一.kafka基础介绍 Kafka是最初由Linkedin公司开发,是一个分布式.支持分区的(partition).多副本的(replica),基于zookeeper协调的分布式消息系统,它的最大的特 ...
- Centos7.5基于MySQL5.7的 InnoDB Cluster 多节点高可用集群环境部署记录
一. MySQL InnoDB Cluster 介绍MySQL的高可用架构无论是社区还是官方,一直在技术上进行探索,这么多年提出了多种解决方案,比如MMM, MHA, NDB Cluster, G ...
- ProxySQL Cluster 高可用集群环境部署记录
ProxySQL在早期版本若需要做高可用,需要搭建两个实例,进行冗余.但两个ProxySQL实例之间的数据并不能共通,在主实例上配置后,仍需要在备用节点上进行配置,对管理来说非常不方便.但是Proxy ...
- Centos7下ELK+Redis日志分析平台的集群环境部署记录
之前的文档介绍了ELK架构的基础知识,日志集中分析系统的实施方案:- ELK+Redis- ELK+Filebeat - ELK+Filebeat+Redis- ELK+Filebeat+Kafka+ ...
- 关于MongoDB副本集和分片集群有关用户和权限的说明分析
1.MongoDB副本集 可以先创建超管用户,然后再关闭服务,创建密钥文件,修改配置文件,启动服务,使用超管用户登录验证,然后创建普通用户 2.MongoDB分片集群 先关闭服务,创建密钥文件,修改配 ...
- Centos7下GlusterFS分布式存储集群环境部署记录
0)环境准备 GlusterFS至少需要两台服务器搭建,服务器配置最好相同,每个服务器两块磁盘,一块是用于安装系统,一块是用于GlusterFS. 192.168.10.239 GlusterFS-m ...
- Mongodb副本集+分片集群环境部署
前面详细介绍了mongodb的副本集和分片的原理,这里就不赘述了.下面记录Mongodb副本集+分片集群环境部署过程: MongoDB Sharding Cluster,需要三种角色: Shard S ...
- Mongodb主从复制/ 副本集/分片集群介绍
前面的文章介绍了Mongodb的安装使用,在 MongoDB 中,有两种数据冗余方式,一种 是 Master-Slave 模式(主从复制),一种是 Replica Sets 模式(副本集). Mong ...
- mongoDB副本集+分片集群
首先搭建一个副本集(三台机器) 主,从,仲裁 然后搭建分片shard1,在每台机子上启用shard1(这里就写一个分片吧!!如果写多了怕初学者会混乱,先写一个.然后可以按照同样的方法写第二个,第三个) ...
随机推荐
- 描述性统计的matlab实现
理论讲的再多不会做也白弄 直接上手 一.针对接近正态分布的(均值,方差,标准差,极差,变异系数,偏度,峰度) 这里我必须提前说明一点就是,你在写好函数后,函数的名是dts,你保存的文件名也必须是dts ...
- Git永久删除文件和历史记录
目录 Git永久删除文件和历史记录 使用filter-branch 添加到.gitignore文件里并push修改后的repo 清理和回收空间 Git永久删除文件和历史记录 造成你想从git存储库中永 ...
- C++中int型与string型互相转换(转)
http://greatverve.cnblogs.com/archive/2012/10/24/cpp-int-string.html 本以为这么多年C#经验,学个C++没多难,现在发现错了.C++ ...
- 通过css3,实现加载转动贝塞尔曲线动画
参考博客:http://blog.jobbole.com/94966/ css代码: .loading { position : relative; display : inline-block; w ...
- 2018-2019-2 网络对抗技术 20165318 Exp5 MSF基础应用
2018-2019-2 网络对抗技术 20165318 Exp5 MSF基础应用 原理与实践说明 实践原理 实践内容概述 基础问题回答 攻击实例 主动攻击的实践 ms08_067_netapi:自动化 ...
- LCA转换成RMQ
LCA(Lowest Common Ancestor 最近公共祖先)定义如下:在一棵树中两个节点的LCA为这两个节点所有的公共祖先中深度最大的节点. 比如这棵树 结点5和6的LCA是2,12和7的LC ...
- 2080 特殊的质数肋骨 USACO (深度优先搜索)
农民约翰的母牛总是产生最好的肋骨. 你能通过农民约翰和美国农业部标记在每根肋骨上的数字认出它们. 农民约翰确定他卖给买方的是真正的质数肋骨,是因为从右边开始切下肋骨,每次还剩下的肋骨上的数字都组成一个 ...
- Linux下rz/sz安装及使用方法
新搞的云服务器用SecureCRT不支持上传和下载,没有找到rz命令.记录一下如何安装rz/sz命令的方法. 一.工具说明 在SecureCRT这样的ssh登录软件里, 通过在Linux界面里输入rz ...
- JavaScript高级程序设计学习(六)之设计模式
每种编程语言都有其自己的设计模式.不禁让人疑惑设计模式是用来做什么?有什么用? 简单的说,设计模式是为了让代码更简洁,更优雅,更完美. 同时设计模式也会让软件的性能更好,同时也会让程序员们更轻松.设计 ...
- PAT A1012 The Best Rank (25 分)——多次排序,排名
To evaluate the performance of our first year CS majored students, we consider their grades of three ...