
RDD的缓存
RDD的缓存/持久化
缓存解决的问题
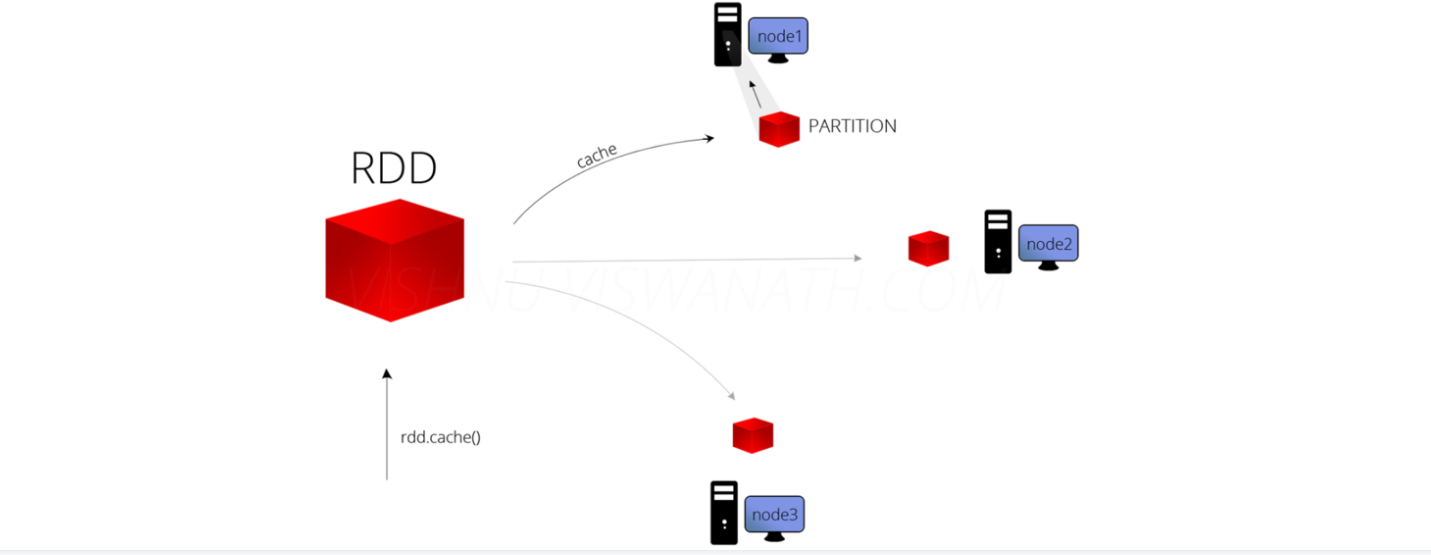
缓存解决什么问题?-解决的是热点数据频繁访问的效率问题
在Spark开发中某些RDD的计算或转换可能会比较耗费时间,
如果这些RDD后续还会频繁的被使用到,那么可以将这些RDD进行持久化/缓存,
这样下次再使用到的时候就不用再重新计算了,提高了程序运行的效率。
import org.apache.spark.rdd.RDD

import org.apache.spark.storage.StorageLevel

import org.apache.spark.{SparkConf, SparkContext}

object Demo16Cache {

  def main(args: Array[String]): Unit = {

    val conf: SparkConf = new SparkConf().setAppName("****").setMaster("local")

    val sc: SparkContext = new SparkContext(conf)

    val linesRDD: RDD[String] = sc.textFile("spark/data/words.txt")

    //加入缓存的三种方式

    //方式一

    linesRDD.cache()//将常用的RDD放入缓存中,增加效率

    //StorageLevel.MEMORY_ONLY 默认只放在缓存中

    //方式二

    //linesRDD.persist()

    //def persist(): this.type = persist(StorageLevel.MEMORY_ONLY)

    //指定缓存存储方式

    linesRDD.persist(StorageLevel.MEMORY_AND_DISK)

    /**

     * 缓存的存储方式:推荐使用MEMORY_AND_DISK

     * object StorageLevel {

     * val NONE = new StorageLevel(false, false, false, false)

     * val DISK_ONLY = new StorageLevel(true, false, false, false)

     * val DISK_ONLY_2 = new StorageLevel(true, false, false, false, 2)

     * val MEMORY_ONLY = new StorageLevel(false, true, false, true)

     * val MEMORY_ONLY_2 = new StorageLevel(false, true, false, true, 2)

     * val MEMORY_ONLY_SER = new StorageLevel(false, true, false, false)

     * val MEMORY_ONLY_SER_2 = new StorageLevel(false, true, false, false, 2)

     * val MEMORY_AND_DISK = new StorageLevel(true, true, false, true)

     * val MEMORY_AND_DISK_2 = new StorageLevel(true, true, false, true, 2)

     * val MEMORY_AND_DISK_SER = new StorageLevel(true, true, false, false)

     * val MEMORY_AND_DISK_SER_2 = new StorageLevel(true, true, false, false, 2)

     * val OFF_HEAP = new StorageLevel(true, true, true, false, 1)

     */

    linesRDD.flatMap(word => word)

      .groupBy(word => word)

      .map(l => {

        val word = l._1

        val cnt = l._2.size

        word + "," + cnt

      }).foreach(println)

    val wordRDD: Unit = linesRDD.map(word => word)

        .foreach(println)

    //释放缓存

    linesRDD.unpersist()

  }

}
RDD中的checkpoint
RDD数据可以持久化到内存中,虽然是快速的,但是不可靠
也可以把数据放在磁盘上,也并不是完全可靠的,
我们可以把缓存数据放到我的HDFS中,借助HDFS的高可靠,高可用以及高容错来保证数据安全
import org.apache.spark.{SparkConf, SparkContext}

import org.apache.spark.rdd.RDD

import org.apache.spark.storage.StorageLevel

object Demo17CheckPoint {

  def main(args: Array[String]): Unit = {

    val conf: SparkConf = new SparkConf().setAppName("spark").setMaster("local")

    val sc: SparkContext = new SparkContext(conf)

    val linesRDD: RDD[String] = sc.textFile("spark/data/words.txt")

    /**

     * RDD数据可以持久化到内存中,虽然是快速的,但是不可靠

     * 也可以把数据放在磁盘上,也并不是完全可靠的

     * 我们可以把缓存数据放到我的HDFS中,借助HDFS的高可靠,高可用以及高容错来保证数据安全

     *

     */

    //设置HDFS的目录

    sc.setCheckpointDir("spark/data/checkPoint")

    //对需要缓存的RDD进行checkPoint

    linesRDD.checkpoint()

    linesRDD.flatMap(word => word)

      .groupBy(word => word)

      .map(l => {

        val word = l._1

        val cnt = l._2.size

        word + "," + cnt

      }).foreach(println)

    val wordRDD: Unit = linesRDD.map(word => word)

      .foreach(println)

  }

}
RDD的缓存的更多相关文章
- Spark RDD概念学习系列之RDD的缓存(八)
RDD的缓存 RDD的缓存和RDD的checkpoint的区别 缓存是在计算结束后,直接将计算结果通过用户定义的存储级别(存储级别定义了缓存存储的介质,现在支持内存.本地文件系统和Tachyon) ...
- sparkRDD:第4节 RDD的依赖关系;第5节 RDD的缓存机制;第6节 DAG的生成
4. RDD的依赖关系 6.1 RDD的依赖 RDD和它依赖的父RDD的关系有两种不同的类型,即窄依赖(narrow dependency)和宽依赖(wide dependency ...
- RDD(八)——缓存与检查点
RDD通过persist方法或cache方法可以将前面的计算结果缓存,默认情况下 persist() 会把数据以序列化的形式缓存在 JVM 的堆空间中. 但是并不是这两个方法被调用时立即缓存,而是触发 ...
- Spark核心RDD、什么是RDD、RDD的属性、创建RDD、RDD的依赖以及缓存、
1:什么是Spark的RDD??? RDD(Resilient Distributed Dataset)叫做弹性分布式数据集,是Spark中最基本的数据抽象,它代表一个不可变.可分区.里面的元素可并行 ...
- RDD缓存
RDD的缓存 Spark速度非常快的原因之一,就是在不同操作中可以在内存中持久化或缓存数据集.当持久化某个RDD后,每一个节点都将把计算的分片结果保存在内存中,并在对此RDD或衍生出的RDD进行的其他 ...
- Spark RDD详解 | RDD特性、lineage、缓存、checkpoint、依赖关系
RDD(Resilient Distributed Datasets)弹性的分布式数据集,又称Spark core,它代表一个只读的.不可变.可分区,里面的元素可分布式并行计算的数据集. RDD是一个 ...
- RDD:基于内存的集群计算容错抽象(转)
原文:http://shiyanjun.cn/archives/744.html 该论文来自Berkeley实验室,英文标题为:Resilient Distributed Datasets: A Fa ...
- Spark RDD Operations(2)
处理数据类型为Value型的Transformation算子可以根据RDD变换算子的输入分区与输出分区关系分为以下几种类型. 1)输入分区与输出分区一对一型. 2)输入分区与输出分区多对一型. 3)输 ...
- Spark RDD概念学习系列之RDD的checkpoint(九)
RDD的检查点 首先,要清楚.为什么spark要引入检查点机制?引入RDD的检查点? 答:如果缓存丢失了,则需要重新计算.如果计算特别复杂或者计算耗时特别多,那么缓存丢失对于整个Job的影响是不容 ...
随机推荐
- 吴恩达-神经网络-week1-hw3
Ref:https://blog.csdn.net/u013733326/article/details/79702148 点击查看代码 from testCases import * from pl ...
- Java 爬取 51job 数据 WebMagic实现
Java 爬取 51job 数据 一.项目Maven环境配置 相关依赖 jar 包配置 <parent> <groupId>org.springframework.boot&l ...
- 设置 SSH 命令行空闲保持会话
楔子 使用 Mac 或 Linux 原生的命令行 ssh user@ip 方式连接 Linux 闲时会自动断开终端卡死. 为解决这个问题,查了到篇博客翻译下关键步骤记录下来.解决方式可以分服务端设置和 ...
- JS中call,apply,bind的区别
1.关于this对象的指向,请看如下代码 var name = 'jack'; var age = 18; var obj = { name:'mary', objAge:this.age, myFu ...
- 数据库MySQL主从-GTID
1.第一步在主服务器上/etc/my.cnf/下添加 log-bin=log-bin server-id=1 gtid_mode=ON enforce_gtid_consistency 2.第二步:重 ...
- CentOS7安装Python3和VIM8
参考:http://blog.sina.com.cn/s/blog_45249ad30102yulz.html
- UOJ 2021 NOI Day2 部分题解
获奖名单 题目传送门 Solution 不难看出,若我们单个 \(x\) 连 \((0,x),(x,0)\),两个连 \((x,y),(y,x)\) ,除去中间过对称轴的一个两个组,就是找很多个欧拉回 ...
- 洛谷4299首都(LCT维护动态重心+子树信息)
这个题目很有意思 QWQ 根据题目描述,我们可以知道,首都就是所谓的树的重心,那么我们假设每颗树的重心都是\(root\)的话,对于每次询问,我们只需要\(findroot(x)\)就可以. 那么如何 ...
- android和IOS自动化定位方法
元素定位 方法:id定位,name定位(text定位),class_name定位, accessibility_id定位,xpath定位等 (目前1.5版本的已经不支持name定位了),所以APP的定 ...
- 深入理解Java虚拟机之类加载机制篇
概述 虚拟机把描述类的数据从 Class 文件加载到内存中,并对数据进行校验.转换解析和初始化,最终形成可以被虚拟机直接使用的Java类型,就是虚拟机的类加载机制. 在Java语言里面,类型的 ...