
A Tutorial on Energy-Based Learning
概
从能量的角度看一些函数, 这里就记录一下这些损失.
主要内容
\(E(Y, X)\)反映了\(X, Y\)的关系, 认为能量越低, 而且的关系越紧密, 从下图中可以发现, \(X, Y\)的组合多种多样.
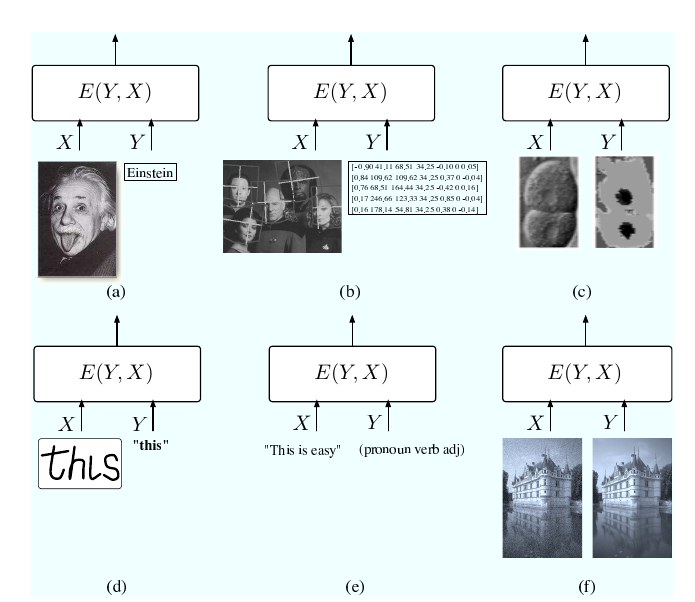
通常情况下, 我们需要训练一个映射, 其参数为\(W\), 一个好的参数可以使得
\]
很小. 不过我们通常会选取一些损失函数, 来间接最小化上面的能量函数
\]
其中\(R(W)\)是正则化项. 自然, 损失函数至少需要满足其最优点是最小化损失函数的, 当然应该还有一些其他的条件.
如果\(\mathcal{Y}\)是离散的, 我们可以令
\]
相应的连续情况下
\]
即\(\bar{Y}\)是我们最不爽的点. 很自然, 我们希望损失函数将我们希望的点\(Y^i\)的能量降低, 而拔高我们讨厌的\(\bar{Y}^i\)的能量.
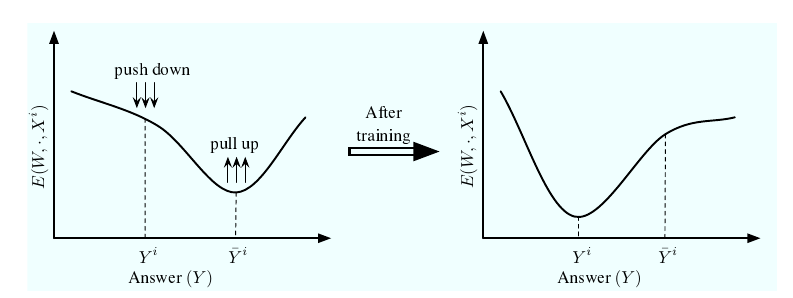
损失函数
Energy Loss
\]
Generalized Perceptron Loss
\]
Generalized Margin Loss
Hinge Loss
\]
Log Loss
\]
LVQ2 Loss
\]
虽然LVQ2 Loss和上面的非margin loss一样, 似乎是没margin的, 但是作者说最后二者有一个饱和的比例\(1+\delta\), 但是不是特别理解.
MCE Loss
\]
其中\(\sigma\)是sigmoid.
Square-Square Loss
\]
Square-Exponential
\]
Negative Log-Likelihood Loss
\]
其中
\]
Empirical Error Loss
\]
好的损失应该满足的一些条件
都是充分条件, 所以不满足也有可能是满足所需要的性质的.
条件1
对于样本\((X^i, Y^i)\), 如果预测满足
\]
则推断结果应当为\(Y^i\).
条件2
对于变量\(Y\)以及样本\((X^i, Y^i)\)和margin \(m\), 若
\]
则推断结果应当为\(Y^i\).
条件3
这个条件就用语言描述吧.
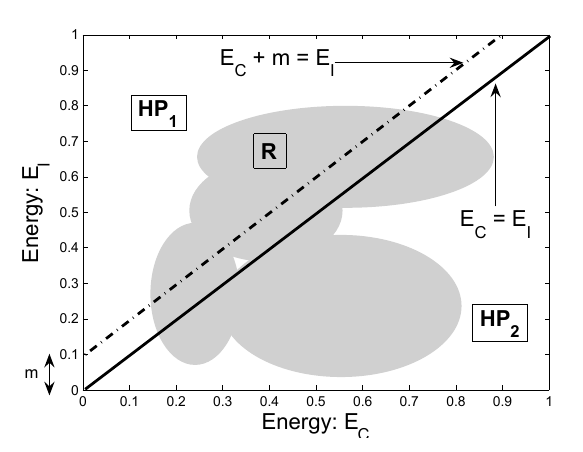
即, 要求\(HP_1\)与可行域\(R\)的交集中存在一解, 是的\((X^i, Y^i)\)在该点处的能量比\(HP_2\)与\(R\)交集的所有解的能量都要小, 其中
HP_2: E_C + m > E_I.
\]
\(E_C=E(W, Y^i, X^i)\), \(E_I=E(W, \bar{Y}^i, X^i)\).
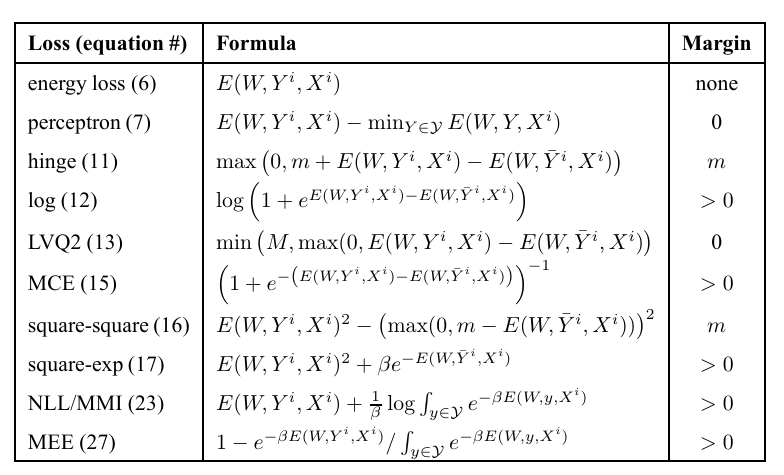
下图给出了满足上述三个条件的损失及其对应的\(m\).
A Tutorial on Energy-Based Learning的更多相关文章
- A Complete Tutorial on Tree Based Modeling from Scratch (in R & Python)
A Complete Tutorial on Tree Based Modeling from Scratch (in R & Python) MACHINE LEARNING PYTHON ...
- 强化学习之 免模型学习(model-free based learning)
强化学习之 免模型学习(model-free based learning) ------ 蒙特卡罗强化学习 与 时序查分学习 ------ 部分节选自周志华老师的教材<机器学习> 由于现 ...
- Tutorial on GoogleNet based image classification --- focus on Inception module and save/load models
Tutorial on GoogleNet based image classification 2018-06-26 15:50:29 本文旨在通过案例来学习 GoogleNet 及其 Incep ...
- Pros and Cons of Game Based Learning
https://www.gamedesigning.org/learn/game-based-learning/ I remember days gone by at elementary schoo ...
- Octave Tutorial(《Machine Learning》)之第一课《数据表示和存储》
Octave Tutorial 第一课 Computation&Operation 数据表示和存储 1.简单的四则运算,布尔运算,赋值运算(a && b,a || b,xor( ...
- Game Based Learning: Why Does it Work?
Forty years of research[i] says yes, games are effective learning tools. People learn from games, an ...
- Octave Tutorial(《Machine Learning》)之第五课《控制语句和方程及向量化》
第五课 控制语句和方程 For,while,if statements and functions (1)For loop v=zeros(10,1) %initial vectors for i=1 ...
- Octave Tutorial(《Machine Learning》)之第四课《绘图数据》
第四课 Plotting Data 绘图数据 t = [0,0.01,0.98]; y1 = sin(2*pi*4*t); y2 = cos(2*pi*4*t); plot(t,y1);(绘制图1) ...
- Octave Tutorial(《Machine Learning》)之第三课《数据计算》
第三课 Culculating Data 数据计算 矩阵计算 1.简单的四则运算 2.相乘除,乘方运算(元素位运算) ".*"为对应元素的相乘计算 "./"为对 ...
- Octave Tutorial(《Machine Learning》)之第二课《数据移动》
第二课 Moving Data 数据移动 常用内置函数 (1)加载文件 load 文件名.dat(或load('文件名.dat')) 接着输入文件名便可查看文件里的数据 (2)显示当前工作空间的所有变 ...
随机推荐
- A Child's History of England.9
But, first, as it was important to know how numerous those pestilent Danes were, and how they were f ...
- Spark(四)【RDD编程算子】
目录 测试准备 一.Value类型转换算子 map(func) mapPartitions(func) mapPartitions和map的区别 mapPartitionsWithIndex(func ...
- Spark的shuffle和MapReduce的shuffle对比
目录 MapperReduce的shuffle Spark的shuffle 总结 MapperReduce的shuffle shuffle阶段划分 Map阶段和Reduce阶段 任务 MapTask和 ...
- ClassLoad类加载器与双亲委派模型
1. 类加载器 Class类描述的是整个类的信息,在Class类中提供的方法getName()是根据ClassPath配置的路径来进行类加载的.若类加载的路径为文件.网络等时则必须进行类加载这是就需要 ...
- 哪里可以下载支付宝demo或者sdk
http://club.alipay.com/read-htm-tid-9976972.html 这里有所有的demo和sdk包括移动产品的demo.在他的论坛里面呢 真心恶心啊.不放到主页.
- show processlist命令详解
1.show processlist; SHOW PROCESSLIST显示哪些线程正在运行.您也可以使用mysqladmin processlist语句得到此信息.如果您有SUPER权限,您可以看到 ...
- Dubbo声明式缓存
为了进一步提高消费者对用户的响应速度,减轻提供者的压力,Dubbo提供了基于结果的声明式缓存.该缓存是基于消费者端的,所以使用很简单,只需修改消费者配置文件,与提供者无关 一.创建消费者07-cons ...
- 【Spring Framework】12种spring中定义bean的方法
前言 在庞大的java体系中,spring有着举足轻重的地位,它给每位开发者带来了极大的便利和惊喜.我们都知道spring是创建和管理bean的工厂,它提供了多种定义bean的方式,能够满足我们日常工 ...
- Spring Batch Event Listeners
Learn to create and configure Spring batch's JobExecutionListener (before and after job), StepExecut ...
- 详解 Java I/O 与装饰者模式
1.I/O分类与装饰者模式 基本java I/O包含两种类型的流,字节流(inputStream.outputStream)与字符流(Writer,Reader),关于I/O操作类的设计,用到了装饰者 ...