请参考 http://spaces.ac.cn/archives/3414/
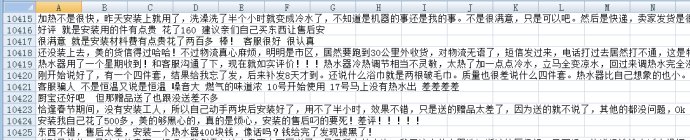
neg.xls是这样的
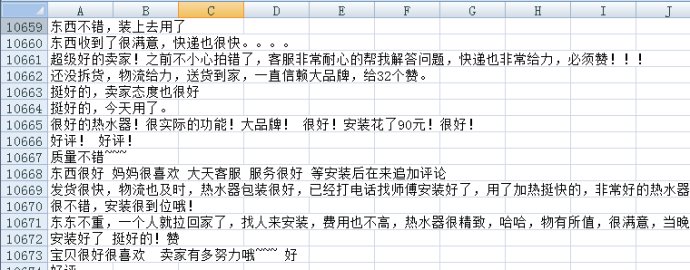
pos.xls是这样的
neg=pd.read_excel(‘neg.xls’,header=None,index=None)
pos=pd.read_excel(‘pos.xls’,header=None,index=None) #读取训练语料完毕
pos[‘mark’]=1
neg[‘mark’]=0 #给训练语料贴上标签
pn=pd.concat([pos,neg],ignore_index=True) #合并语料
neglen=len(neg)
poslen=len(pos) #计算语料数目
cw = lambda x: list(jieba.cut(x)) #定义分词函数
pn[‘words’] = pn[0].apply(cw)
comment = pd.read_excel(‘sum.xls’) #读入评论内容
#comment = pd.read_csv(‘a.csv’, encoding=’utf-8′)
comment = comment[comment[‘rateContent’].notnull()] #仅读取非空评论
comment[‘words’] = comment[‘rateContent’].apply(cw) #评论分词
d2v_train = pd.concat([pn[‘words’], comment[‘words’]], ignore_index = True)
w = [] #将所有词语整合在一起
for i in d2v_train:
w.extend(i)
dict = pd.DataFrame(pd.Series(w).value_counts()) #统计词的出现次数
del w,d2v_train
dict[‘id’]=list(range(1,len(dict)+1))
get_sent = lambda x: list(dict[‘id’][x])
pn[‘sent’] = pn[‘words’].apply(get_sent)
maxlen = 50
print “Pad sequences (samples x time)”
pn[‘sent’] = list(sequence.pad_sequences(pn[‘sent’], maxlen=maxlen))
x = np.array(list(pn[‘sent’]))[::2] #训练集
y = np.array(list(pn[‘mark’]))[::2]
xt = np.array(list(pn[‘sent’]))[1::2] #测试集
yt = np.array(list(pn[‘mark’]))[1::2]
xa = np.array(list(pn[‘sent’])) #全集
ya = np.array(list(pn[‘mark’]))
print ‘Build model…’
model = Sequential()
model.add(Embedding(len(dict)+1, 256))
model.add(LSTM(256, 128)) # try using a GRU instead, for fun
model.add(Dropout(0.5))
model.add(Dense(128, 1))
model.add(Activation(‘sigmoid’))
model.compile(loss=’binary_crossentropy’, optimizer=’adam’, class_mode=”binary”)
print ‘Fit model…’
model.fit(xa, ya, batch_size=32, nb_epoch=4) #训练时间为若干个小时
classes = model.predict_classes(xa)
acc = np_utils.accuracy(classes, ya)
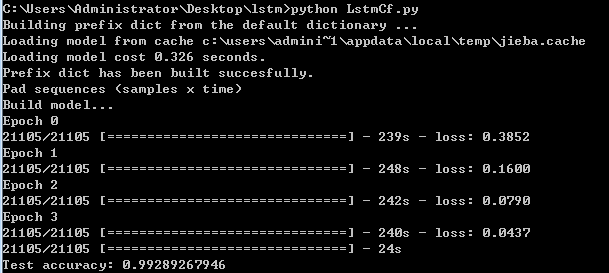
print ‘Test accuracy:’, acc
可以试一试
w = [] #将所有词语整合在一起
for i in d2v_train:
w.extend(i)
newList = list(set(w))
print “newlist len is”
print len(newList)
dict = pd.DataFrame(pd.Series(w).value_counts()) #统计词的出现次数
print type(dict)
print len(dict)
可以发现print len(newList)结果和print len(dict) 也就是说dict的长度就是所有不重复词语的distinct的长度。
主要有一个这个函数 sequence.pad_sequences
https://keras.io/preprocessing/sequence/#pad_sequences
http://www.360doc.com/content/16/0714/10/1317564_575385964.shtml
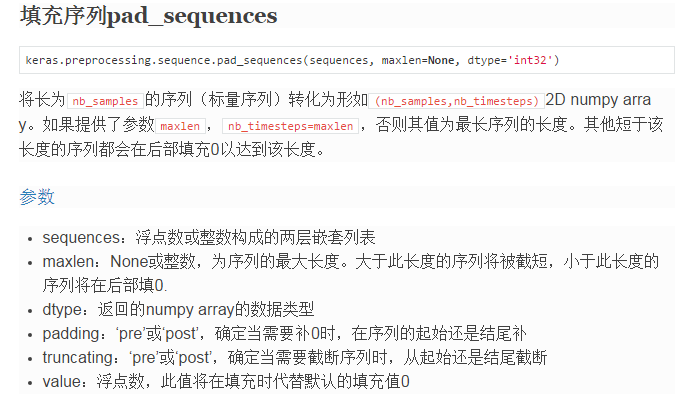
如果指定了参数maxlen,比如这里maxlen为50,那么意思就是这里每句话只截50个单词,后面就不要了,如果一句话不足50个单词,则用0补齐。
首先,Word2Vec 将词语对应一个多维向量,
model.add(Embedding(len(dict)+1, 256))
参数参考 http://www.360doc.com/content/16/0714/09/1317564_575385061.shtml
http://blog.csdn.net/niuwei22007/article/details/49406355
然后
model.add(LSTM(256, 128)) # try using a GRU instead, for fun
model.add(Dropout(0.5))
model.add(Dense(128, 1))
model.add(Activation(‘sigmoid’))
整个流程对应下图

结果
再看一看keras自带的例子:imdb_lstm
maxlen = 100
print(“Pad sequences (samples x time)”)
X_train = sequence.pad_sequences(X_train, maxlen=maxlen)
X_test = sequence.pad_sequences(X_test, maxlen=maxlen)
print(‘X_train shape:’, X_train.shape)
print(‘X_test shape:’, X_test.shape)
print(‘Build model…’)
model = Sequential()
model.add(Embedding(max_features, 128))
model.add(LSTM(128, 128)) # try using a GRU instead, for fun
model.add(Dropout(0.5))
model.add(Dense(128, 1))
model.add(Activation(‘sigmoid’))
同样的道理
如果训练样本较少,为了防止模型过拟合,Dropout可以作为一种trikc供选择。在每个训练批次中,通过忽略一半的特征检测器(让一半的隐层节点值为0),可以明显地减少过拟合现象。这种方式可以减少特征检测器间的相互作用,检测器相互作用是指某些检测器依赖其他检测器才能发挥作用。
- NLP入门(十)使用LSTM进行文本情感分析
情感分析简介 文本情感分析(Sentiment Analysis)是自然语言处理(NLP)方法中常见的应用,也是一个有趣的基本任务,尤其是以提炼文本情绪内容为目的的分类.它是对带有情感色彩的主观性 ...
- LSTM实现中文文本情感分析
1. 背景介绍 文本情感分析是在文本分析领域的典型任务,实用价值很高.本模型是第一个上手实现的深度学习模型,目的是对深度学习做一个初步的了解,并入门深度学习在文本分析领域的应用.在进行模型的上手实现之 ...
- 基于 Spark 的文本情感分析
转载自:https://www.ibm.com/developerworks/cn/cognitive/library/cc-1606-spark-seniment-analysis/index.ht ...
- TensorFlow实现文本情感分析详解
http://c.biancheng.net/view/1938.html 前面我们介绍了如何将卷积网络应用于图像.本节将把相似的想法应用于文本. 文本和图像有什么共同之处?乍一看很少.但是,如果将句 ...
- TensorFlow文本情感分析实现
TensorFlow文本情感分析实现 前面介绍了如何将卷积网络应用于图像.本文将把相似的想法应用于文本. 文本和图像有什么共同之处?乍一看很少.但是,如果将句子或文档表示为矩阵,则该矩阵与其中每个单元 ...
- 文本情感分析(一):基于词袋模型(VSM、LSA、n-gram)的文本表示
现在自然语言处理用深度学习做的比较多,我还没试过用传统的监督学习方法做分类器,比如SVM.Xgboost.随机森林,来训练模型.因此,用Kaggle上经典的电影评论情感分析题,来学习如何用传统机器学习 ...
- 文本情感分析(二):基于word2vec、glove和fasttext词向量的文本表示
上一篇博客用词袋模型,包括词频矩阵.Tf-Idf矩阵.LSA和n-gram构造文本特征,做了Kaggle上的电影评论情感分类题. 这篇博客还是关于文本特征工程的,用词嵌入的方法来构造文本特征,也就是用 ...
- 用python做文本情感分析
情感分析就是分析一句话说得是很主观还是客观描述,分析这句话表达的是积极的情绪还是消极的情绪.原理比如这么一句话:“这手机的画面极好,操作也比较流畅.不过拍照真的太烂了!系统也不好.” ① 情感词 要分 ...
- 【转】用python实现简单的文本情感分析
import jieba import numpy as np # 打开词典文件,返回列表 def open_dict(Dict='hahah',path = r'/Users/zhangzhengh ...
随机推荐
- java自动给版本升级,遇9变0且前面一个版本加1
/** * 自动升级版本号,版本号+1 * @param version * @return */ private String autoUpgradeVersion(String version){ ...
- Mac下彻底清除.DS_Store文件夹
1.先删除整个目录的 sudo find / -name ".DS_Store" -depth -exec rm {} \; 如果你信不过我这句话,那么可以在shell下手动进行r ...
- spring cloud 学习(1) - 基本的SOA示例
有过dubbo/dubbox使用经验的朋友,看到下面这张图,一定很熟悉,就是SOA架构的最基本套路. 与dubbo对比,上图的3大要素中,spring cloud是借助以下组件来实现的: 1.注册中心 ...
- wap2.0开发
前言 移动通信和互联网的迅速发展,使得互联网从固定向移动转移(即移动互联网)成为一种必然的趋势.由于手机终端本身的限制条件和无线链路的特点,现有无线传送技术的效率和可靠性会越来越难以令用户满意.如何让 ...
- 【图像处理】基于OpenCV底层实现的直方图匹配
image processing 系列: [图像处理]图片旋转 [图像处理]高斯滤波.中值滤波.均值滤波 直方图匹配算法.又称直方图规定化.简单说.就是依据某函数.或者另外一张图片的引导,使得原图改变 ...
- 分享下使用 svn,测试服务器代码自动更新、线上服务器代码手动更新的配置经验
分享下使用 svn,测试服务器代码自动更新.线上服务器代码手动更新的配置经验 利用SVN的POST-COMMIT钩子自动部署代码 Linux SVN 命令详解 Linux SVN 命令详解2 使用sv ...
- HDU 1428 漫步校园 (BFS+优先队列+记忆化搜索)
题目地址:HDU 1428 先用BFS+优先队列求出全部点到机房的最短距离.然后用记忆化搜索去搜. 代码例如以下: #include <iostream> #include <str ...
- hdu4333 Revolving Digits(扩展kmp)
Revolving Digits Time Limit: 3000/1000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Others) ...
- 使用HTML5和CSS3碎语
当我们使用HTML5, CSS3,甚至Bootstrap设计网站的时候,有些方面是必须考虑的,比如字体大小,标题大小,行间距,每行字数,字体,颜色,背景图片和文字的搭配,图标,留白和布局......所 ...
- lufylegend:图片的加载和显示
<!DOCTYPE HTML> <html> <head> <meta charset="utf-8" /> <script ...