
Spark standalone运行模式
Spark Standalone 部署配置
Standalone架构
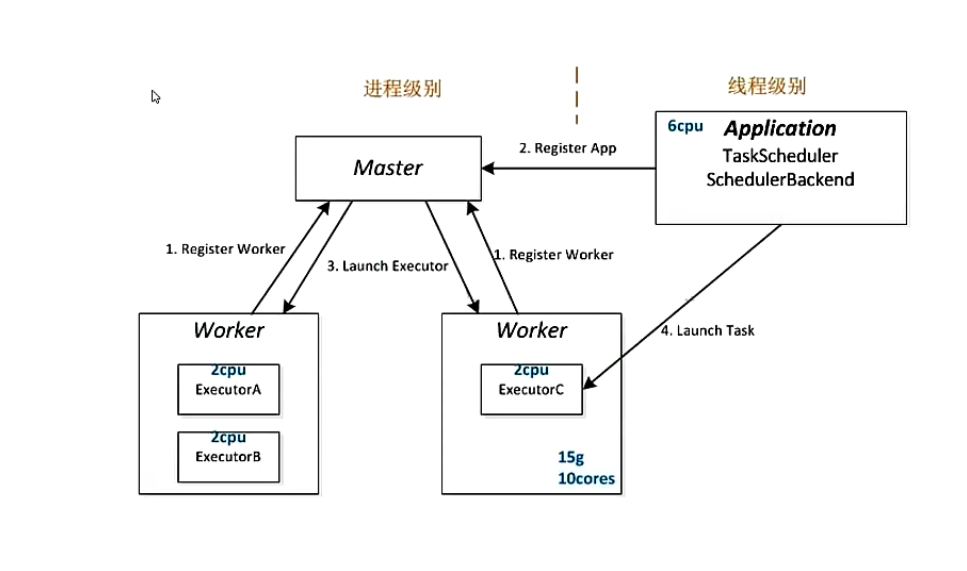
手工启动一个Spark集群
https://spark.apache.org/docs/latest/spark-standalone.html
通过脚本启动集群
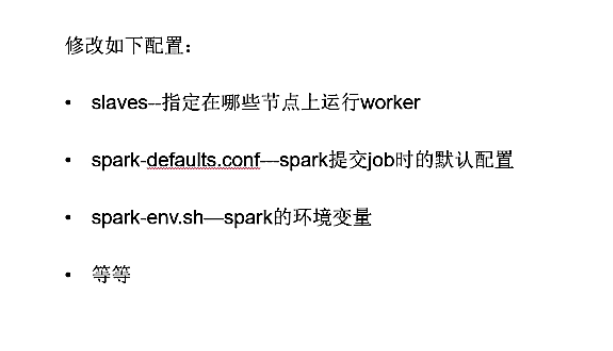
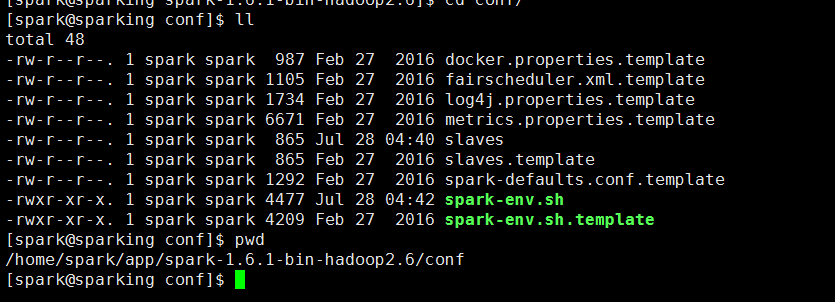
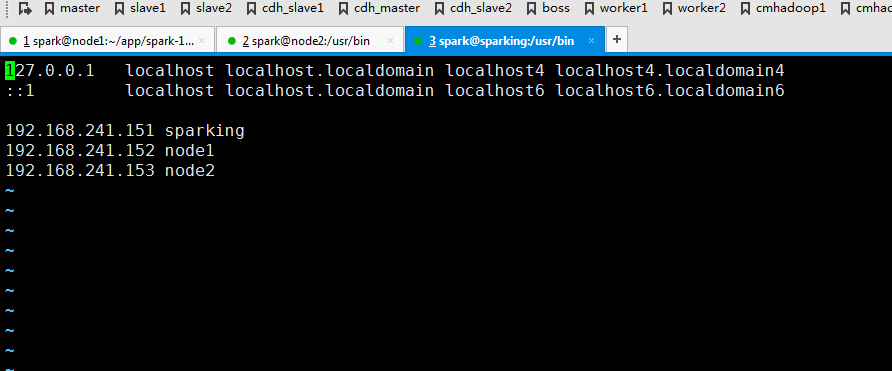
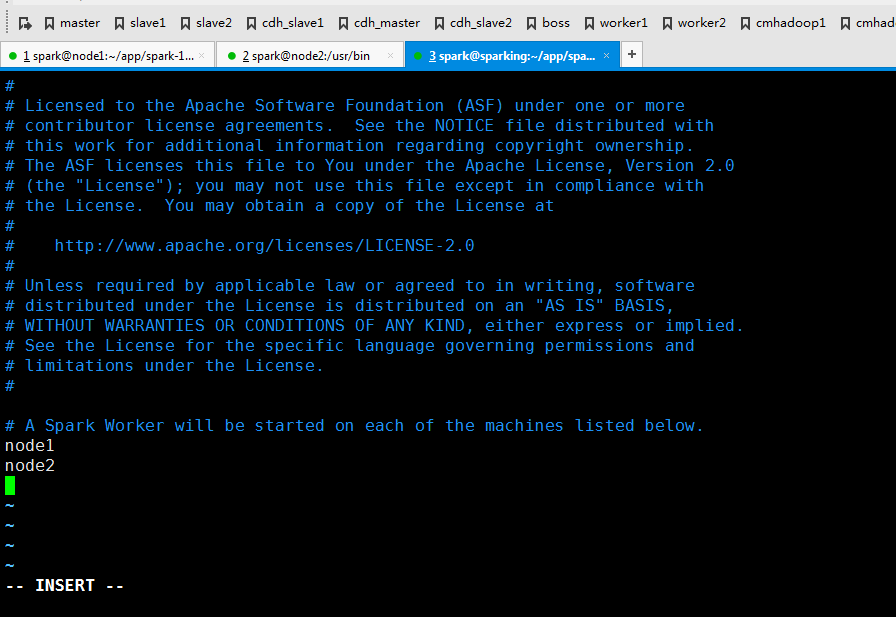
编辑slaves,其实把worker所在节点添加进去
配置spark-defaults.conf

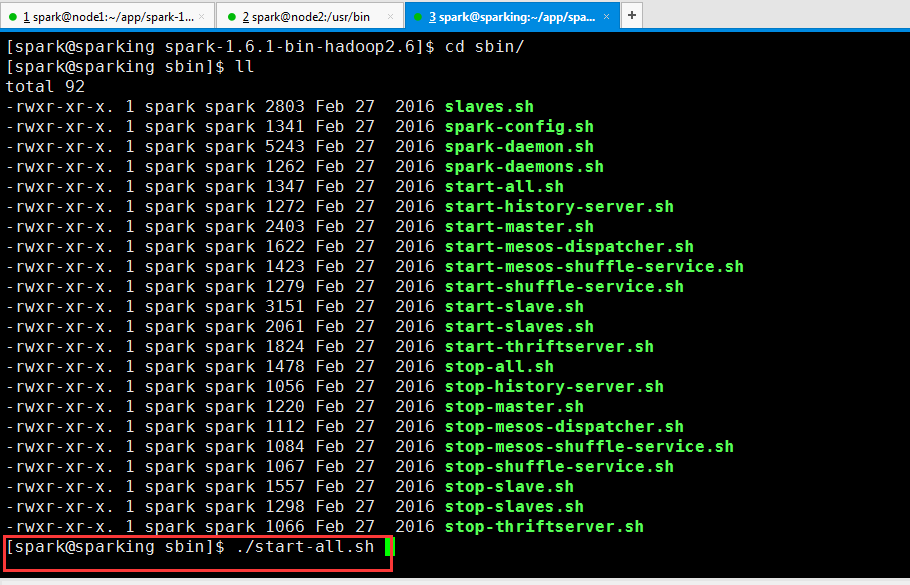
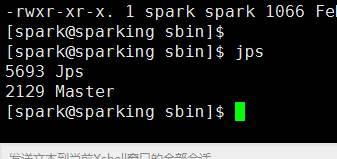
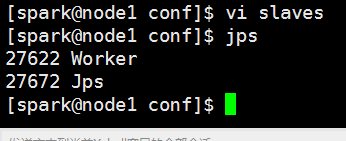
启动集群(我这里是三节点集群)

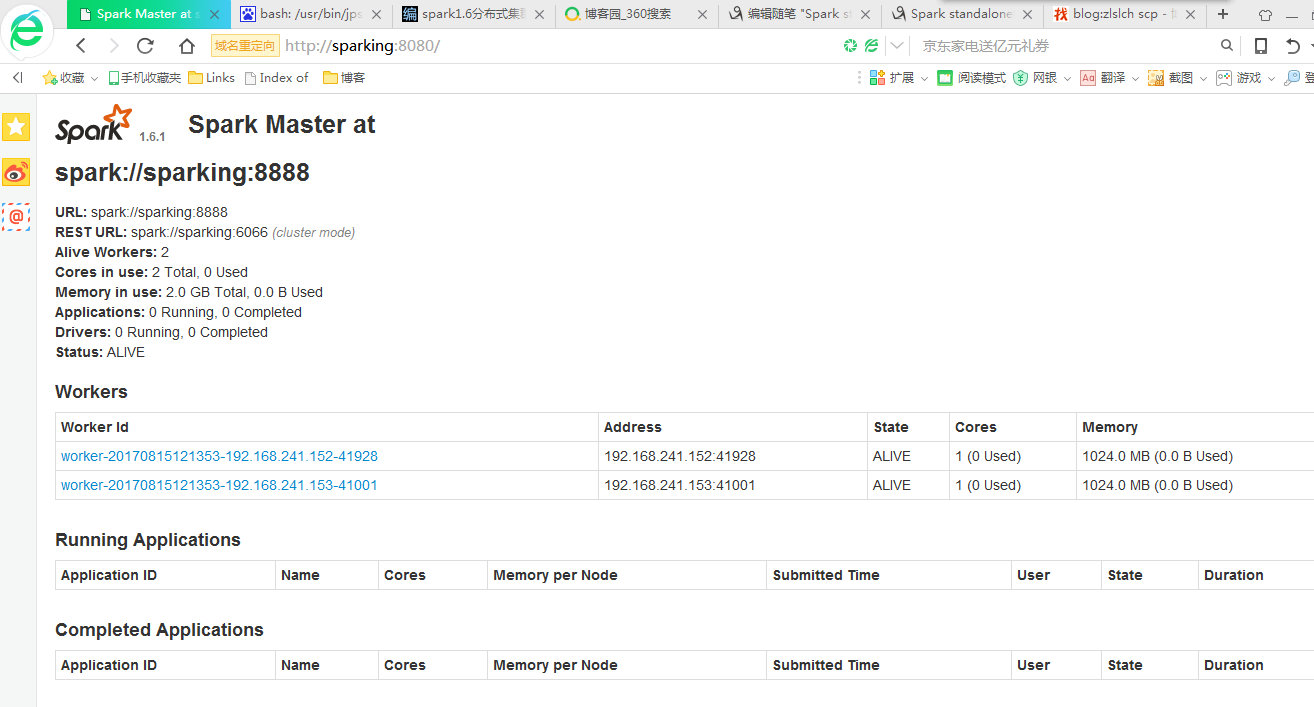
在浏览器打开页面
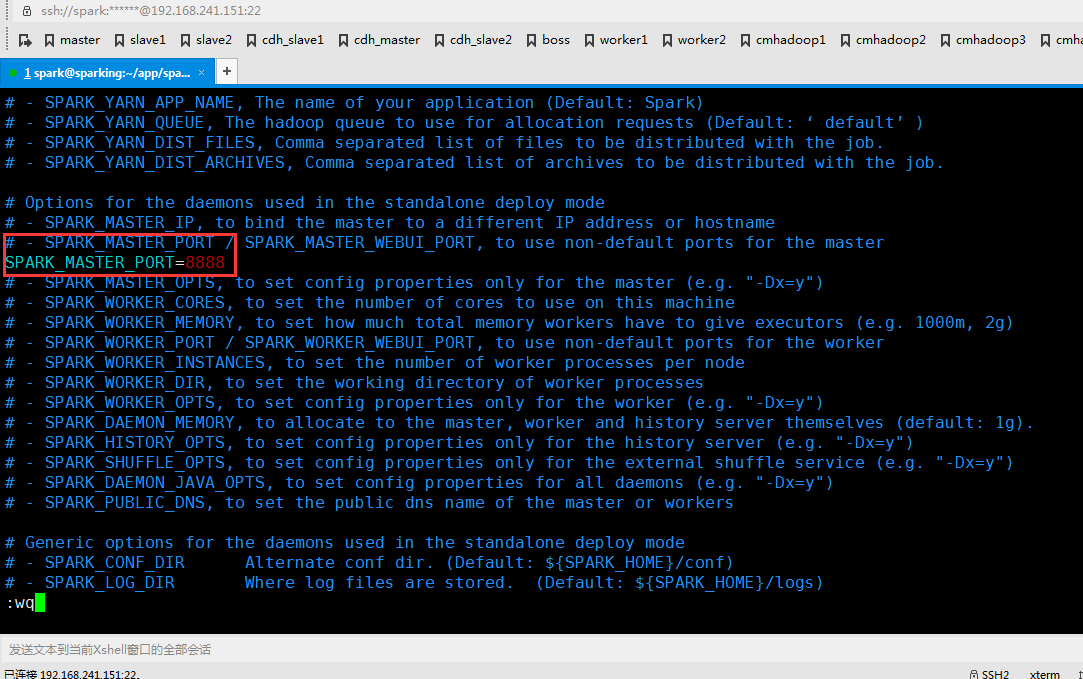
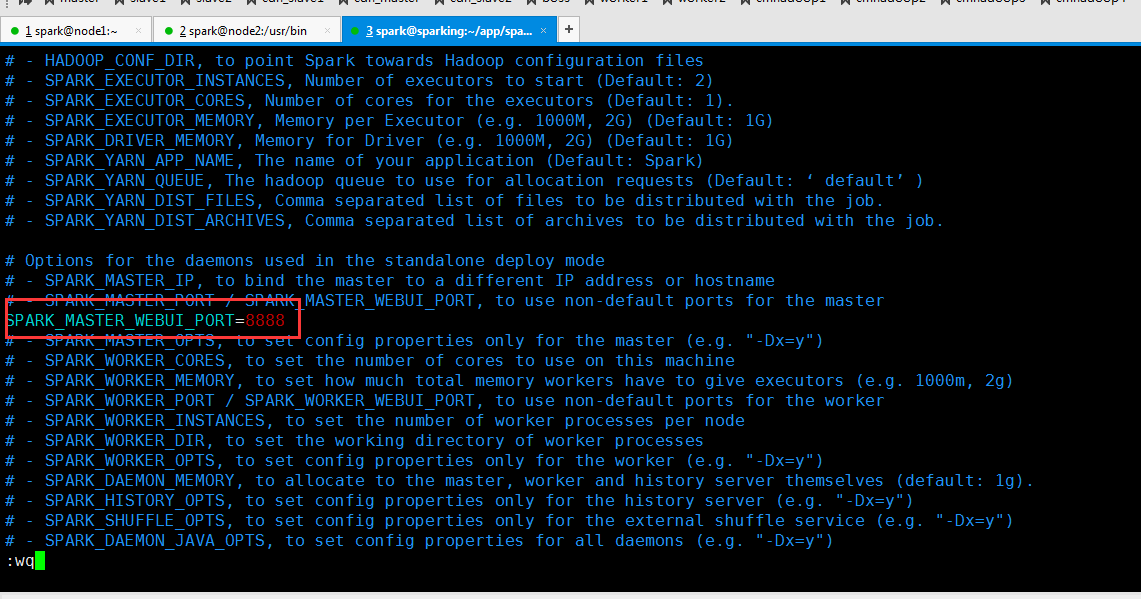
修改 spark-env.sh 文件
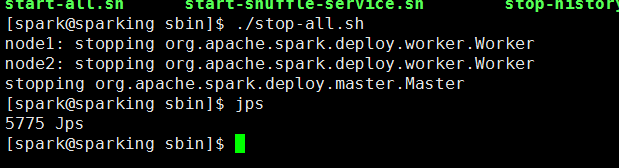
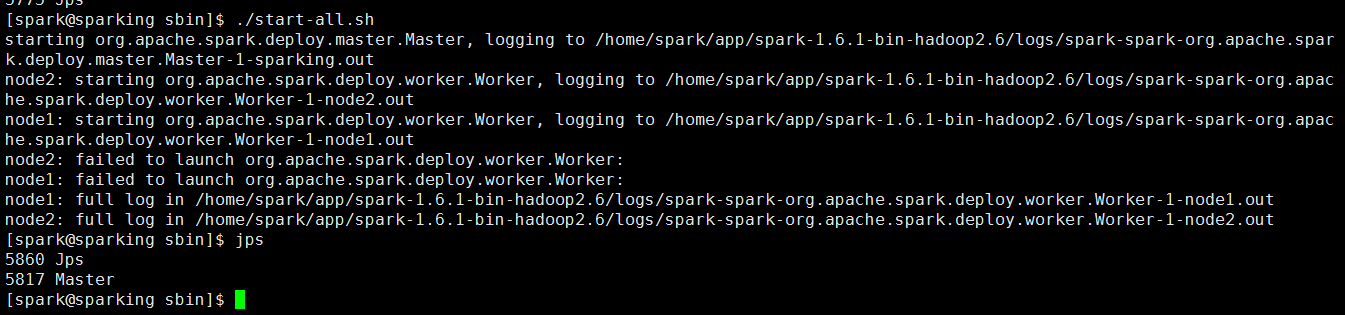
先停止
在重新启动一下
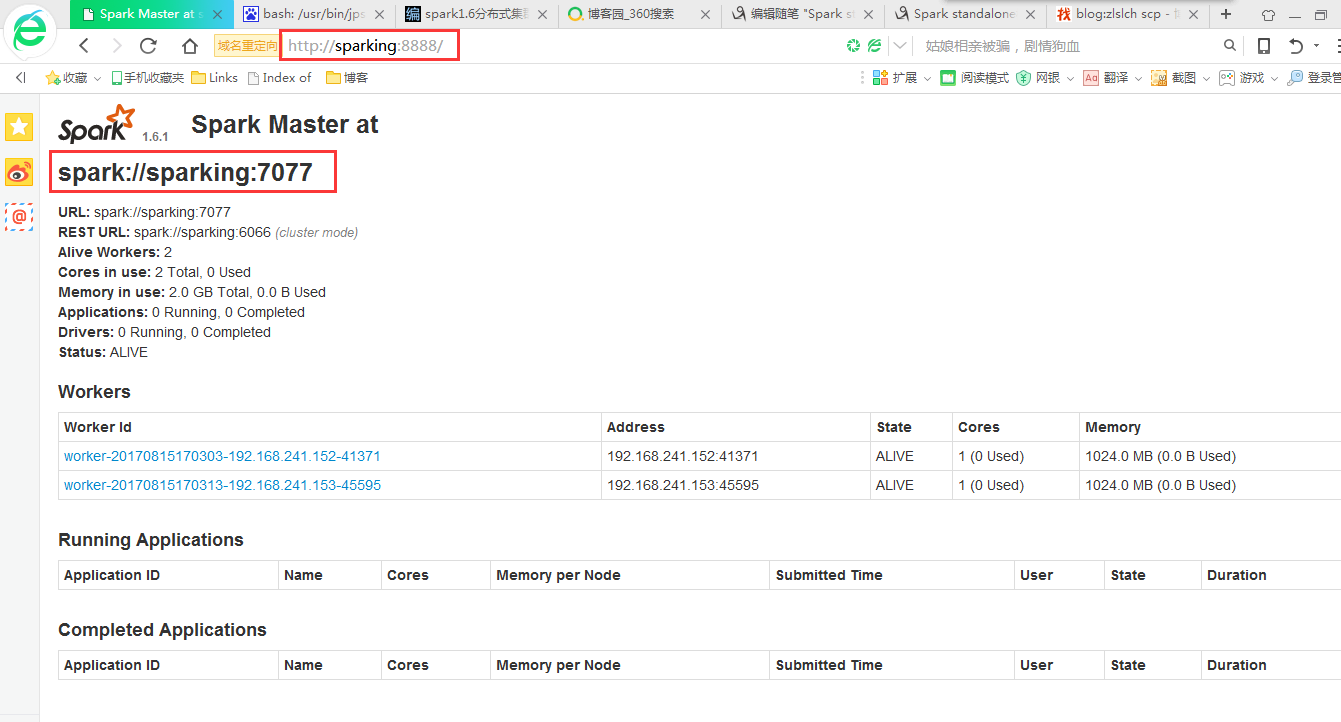
再次访问网页
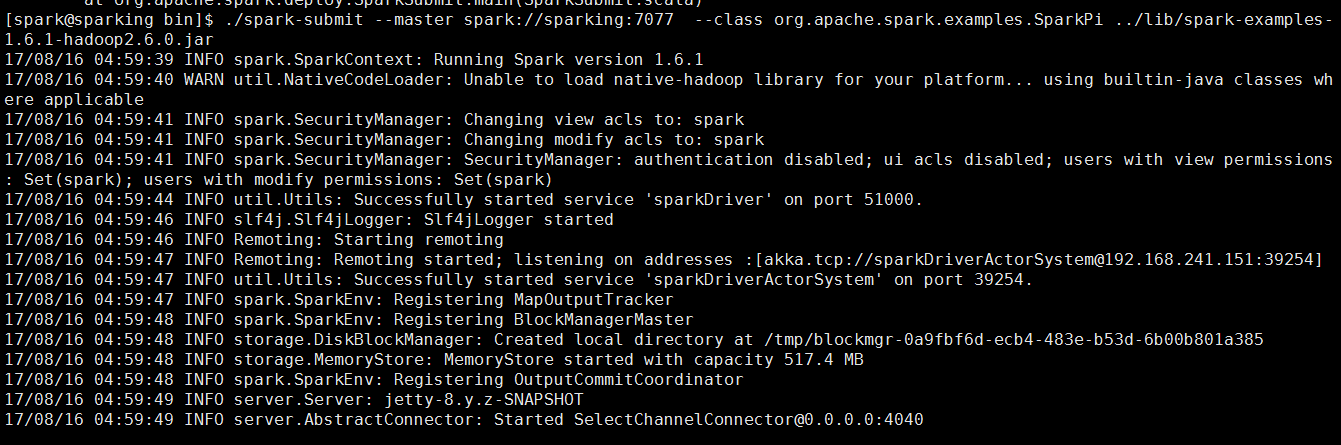
下面跑一个Job实例
./spark-submit --master spark://sparking:7077 --class org.apache.spark.examples.SparkPi ../lib/spark-examples-1.6.1-hadoop2.6.0.jar
从过程反馈信息可以看出来计算Pi的值
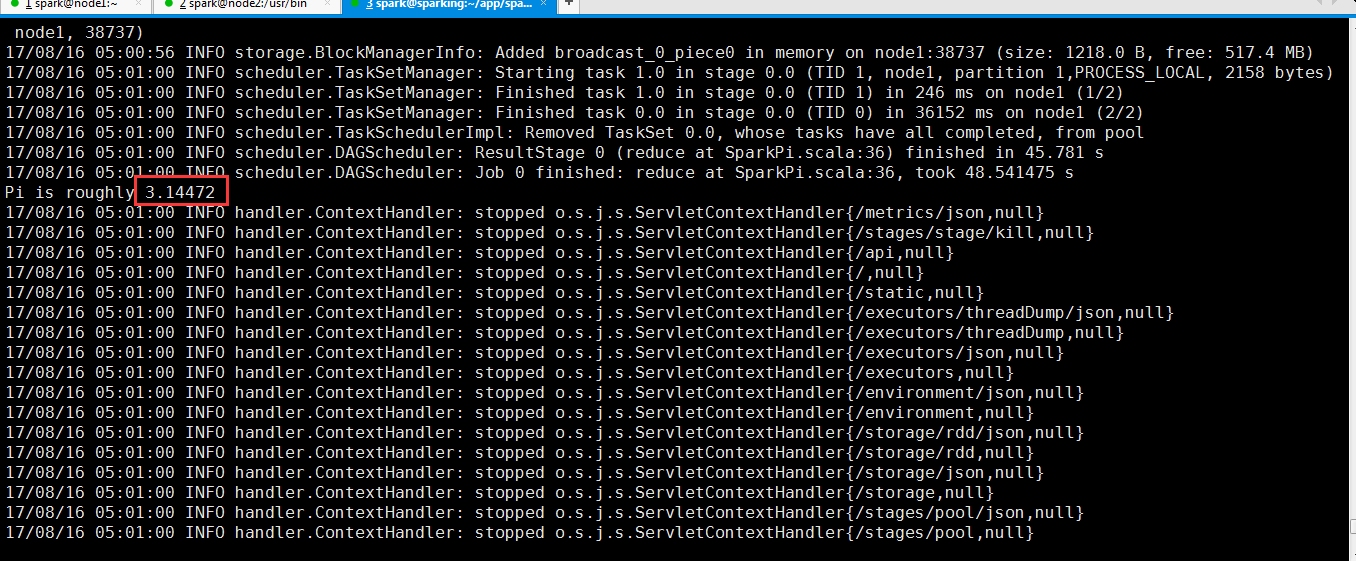
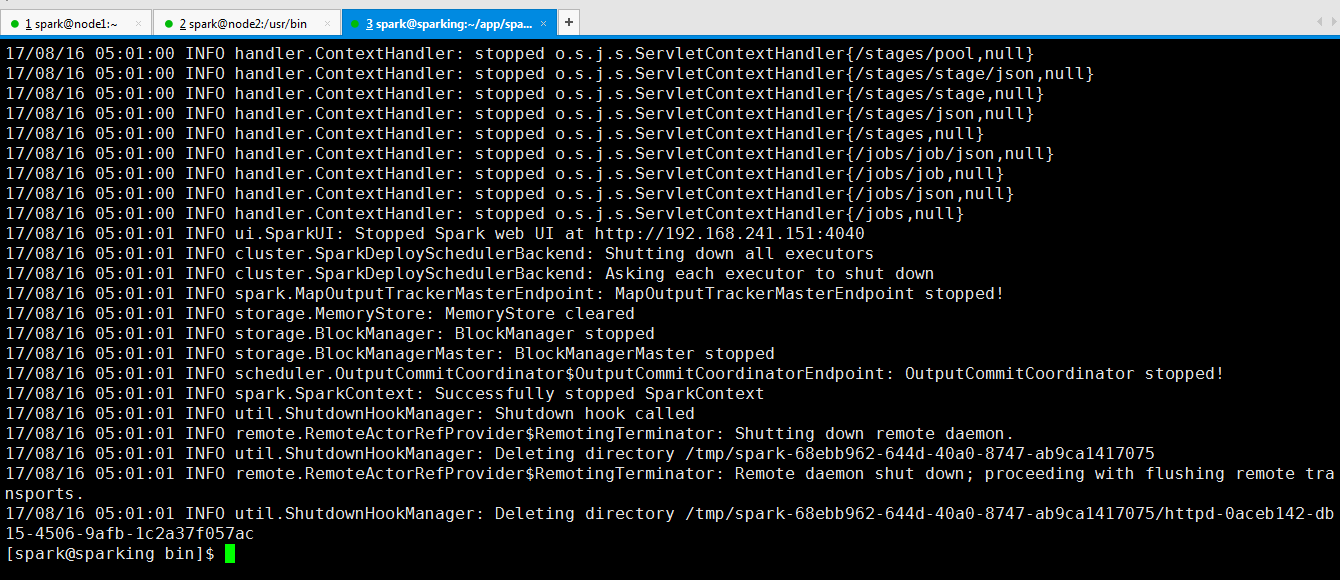
可以看到运行完成了。
从页面也可以看出来
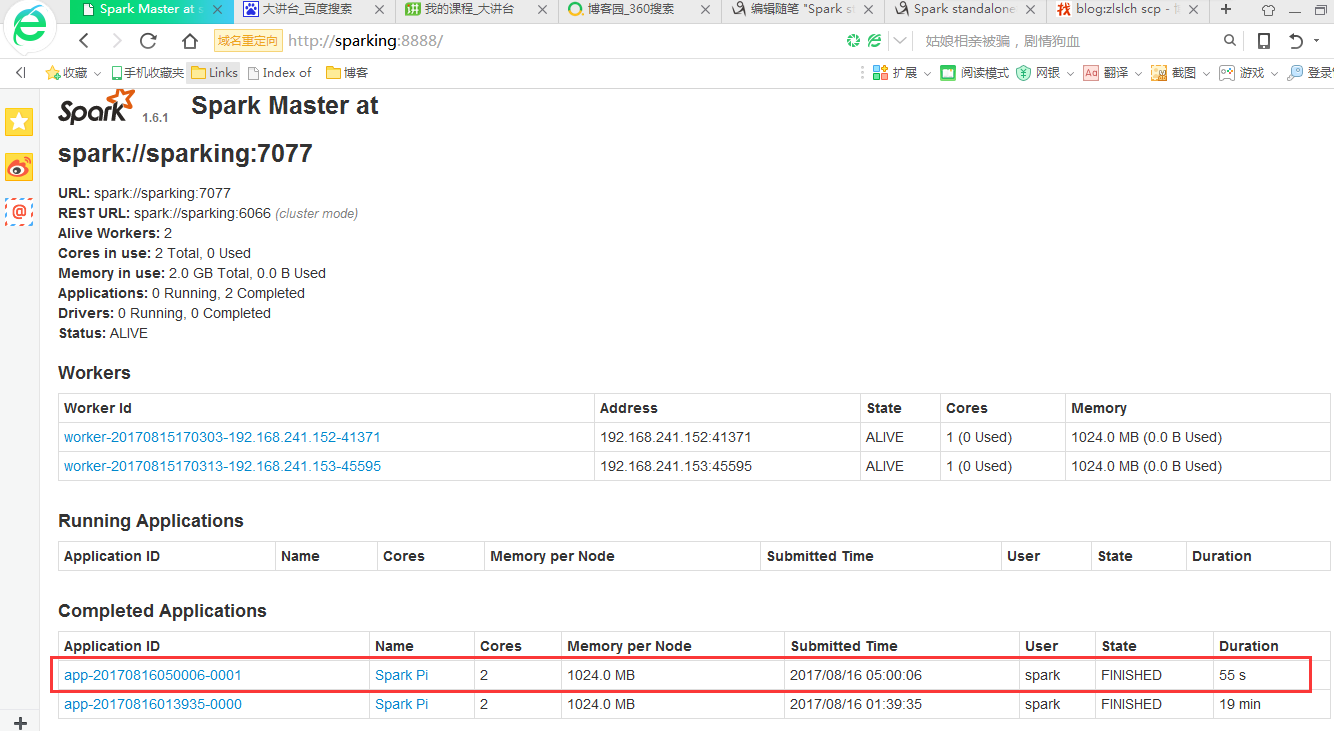
Spark Standalone HA

官方参考地址
https://spark.apache.org/docs/latest/spark-standalone.html#high-availability
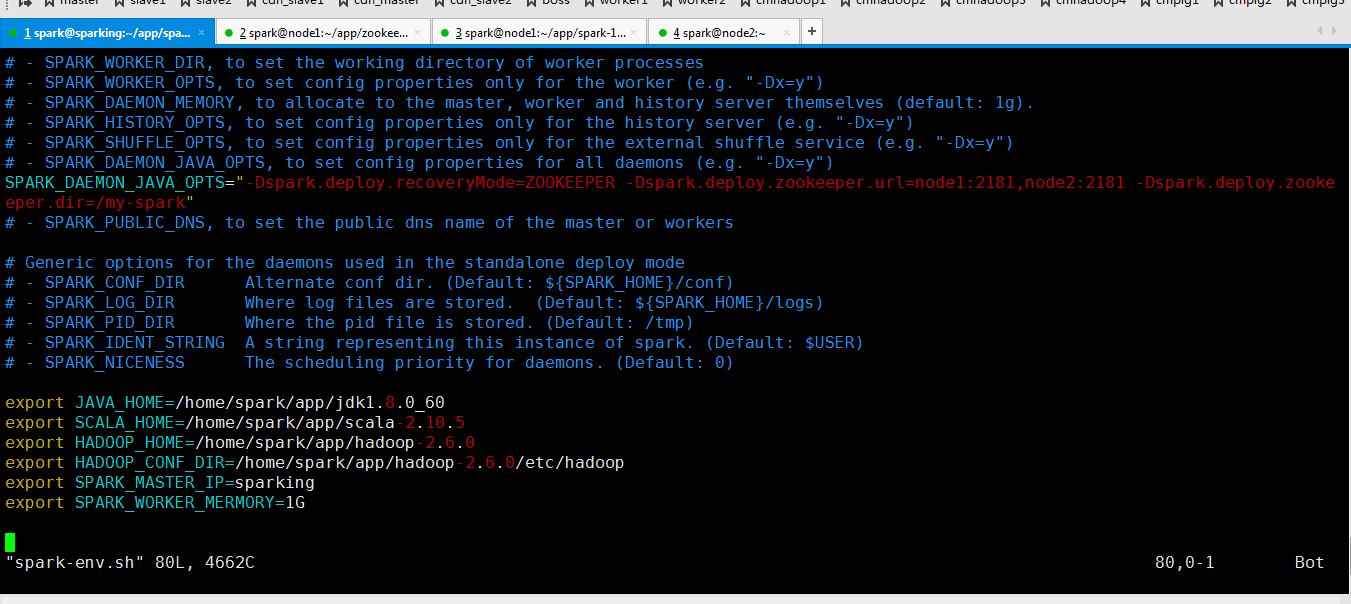
SPARK_DAEMON_JAVA_OPTS="-Dspark.deploy.recoveryMode=ZOOKEEPER -Dspark.deploy.zookeeper.url=node1:2181,node2:2181 -Dspark.deploy.zookeeper.dir=/my-spark"
默认是这样连接的。
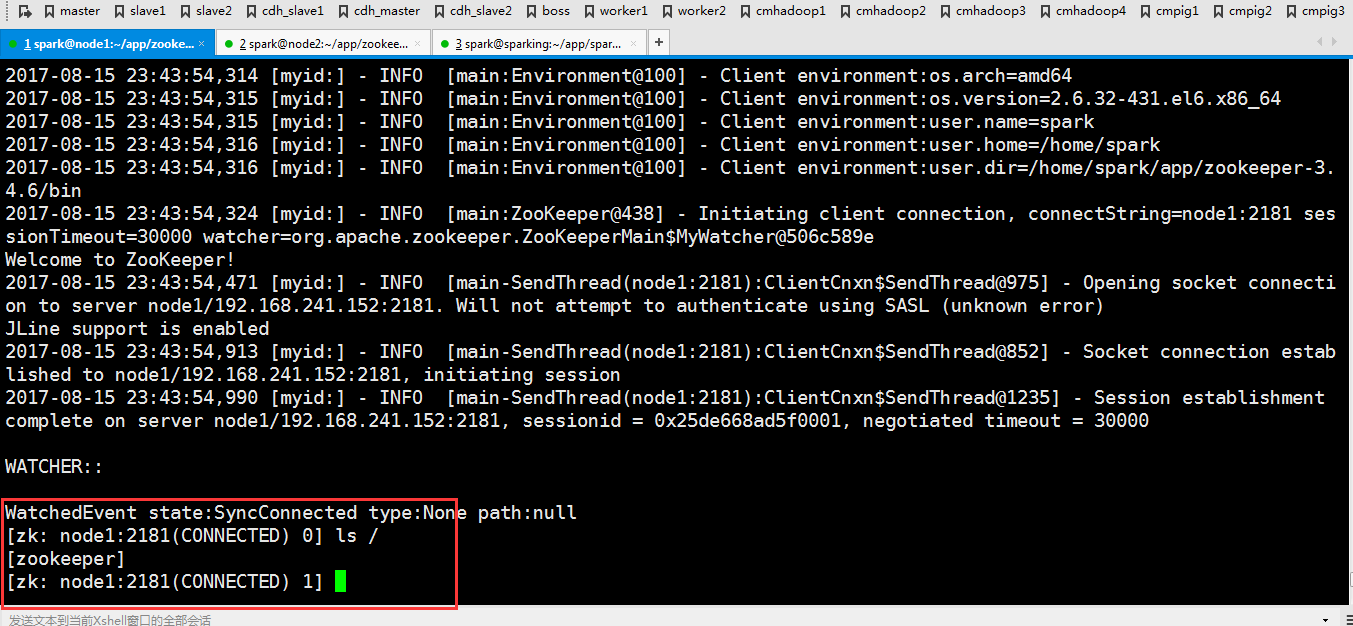
因为刚才修改了文件,现在把修改好的文件分发到另外两个节点去

scp -r spark-env.sh  spark@node1:/home/spark/app/spark-1.6.-bin-hadoop2./conf/

scp -r spark-env.sh  spark@node2:/home/spark/app/spark-1.6.-bin-hadoop2./conf/
然后重新启动一下
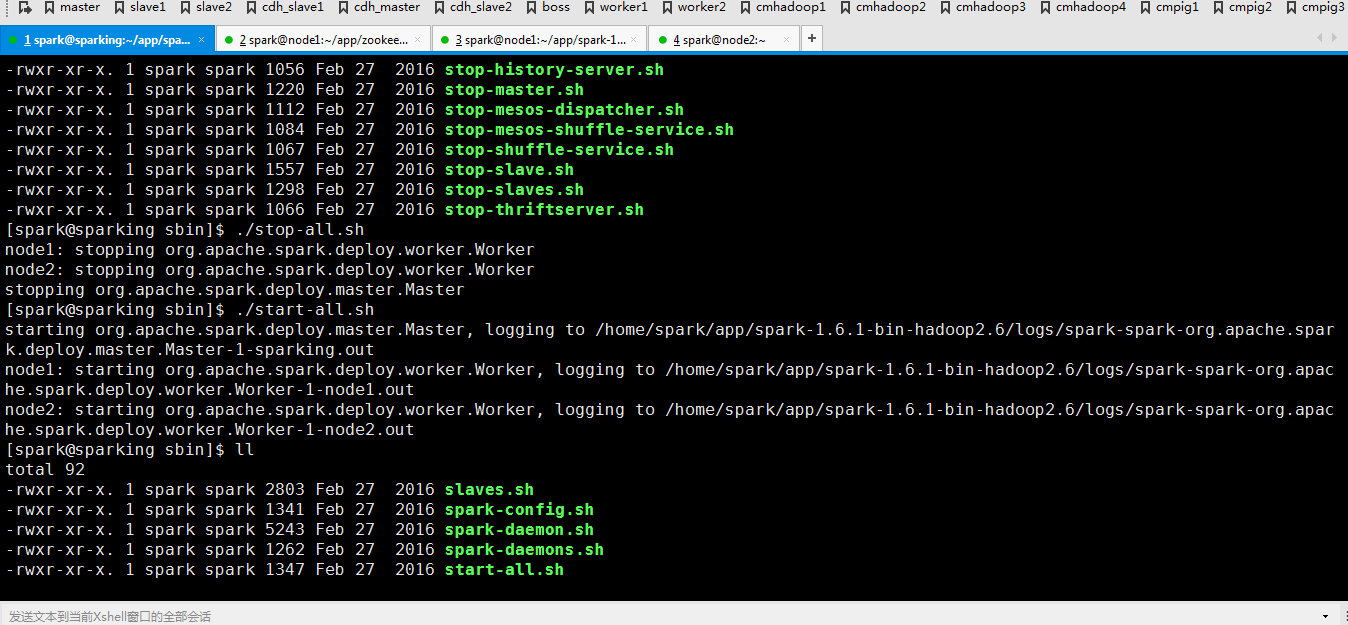
可以看到起来了
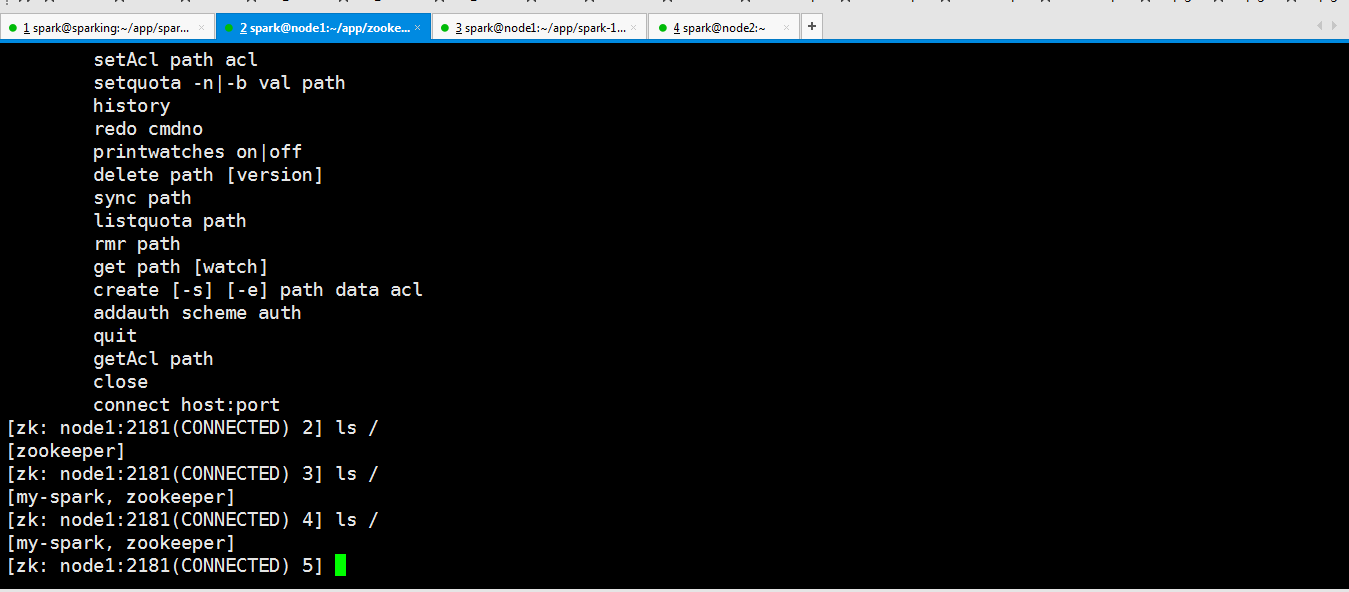
Spark Standalone 运行架构解析
Spark基本工作流程
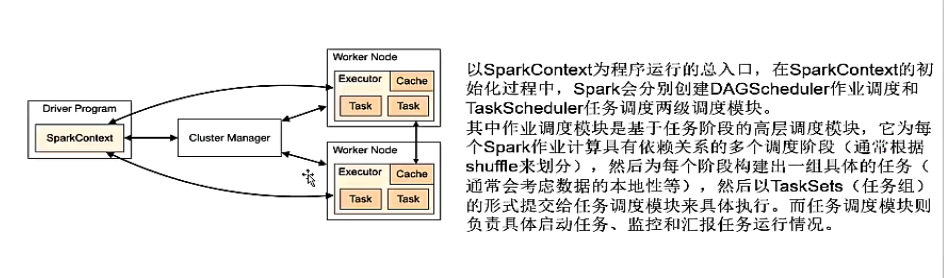
Spark Local模式
Spark Local cluster 模式
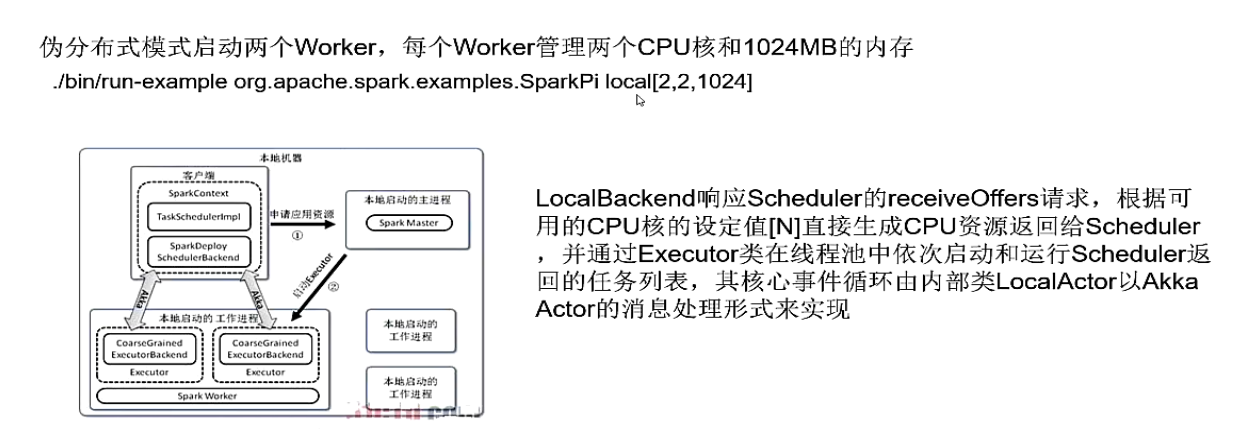
Spark standalone 模式

Spark standalone 详细过程解析
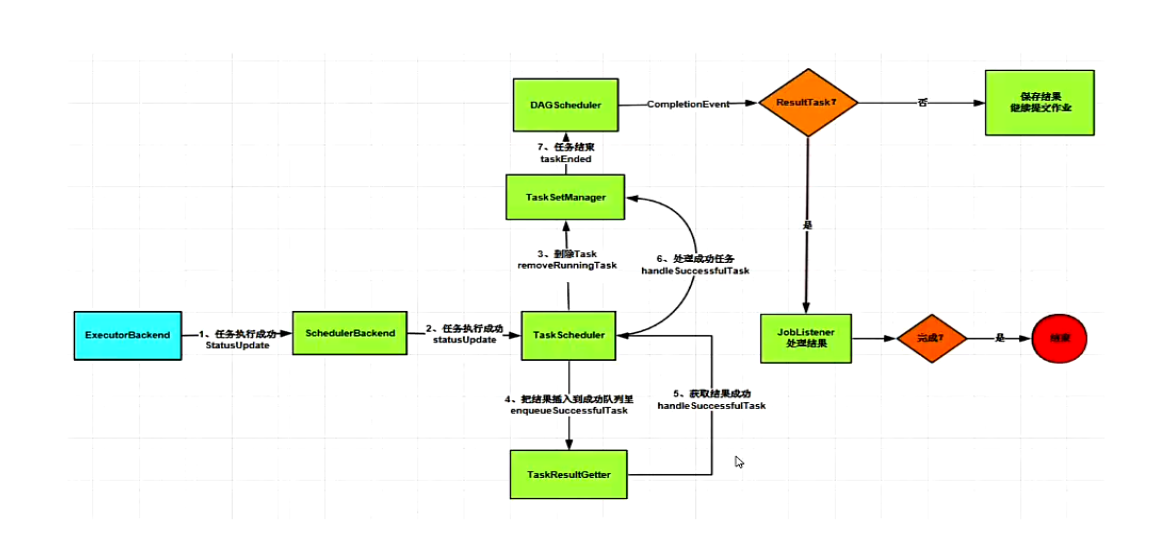
Spark standalone 模式下运行WordCount
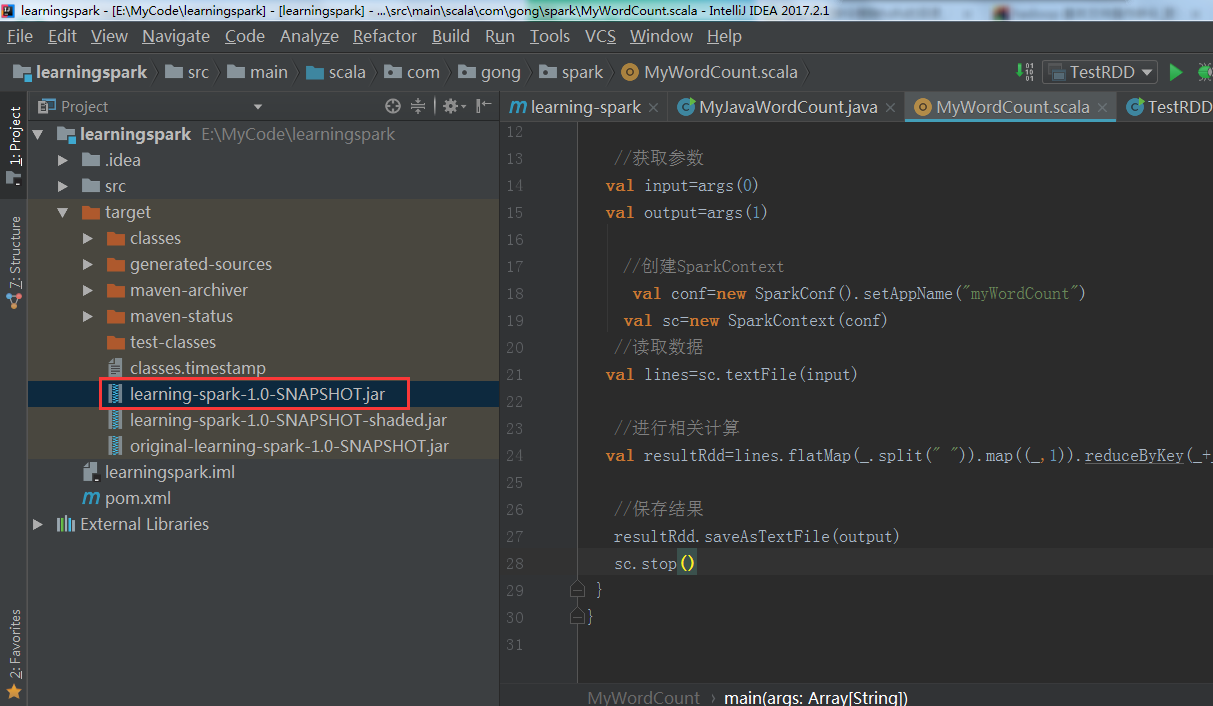
在IDEA里把写好的wordcount程序打包(我这里用的是scala版本写的)
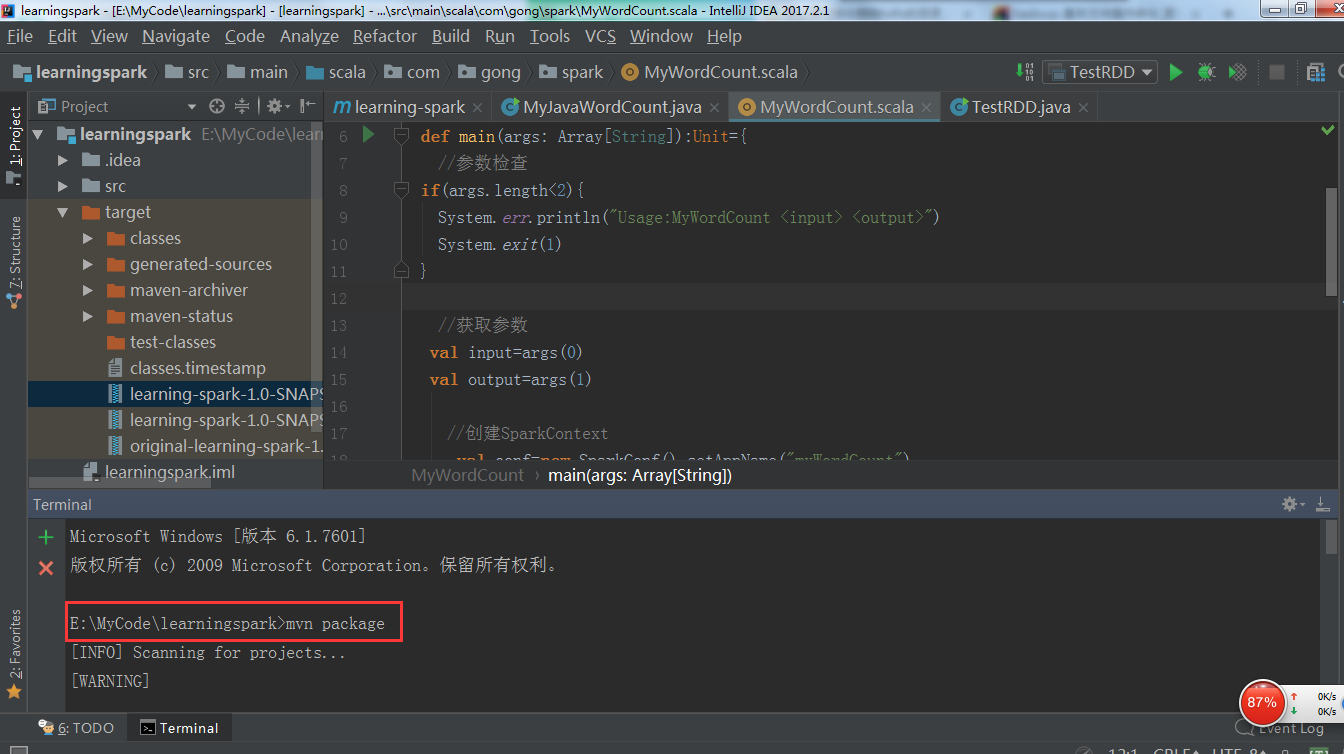
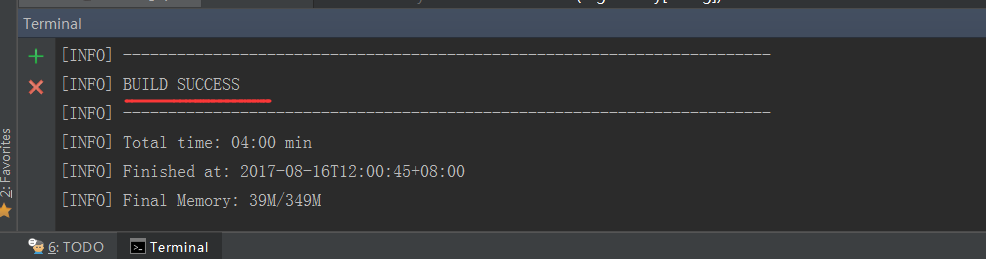
可以看到打包成功!
参考代码
package com.gong.spark

import org.apache.spark.{SparkConf, SparkContext}

object MyWordCount {

 def main(args: Array[String]):Unit={

   //参数检查

 if(args.length<){

   System.err.println("Usage:MyWordCount <input> <output>")

   System.exit()

 }

   //获取参数

  val input=args()

  val output=args()

    //创建SparkContext

     val conf=new SparkConf().setAppName("myWordCount")

    val sc=new SparkContext(conf)

   //读取数据

  val lines=sc.textFile(input)

   //进行相关计算

  val resultRdd=lines.flatMap(_.split(" ")).map((_,)).reduceByKey(_+_)

   //保存结果

   resultRdd.saveAsTextFile(output)

   sc.stop()

 }

}
把包上传到集群上(用rz命令就可以了)
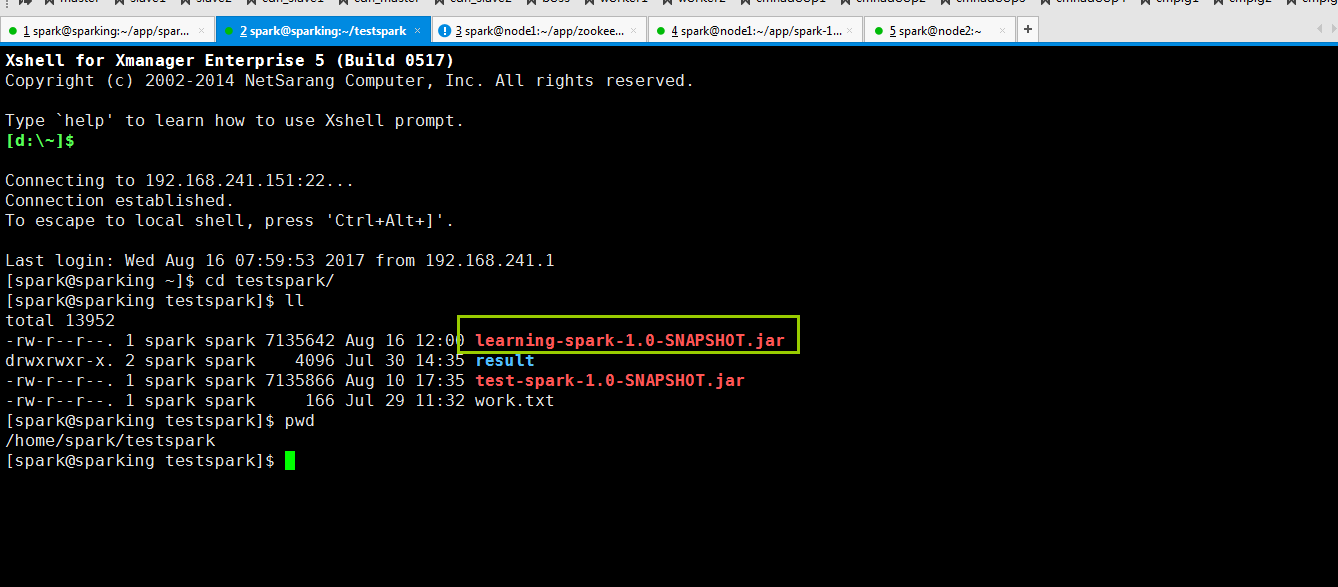
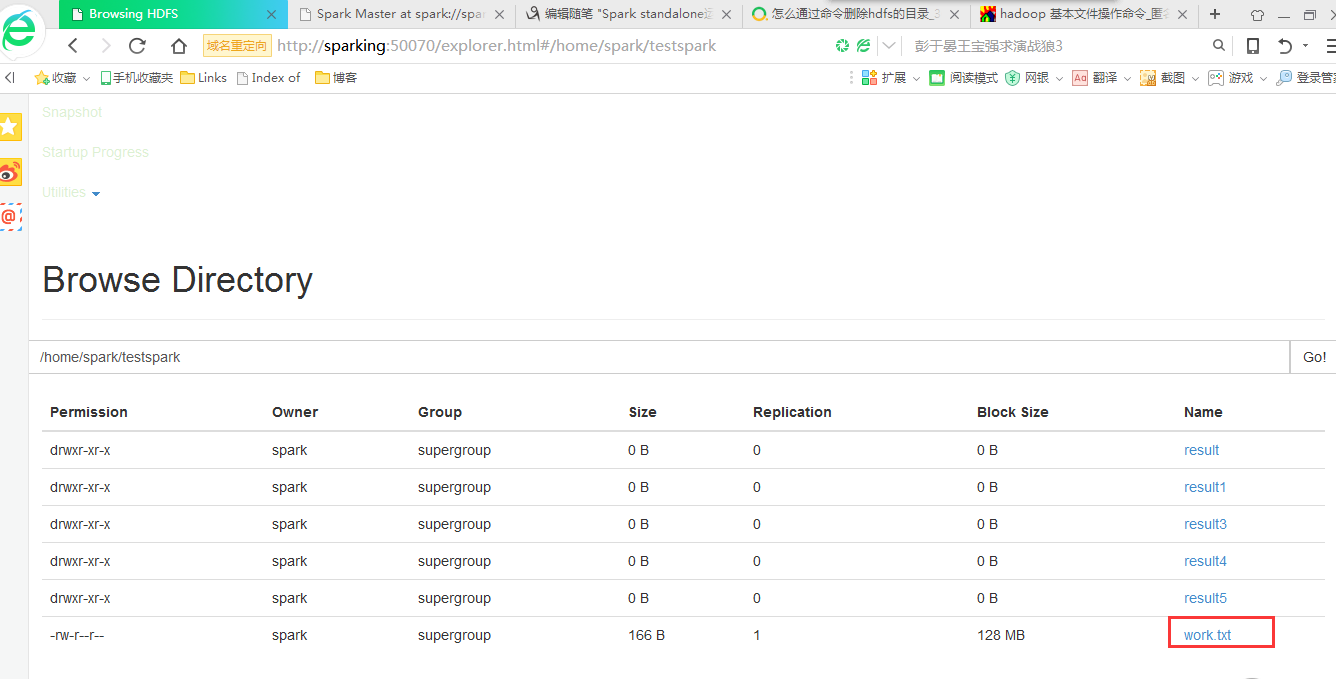
在这之前我已经在我的hdfs上上次了work.txt文件
下面在集群里跑一下程序
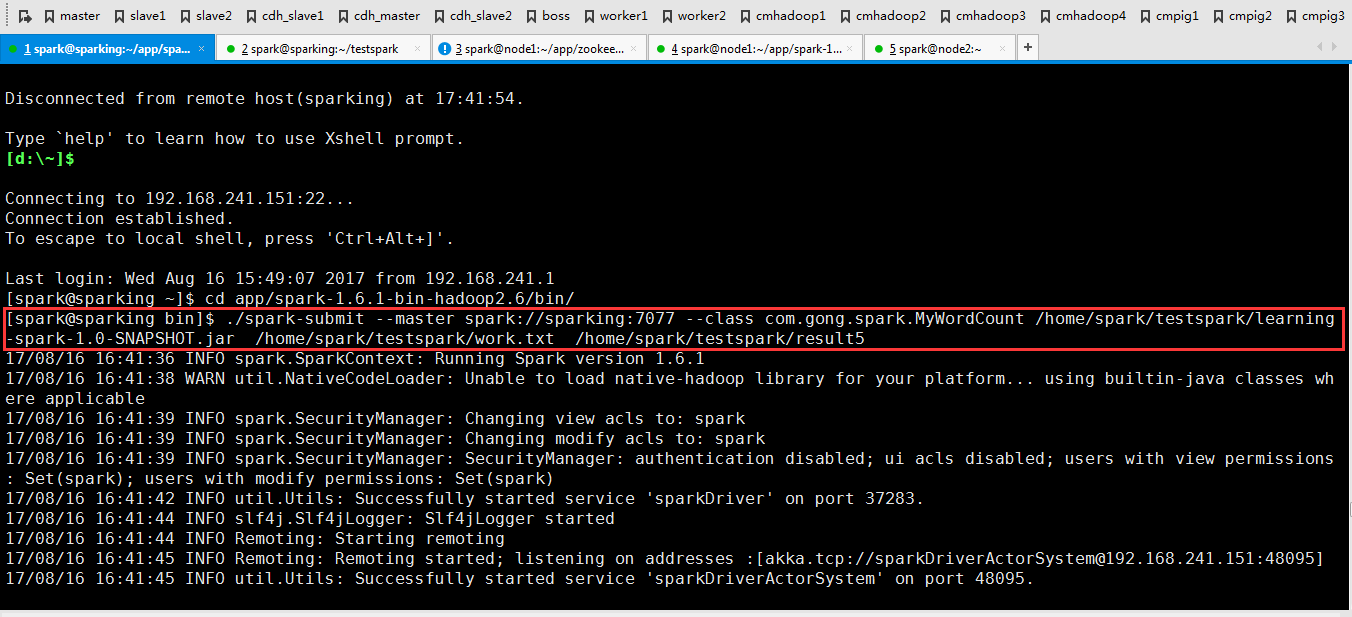
./spark-submit --master spark://sparking:7077 --class com.gong.spark.MyWordCount /home/spark/testspark/learning-spark-1.0-SNAPSHOT.jar /home/spark/testspark/work.txt /home/spark/testspark/result5
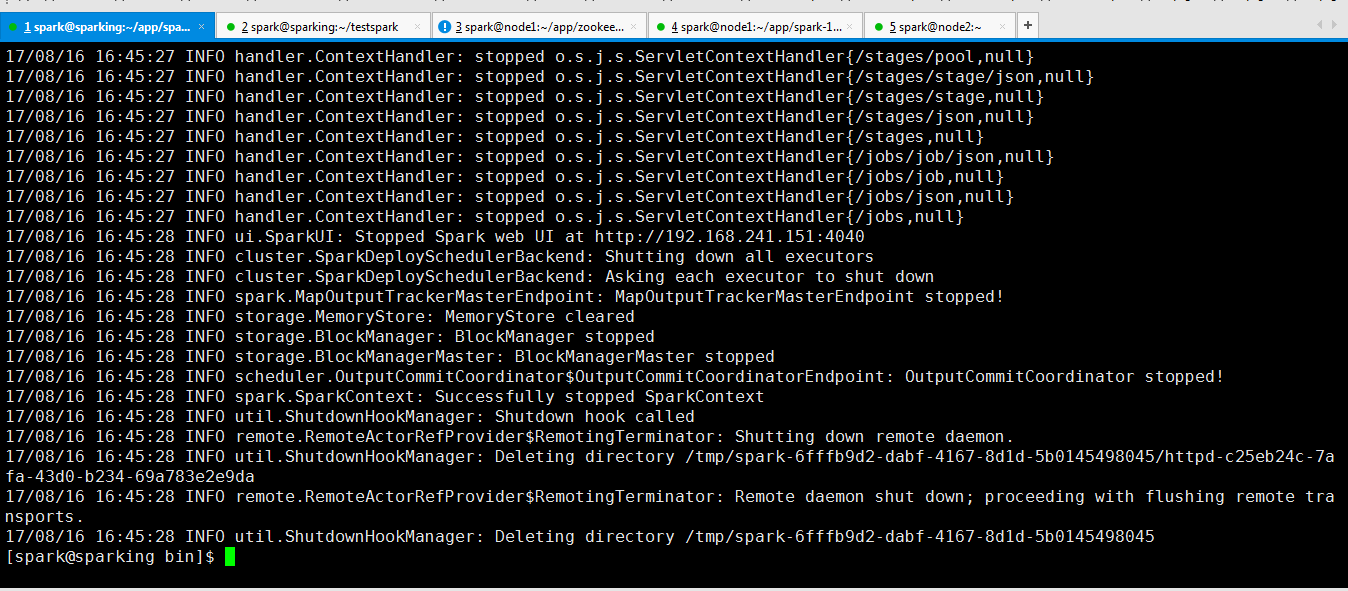
可以看到运行完成了(在这里我说下运行这个程序需要网络良好才可以,因为我的实验室的网络非常差,所以我试了好多次)!!!!!
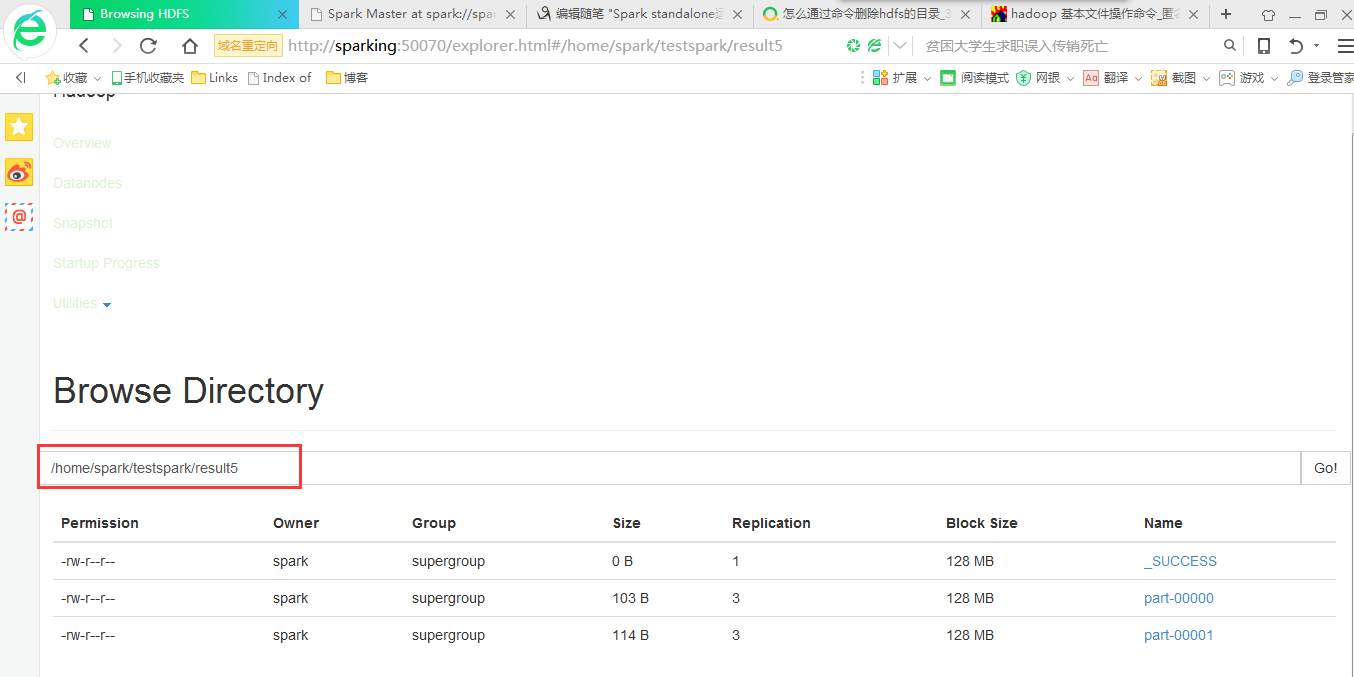
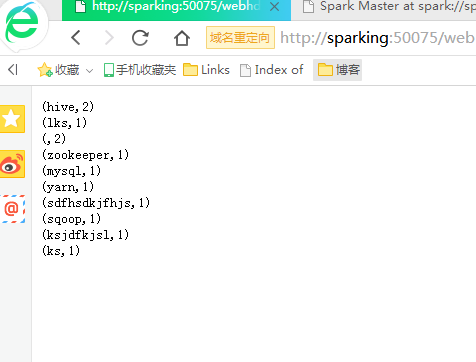
在hdfs上查看运行结果
Spark standalone运行模式的更多相关文章
- Spark standalone运行模式(图文详解)
不多说,直接上干货! 请移步 Spark standalone简介与运行wordcount(master.slave1和slave2) Spark standalone模式的安装(spark-1.6. ...
- 【原】Spark不同运行模式下资源分配源码解读
版权声明:本文为原创文章,未经允许不得转载. 复习内容: Spark中Task的提交源码解读 http://www.cnblogs.com/yourarebest/p/5423906.html Sch ...
- Spark的 运行模式详解
Spark的运行模式是多种多样的,那么在这篇博客中谈一下Spark的运行模式 一:Spark On Local 此种模式下,我们只需要在安装Spark时不进行hadoop和Yarn的环境配置,只要将S ...
- 五、standalone运行模式
在上文中我们知道spark的集群主要有三种运行模式standalone.yarn.mesos,其中常被使用的是standalone和yarn,本文了解一下什么是standalone运行模式,它的运行流 ...
- Spark的运行模式(1)--Local和Standalone
Spark一共有5种运行模式:Local,Standalone,Yarn-Cluster,Yarn-Client和Mesos. 1. Local Local模式即单机模式,如果在命令语句中不加任何配置 ...
- Spark多种运行模式
1.测试或实验性质的本地运行模式(单机) 该模式被称为Local[N]模式,是用单机的多个线程来模拟Spark分布式计算,通常用来验证开发出来的应用程序逻辑上是否有问题. 其中N代表可以使用N个线程, ...
- Spark的运行模式(2)--Yarn-Cluster和Yarn-Client
3. Yarn-Cluster Yarn是一种统一资源管理机制,可以在上面运行多种计算框架.Spark on Yarn模式分为两种:Yarn-Cluster和Yarn-Client,前者Driver运 ...
- spark的运行模式
1.local(本地模式) 单机模式,通常用来测试 将spark应用以多线程方式,直接运行在本地 本地模式可以启动多个executor不过上限不能超过cpu数 2.standalone(独立模式) 独 ...
- 017 Spark的运行模式(yarn模式)
1.关于mapreduce on yarn 来提交job的流程 yarn=resourcemanager(RM)+nodemanager(NM) client向RM提交任务 RM向NM分配applic ...
随机推荐
- 详解基本TCP套接字函数
以下讲解基本TCP套接字函数. 1.socket 函数 指定期望的通信协议类型. #include <sys/types.h> /* See NOTES */ #include ...
- 一年内自学MIT的33门课? 疯狂学习有方法
[导读]能快速掌握复杂信息,对成就卓越事业至关重要.ScottYoung的学习过程不只适用于学生,同样有助于学习复杂技能的专业知识. 能快速掌握复杂信息,对成就卓越事业至关重要.ScottYoung的 ...
- Executor 框架详解
框架最核心的类是ThreadPoolExecutor,它是Java线程池的实现类,通过Executors工具类,可以创建3种类型的ThreadPoolExecutor: 首先附上ThreadPoolE ...
- 类名.fromObject(obj)静态方法
- repo学习笔记
1. 遍历所有的git仓库,并在每个仓库执行-c所指定的命令(被执行的命令不限于git命令,而是任何被系统支持的命令,比如:ls . pwd .cp 等 . $ repo forall -c &quo ...
- nodejs 使用express开发获取其他网站引用本站点js文件的参数
nodejs进行站点的开发其性能是很好的,在js 大行其道的天下,使用js基本上可以干好多只要我们能想到的东西,我们可以使用js文件进行用户验证等等. 这次我们就使用express 进行获取其他站点引 ...
- SQL——ROW_NUMBER
版权声明:欢迎转载,请注明出处 https://blog.csdn.net/suneqing/article/details/30250193 语法: ROW_NUMBER() OVER(PARTIT ...
- C#常用插件和工具
Code generation(代码自动生成) NVelocity CodeSmith X-Code .NET XGoF - NMatrix / DEVerest Compilation(编译工具) ...
- kettle--window开发环境和linux运行环境的迁移
首先要做的是将kettle在linux下搭建好. 一.搭建linux的kettle环境 1.1解压 (my_python_env)[root@hadoop26 ~]# .zip -d /usr/loc ...
- 在CentOS和RHEL中配置SNMPv3
首先,使用yum安装必要的软件 [root@server ~]# yum install net-snmp-utils net-snmp-devel安装完成之后, 先停止snmpd,再创建具有只读属性 ...