
Numpy的补充(重要!!)
轴的概念
英文解释 https://www.sharpsightlabs.com/blog/numpy-axes-explained/
汉化解释 https://www.jianshu.com/p/f4e9407f9f9d
多维数组的索引及切片
https://blog.csdn.net/brucewong0516/article/details/79186126
核心 每个维度一个索引值,逗号分割
每个维度取切片用冒号
隔行取 需嵌套索引,arr[ [ 1,3,4,5] , : ]
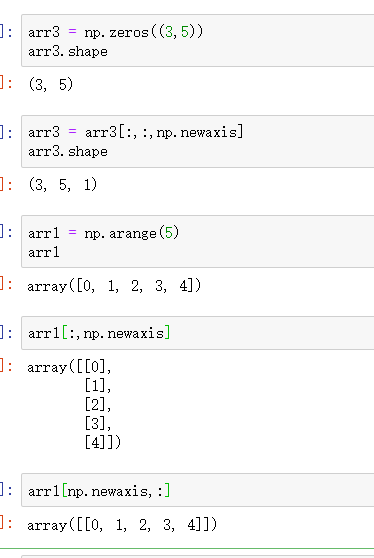
np.newaxis
给原数组增加一个维度,newaxis放在第几个位置,就会在shape里 相应的位置增加了一个维数
https://www.jb51.net/article/144967.htm
广播机制
涉及到不同shape的数组运算的时候的概念
https://www.runoob.com/numpy/numpy-broadcast.html
https://zhuanlan.zhihu.com/p/60365398
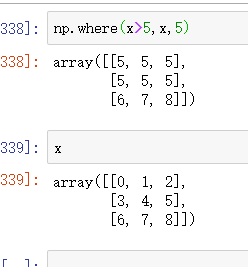
np.where( condition, [x, y] )
condition:array_like,bool
x,y:array_like
实际上 感觉涉及到的东西很多,比如涉及到了广播。这个应该是个很强大的方法。某种程度上像布尔值索引。
https://zhuanlan.zhihu.com/p/83208224
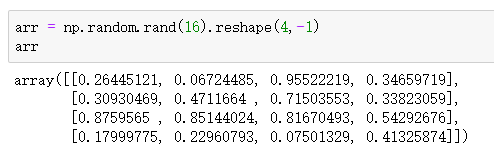
arr.reshape(1,-1) / np.reshape(-1,1)
实际就是自动计算的方法。-1代表自动计算,666
https://blog.csdn.net/W_weiying/article/details/82112337
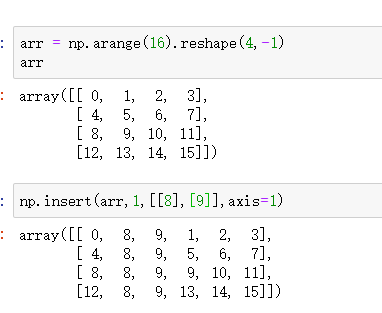
数组的添加 有两个方法 np.insert 和 np.append
np.insert(arr, obj, values, axis=None)
https://blog.csdn.net/lcxxcl_1234/article/details/80869152
1 values 可能是个m*1维数组
np.append()
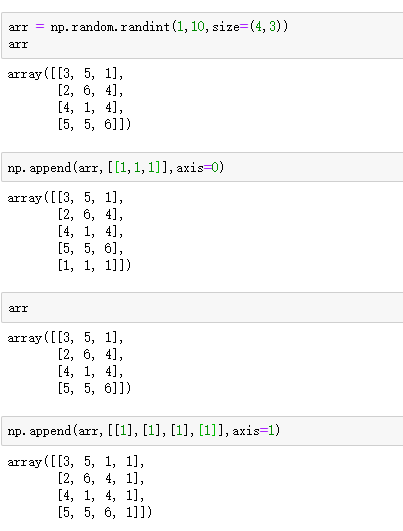
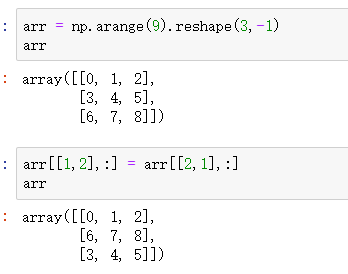
数组的行列相互交换
不值一提了
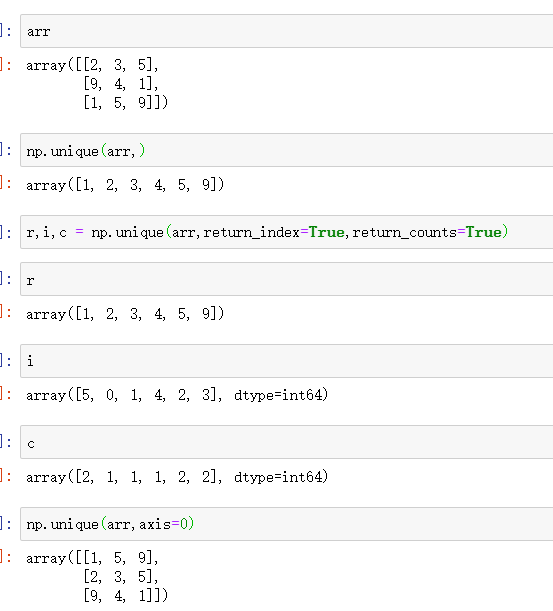
np.unique(ar,return_index=False,return_inverse=False,return_counts=False,axis=None)
最常用的功能是 去重。
有这几个参数,return_index,return_counts 可能用到的频率比较高。知道有这几参数就行。
当指定axis后,对多维数组可以使用,不会返回惟一值,而是对指定轴进行排序。
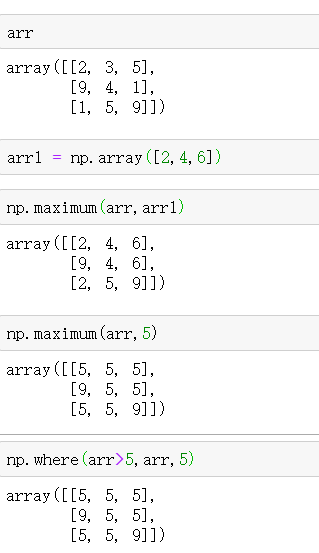
np.maximum()
返回较大值,参数可以广播。完全可以用np.where 实现。可能 广播机制 会用的比较广。
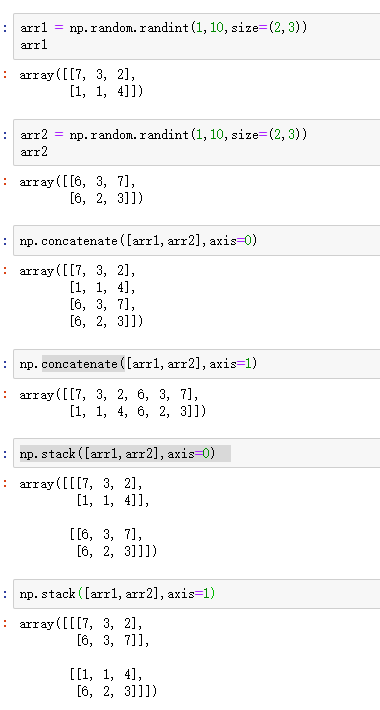
np.concatenate()
与np.stack的区别是 concatenate不改变维度
DateFram的切片,索引
牢记,一定优先用 df.loc[ ]
df.loc['a':'c','xx':'xxx'] 只有这一种方法,可以取多行多列
df.loc[['a','d'],['xx','xxxx']]
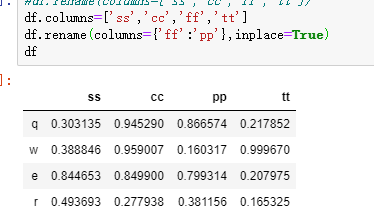
df.rename()
用处就是对index,column进行重命名。
也可以df.index = df.columns = 直接改。这个方法的好处就是可以对想单独改一个名称比较方便,参数可以是字典。
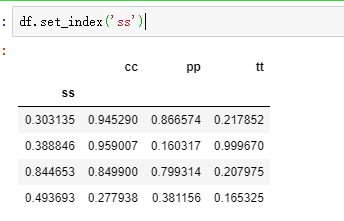
df.set_index()
Set the DataFrame index using existing columns
可能会有一定的应用场景。原来一列的数值,变为index,对从数据库中读到的数据,把id变为index,这种场景下就能用到了
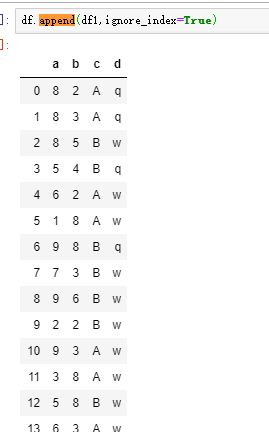
DateFrame 两个df的合并
df.append(df1)
pd.concat( [df1,df2] )
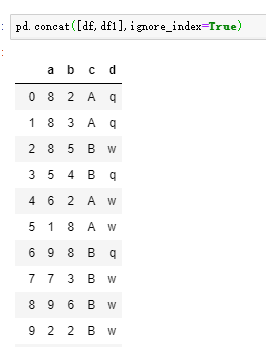
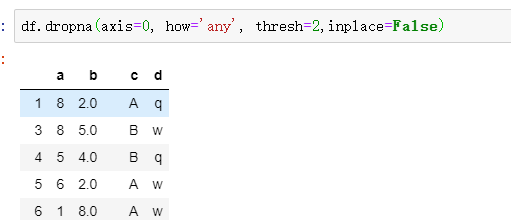
df.dropna()
这几个参数注意下
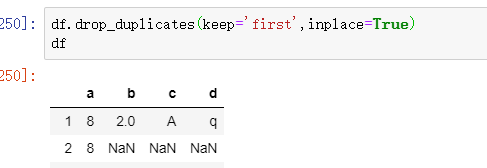
df.drop_duplicates
去重,这几个参数眼熟下
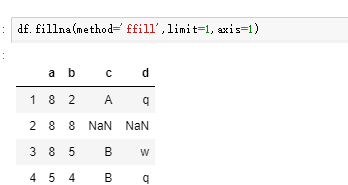
df.fillna()
添补na数据。熟悉下这几个参数
多重索引
了解下这个方法就够了,切片,索引都差不多
pd.MultiIndex.from_product([index1,index2])
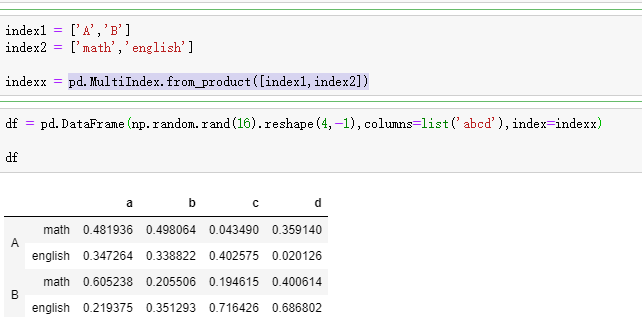
聚合运算
什么叫聚合函数,聚合函数就是对一组值执行计算,并返回单个值。返回单个值,这是重点!
g = df.groupby(' ')
1)这个 g 可以拿来直接聚合 ,g.agg( ) , g.apply( ) ,这里想说的不是这个,而是 g 本身有很多方法。
通过 for 循环 取 ,或者 g.get_group() 取分组后的结果。
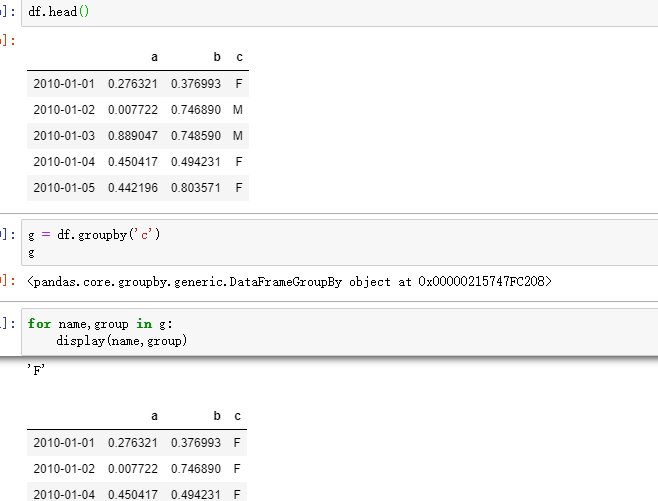
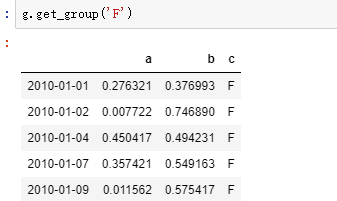
2) groupby( by =)
by = mapping, function, label, or list of labels,可以接很多参数,最常见的就是dataframe的columns,一个 或多个列表都可以。
函数也是可以的,只不是是函数的返回值的value值 作为分组的依据,可以是个范围(之前我们看到的都是确定值,比如男,女,省份等)。最好的例子就是 df.groupby(pd.cut(df,[])).count()
(即groupby可以按照具体的值分类,也可以按照范围分类,具体的值不必多说,说道范围,就想到了pd.cut )
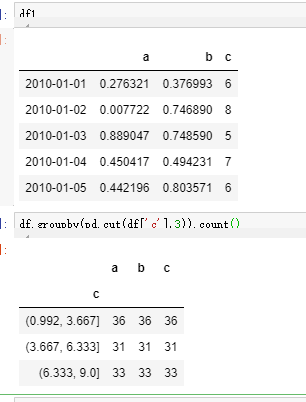
g.agg() 聚合运算,参数比较灵活,可以接列表,字典,懂含义就行。 优点,速度快,缺点,局限性大,只能聚合。聚合接收的参数是每一个列,即series。
g.apply( func ,* args ) 。 优点,自定义,灵活,缺点,速度慢。接收的参数是dateframe。 这个方法应用的场景很广。
时间序列索引
ts = pd.date_range( )
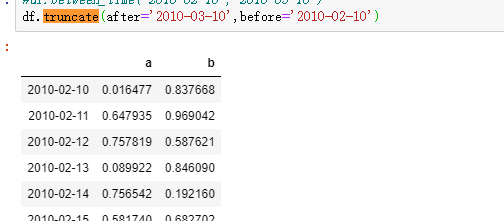
这里介绍的是由时间序列作为索引而引申出的两个方法,一个是truncate,一个是between_time,这两个方法的调用者 都是 series或者dataframe,而不是 timeindex。
Numpy的补充(重要!!)的更多相关文章
- numpy&pandas补充常用示例
Numpy [数组切片] In [115]: a = np.arange(12).reshape((3,4)) In [116]: a Out[116]: array([[ 0, 1, 2, 3], ...
- numpy库补充 mean函数应用
mean()函数功能:求取均值经常操作的参数为axis,以m * n矩阵举例: axis 不设置值,对 m*n 个数求均值,返回一个实数 axis = 0:压缩行,对各列求均值,返回 1* n 矩阵 ...
- Python:numpy.ma模块
翻译总结自:The numpy.ma module - NumPy v1.21 Manual 前言 ma是Mask的缩写,关于Mask的解释,如果有PS的基础,可以理解为蒙版,如果有计算机网络的基础, ...
- 【小白的CFD之旅】05 补充基础
黄师姐是一个很干脆果敢的人,从她的日常装扮就能显露出来.卡帕运动装,白色运动鞋,马尾辫,这是小白对黄师姐的第一印象.“明天早上九点钟来实验室,我给你安排这阵子的任务.”黄师姐对小白说.说话语气和老蓝一 ...
- 《利用python进行数据分析》读书笔记--第四章 numpy基础:数组和矢量计算
http://www.cnblogs.com/batteryhp/p/5000104.html 第四章 Numpy基础:数组和矢量计算 第一部分:numpy的ndarray:一种多维数组对象 实话说, ...
- numpy库的常用知识
为什么有numpy这个库呢?准安装的Python中用列表(list)保存一组值,可以用来当作数组使用,不过由于列表的元素可以是任何对象,因此列表中所保存的是对象的指针.这样为了保存一个简单的[1,2, ...
- python numpy 使用笔记 矩阵操作
(原创文章转载请标注来源) 在学习机器学习的过程中经常会用到矩阵,那么使用numpy扩展包将是不二的选择 建议在平Python中用多维数组(array)代替矩阵(matrix) 入门请考 http:/ ...
- 《利用python进行数据分析》NumPy基础:数组和矢量计算 学习笔记
一.有关NumPy (一)官方解释 NumPy is the fundamental package for scientific computing with Python. It contains ...
- [补充资料] 手动搭建 Cloudera 集群
本课主题 集群搭建 设置 Web 服务器 启动 ClouderManager 登入 Cloudera Manager 引言 这部份是一个补充资料,记录如何安装 Cloudera 服务器 集群搭建 查看 ...
随机推荐
- Vue下简单分页及搜索功能
最近利用Vue和element ui仿写了个小页面,记一哈分页和搜索功能的简单实现. 首页 emmmm..... 搜索框输入..... 搜索完成 数据是直接写在这里面的: cardPhoto:[ ...
- Java实现文件上传-按钮弹出上传页面
转自: https://blessht.iteye.com/blog/1405057 最近自己在做一个小系统玩的时候涉及到了文件的上传,于是在网上找到Java上传文件的方案,最后确定使用common- ...
- 06.Linux系统-GitLab版本控制服务安装部署
官方文档:https://about.gitlab.com/install/#centos-7 1.yum install -y curl policycoreutils-python openssh ...
- [跨界思考|瑞典|IKEA]有意思的宜家|IKEA
来自北欧瑞典的IKEA无疑是成功的企业.根据我最近几天的去宜家的体验和来自网上的资料,我发现IKEA不止是成功的企业,而且可以说是一家独特又伟大的公司. 说到IKEA,就不得不说下它的创始人:坎普拉德 ...
- u-boot-2016.09 make编译过程分析(一)
https://blog.csdn.net/guyongqiangx/article/details/52565493 综述 u-boot自v2014.10版本开始引入KBuild系统,Makefil ...
- MySQL基础day03 存储引擎和外键MySQL 5.6
MySQL基础day03_存储引擎和外键-MySQL 5.6 外键的条件: 1,表的存储引擎为innodb存储引擎 2,表中外键字段的类型要与参考表的字段类型一致 3,外键字段要是索引类型中的一种 M ...
- C++ GUI Qt4学习笔记08
C++ GUI Qt4学习笔记08 qtc++signal图形引擎文档 本章介绍Qt的二维图形引擎,Qt的二维图形引擎是基于QPainter类的.<span style="colo ...
- 大数据学习笔记之初识Hadoop
1.Hadoop概述 1.1 Hadoop名字的由来 Hadoop项目作者的孩子给一个棕黄色的大象样子的填充玩具的命名 Hadoop的官网:http://hadoop.apache.org . 1.2 ...
- 【NOIP2016提高A组8.11】钱仓
题目 分析 发现,一定有一个点作为起点,所有的路径都不经过这个起点. 接着贪心求答案, 如果\(c_i>1\),将其中\(c_i-1\)个钱往后"铺". 易证\(x^2+y^ ...
- poj 3352 : Road Construction 【ebcc】
题目链接 题意:给出一个连通图,求最少加入多少条边可使图变成一个 边-双连通分量 模板题,熟悉一下边连通分量的定义.最后ans=(leaf+1)/2.leaf为原图中size为1的边-双连通分量 #i ...