
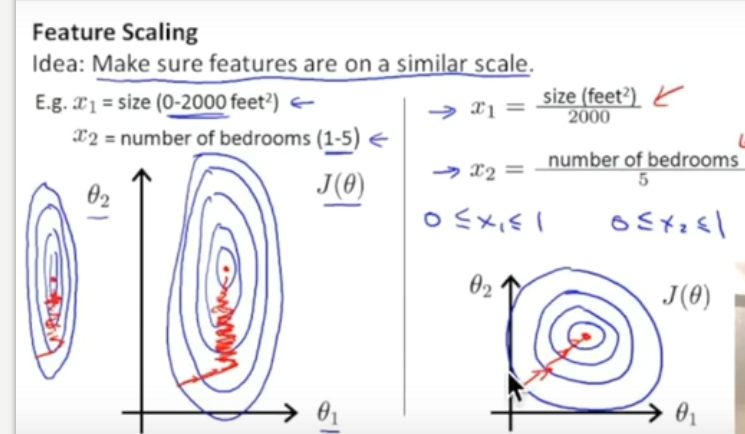
sklearn正规化(Normalization或者scale)
from sklearn import preprocessing

import numpy as np

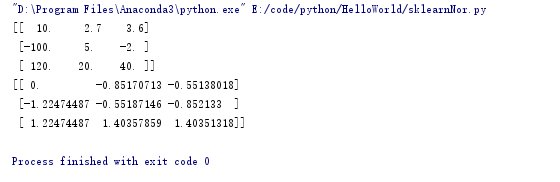
a = np.array([[10,2.7,3.6],[-100,5,-2],[120,20,40]],dtype=np.float64)

print(a)

print(preprocessing.scale(a))
from sklearn import preprocessing

import numpy as np

from sklearn.cross_validation import  train_test_split

from sklearn.datasets.samples_generator import  make_classification

from sklearn.svm import SVC

import matplotlib.pyplot as plt

# a = np.array([[10,2.7,3.6],[-100,5,-2],[120,20,40]],dtype=np.float64)

# print(a)

# print(preprocessing.scale(a))

X,Y = make_classification(n_samples=300,n_features=2,n_redundant=0,n_informative=2,random_state=22, n_clusters_per_class=1, scale=100)

# plt.scatter(X[:, 0], X[:, 1], c=Y)

# plt.show()

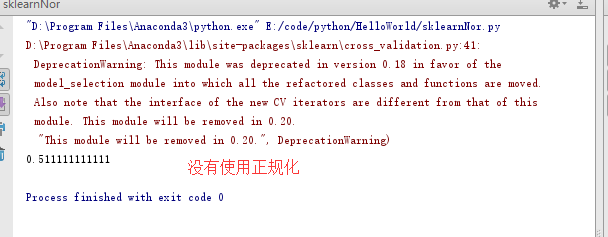
#X=preprocessing.scale(X)

X_train, X_test, y_train, y_test = train_test_split(X, Y, test_size=0.3)

clf = SVC()

clf.fit(X_train, y_train)

print(clf.score(X_test, y_test))
from sklearn import preprocessing

import numpy as np

from sklearn.cross_validation import  train_test_split

from sklearn.datasets.samples_generator import  make_classification

from sklearn.svm import SVC

import matplotlib.pyplot as plt

# a = np.array([[10,2.7,3.6],[-100,5,-2],[120,20,40]],dtype=np.float64)

# print(a)

# print(preprocessing.scale(a))

X,Y = make_classification(n_samples=300,n_features=2,n_redundant=0,n_informative=2,random_state=22, n_clusters_per_class=1, scale=100)

# plt.scatter(X[:, 0], X[:, 1], c=Y)

# plt.show()

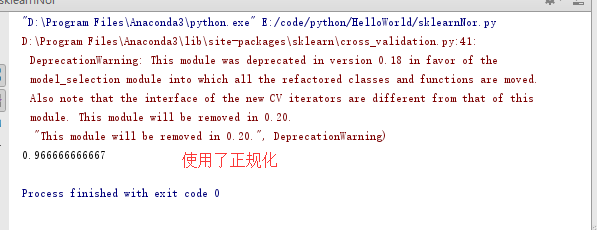
X=preprocessing.scale(X)

X_train, X_test, y_train, y_test = train_test_split(X, Y, test_size=0.3)

clf = SVC()

clf.fit(X_train, y_train)

print(clf.score(X_test, y_test))
sklearn正规化(Normalization或者scale)的更多相关文章
- sklearn数据预处理-scale
对数据按列属性进行scale处理后,每列的数据均值变成0,标准差变为1.可通过下面的例子加深理解: from sklearn import preprocessing import numpy as ...
- normalization正规化
用到sklearn模块 from sklearn import preprocessing用preprocessing.scale正规化 print(preprocessing.scale(a))
- 机器学习-Sklearn
Scikit learn 也简称 sklearn, 是机器学习领域当中最知名的 python 模块之一. Sklearn 包含了很多种机器学习的方式: Classification 分类 Regres ...
- Python中常用包——sklearn主要模块和基本使用方法
在从事数据科学的人中,最常用的工具就是R和Python了,每个工具都有其利弊,但是Python在各方面都相对胜出一些,这是因为scikit-learn库实现了很多机器学习算法. 加载数据(Data L ...
- 【机器学习学习】SKlearn + XGBoost 预测 Titanic 乘客幸存
Titanic 数据集是从 kaggle下载的,下载地址:https://www.kaggle.com/c/titanic/data 数据一共又3个文件,分别是:train.csv,test.csv, ...
- 【机器学习】SKlearn + XGBoost 预测 Titanic 乘客幸存
Titanic 数据集是从 kaggle下载的,下载地址:https://www.kaggle.com/c/titanic/data 数据一共又3个文件,分别是:train.csv,test.csv, ...
- 复盘一篇讲sklearn库的文章(下)
skleran-处理流程 获取数据 以用sklearn的内置数据集, 先导入datasets模块. 最经典的iris数据集作为例子. from sklearn import datasets iris ...
- Scikit-learn:数据预处理Preprocessing data
http://blog.csdn.net/pipisorry/article/details/52247679 本blog内容有标准化.数据最大最小缩放处理.正则化.特征二值化和数据缺失值处理. 基础 ...
- 采用梯度下降优化器(Gradient Descent optimizer)结合禁忌搜索(Tabu Search)求解矩阵的全部特征值和特征向量
[前言] 对于矩阵(Matrix)的特征值(Eigens)求解,采用数值分析(Number Analysis)的方法有一些,我熟知的是针对实对称矩阵(Real Symmetric Matrix)的特征 ...
随机推荐
- runtime-分类为什么不生成setter和getter
前言 前几天有人问我一个问题:为什么分类不能自动创建get set方法.老实说,笔者从来没有去思考过这个问题.于是这次通过代码实践跟runtime源码来探究这个问题. 准备工作 为了能减少输出类数据的 ...
- Python 3 mysql 表操作
Python 3 mysql 表操作 表相当于文件,表中的一条记录就相当于文件的一行内容,不同的是,表中的一条记录有对应的标题,称为表的字段 id,name,qq,age称为字段,其余的,一行内容称为 ...
- [算法]打印N个数组的整体最大Top K
题目: 有N个长度不一的数组,所有的数组都是有序的,请从大到小打印这N个数组整体最大的前K个数. 例如: 输入含有N行元素的二维数组代表N个一维数组. 219,405,538,845,971 148, ...
- php之定义大字符串数据时使用定界符来标识
在定义大字符串数据时,通常使用定界符来标识,这种方式能保留文本中的格式,如文本中的换行.定界符使用格式如下. <<<identifier 格式化文本 identifier 其中,符号 ...
- PHP中有多态么
PHP中有多态么 一.总结 一句话总结:封装是类的构建过程,php具有:php也具有继承的特性.唯独这个多态,php体现的十分模糊.原因是php是弱类型语言. php不具有像java那种清晰的多态,不 ...
- Winform中的dataGridView添加自动编号
1.Winform中的dataGridView添加自动编号:http://blog.csdn.net/ohyoyo2014/article/details/38346887 2.如何为datagrid ...
- [深入学习C#]C#实现多线程的方式:使用Parallel类
简介 在C#中实现多线程的另一个方式是使用Parallel类. 在.NET4中 ,另一个新增的抽象线程是Parallel类 .这个类定义了并行的for和foreach的 静态方法.在为 for和 f ...
- PHP之冒泡排序的优化
冒泡排序是一个常见的排序算法,它重复地走访过要排序的数列,一次比较两个元素,如果他们的顺序错误就把他们交换过来.走访数列的工作是重复地进行直到没有再需要交换,也就是说该数列已经排序完成. 对于冒泡排序 ...
- linux命令学习笔记(18):locate 命令
locate 让使用者可以很快速的搜寻档案系统内是否有指定的档案.其方法是先建立一个包括系统内所有档案名称及 路径的数据库,之后当寻找时就只需查询这个数据库,而不必实际深入档案系统之中了.在一般的 d ...
- Gym - 100851L:Landscape Improved (二分+单调性)
题意: 一个宽度为N的网格图,i上有h[i]高的方块.现在你有W个方块,问怎么放使得最终的最高点最高. 当一个格子的下方,左下方和右下方都有方块那么久可以把方块放到这个格子上.最左端和最右端不能放 ...