
pandas df 遍历行方法
pandas 遍历有以下三种访法。
- iterrows():在单独的变量中返回索引和行项目,但显着较慢
- itertuples():快于.iterrows(),但将索引与行项目一起返回,ir [0]是索引
- zip:最快,但不能访问该行的索引
df= pd.DataFrame({'a': range(0, 10000), 'b': range(10000, 20000)})
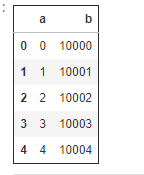
0.for i in df:并不是遍历行的方式
for i in df:

    print(i)
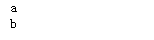
正式因为for in df不是直接遍历行的方式所以我们研究了如下方法。
1.iterrows():在单独的变量中返回索引和行项目,但显着较慢
df.iterrows()其实返回也是一个tuple=>(索引,Series)
count=0

for i,r in df.iterrows():

    print(i,'-->',r,type(r))

    count+=1

    if count>5:

        break

2.itertuples():快于.iterrows(),但将索引与行项目一起返回,ir [0]是索引
count=0

for tup in df.itertuples():

    print(tup[0],'-->',tup[1::],type(tup[1:]))

    count+=1

    if count>5:

        break

3.zip:最快,但不能访问该行的索引
count=0

for tup in zip(df['a'], df['b']):

    print(tup,type(tup[1:]))

    count+=1

    if count>5:

        break

4.性能比较
df = pd.DataFrame({'a': range(0, 10000), 'b': range(10000, 20000)})

import time

list1 = []

start = time.time()

for i,r in df.iterrows():

    list1.append((r['a'], r['b']))

print("iterrows耗时  :",time.time()-start)

list1 = []

start = time.time()

for ir in df.itertuples():

    list1.append((ir[1], ir[2]))

print("itertuples耗时:",time.time()-start)

list1 = []

start = time.time()

for r in zip(df['a'], df['b']):

    list1.append((r[0], r[1]))

print("zip耗时       :",time.time()-start)

pandas df 遍历行方法的更多相关文章
- Pandas 常见的基本方法
说明:文章所有内容均截选自实验楼教程[Pandas 使用教程],想要查看教程完整内容,点击教程即可~ 前言: Pandas 是非常著名的开源数据处理工具,我们可以通过它对数据集进行快速读取.转换.过滤 ...
- pandas DataFrame的创建方法
pandas DataFrame的增删查改总结系列文章: pandas DaFrame的创建方法 pandas DataFrame的查询方法 pandas DataFrame行或列的删除方法 pand ...
- pandas-15 df['one_col'].apply()方法的用法
pandas-15 df['one_col'].apply()方法的用法 apply有点像map的用法,可以传入一个函数. 如:df['A'].apply(str.upper) import nump ...
- 简单又强大的pandas爬虫 利用pandas库的read_html()方法爬取网页表格型数据
文章目录 一.简介 二.原理 三.爬取实战 实例1 实例2 一.简介 一般的爬虫套路无非是发送请求.获取响应.解析网页.提取数据.保存数据等步骤.构造请求主要用到requests库,定位提取数据用的比 ...
- pandas DataFrame的修改方法
pandas DataFrame的增删查改总结系列文章: pandas DaFrame的创建方法 pandas DataFrame的查询方法 pandas DataFrame行或列的删除方法 pand ...
- pandas DataFrame的查询方法(loc,iloc,at,iat,ix的用法和区别)
pandas DataFrame的增删查改总结系列文章: pandas DaFrame的创建方法 pandas DataFrame的查询方法 pandas DataFrame行或列的删除方法 pand ...
- pandas.DataFrame的groupby()方法的基本使用
pandas.DataFrame的groupby()方法是一个特别常用和有用的方法.让我们快速掌握groupby()方法的基础使用,从此数据分析又多一法宝. 首先导入package: import p ...
- jQuery 遍历 - parent() 方法
ylbtech-jQuery-sizzle:jQuery 遍历 - parent() 方法 parent() 获得当前匹配元素集合中每个元素的父元素,使用选择器进行筛选是可选的. 1.A,jQuer ...
- java集合类遍历删除方法测试以及使用场景记录
package test0; import java.util.List; import java.util.Map; import java.util.Map.Entry; import java. ...
随机推荐
- Django2.2连接mysql数据库出现django.core.exceptions.ImproperlyConfigured: mysqlclient 1.3.3 or newer is required; you have 0.7.11.None问题
在使用Django2.2开发的时候,想要使用mysql数据库,在settings.py文件中更改命令: DATABASES = { 'default': { 'ENGINE': 'django.db. ...
- 剑指offer40:一个整型数组里除了两个数字之外,其他的数字都出现了两次。请写程序找出这两个只出现一次的数字
1 题目描述 一个整型数组里除了两个数字之外,其他的数字都出现了两次.请写程序找出这两个只出现一次的数字. 2 思路和方法 (1)异或:除了有两个数字只出现了一次,其他数字都出现了两次.异或运算中,任 ...
- LC 394. Decode String
问题描述 Given an encoded string, return its decoded string. The encoding rule is: k[encoded_string], wh ...
- C - Co-prime
Given a number N, you are asked to count the number of integers between A and B inclusive which are ...
- 【Python基础】09_Python中的元组
1.元组的定义 Tuple (元组)与列表类似,元组的元素 不能修改 元组通常保存 不同类型 的数据 元组用()定义 info_tuple = ("张三", 18, 1.75) 定 ...
- 「网络流 24 题」最长 k 可重区间集
给定区间集合$I$和正整数$k$, 计算$I$的最长$k$可重区间集的长度. 区间离散化到$[1,2n]$, $S$与$1$连边$(k,0)$, $i$与$i+1$连边$(k,0)$, $2n$与$T ...
- 怎样设置cookie生效的域名和路径
Domain 属性指定浏览器发出HTTP请求时, 哪些域名需要附带这个Cookie. 比如 Domain 设置为 example.com, 那 abc.example.com 也会在发起请求时附带这个 ...
- TCP协议探究(二):超时与重试
1 概述 TCP提供可靠的运输层. 可靠性保证之一:确认从另一端收到的数据. 但数据和确认都有可能会丢失.TCP通过在发送时设置一个定时器来解决这种问题. 如果当定时器溢出时还没有收到确认,它就重传该 ...
- canvas之五角星的绘制
<html> <head> <meta charset=utf-8> <title>绘制简单图形线及矩形</title> <style ...
- linux 中free命令
1.free 命令的选项使用 free 命令查看服务器内存使用情况.free [-b|-k|-m|-g|-h] [-l] [-o] [-t] [-s delay] [-c count] [-V](1) ...