
Python之scrapy linkextractors使用错误
1.环境及版本
python3.7.1+scrapy1.5.1
2.问题及错误代码详情
优先贴上问题代码,如下:
import scrapy

from scrapy.linkextractors import LinkExtractor

class MatExamplesSpider(scrapy.Spider):

    name = 'mat_examples'

    # allowed_domains = ['matplotlib.org']

    start_urls = ['https://matplotlib.org/gallery/index.html']

    def parse(self, response):

        le = LinkExtractor(restrict_xpaths='//a[contains(@class, "reference internal")]/@href')

        links = le.extract_links(response)

        print(response.url)

        print(type(links))

        print(links)
运行代码后报错如下:
Traceback (most recent call last):

  File "/Library/Frameworks/Python.framework/Versions/3.7/lib/python3.7/site-packages/twisted/internet/defer.py", line 654, in _runCallbacks

    current.result = callback(current.result, *args, **kw)

  File "/Users/eric.luo/Desktop/Python/matplotlib_examples/matplotlib_examples/spiders/mat_examples.py", line 14, in parse

    links = le.extract_links(response)

  File "/Library/Frameworks/Python.framework/Versions/3.7/lib/python3.7/site-packages/scrapy/linkextractors/lxmlhtml.py", line 128, in extract_links

    links = self._extract_links(doc, response.url, response.encoding, base_url)

  File "/Library/Frameworks/Python.framework/Versions/3.7/lib/python3.7/site-packages/scrapy/linkextractors/__init__.py", line 109, in _extract_links

    return self.link_extractor._extract_links(*args, **kwargs)

  File "/Library/Frameworks/Python.framework/Versions/3.7/lib/python3.7/site-packages/scrapy/linkextractors/lxmlhtml.py", line 58, in _extract_links

    for el, attr, attr_val in self._iter_links(selector.root):

  File "/Library/Frameworks/Python.framework/Versions/3.7/lib/python3.7/site-packages/scrapy/linkextractors/lxmlhtml.py", line 46, in _iter_links

    for el in document.iter(etree.Element):

AttributeError: 'str' object has no attribute 'iter'
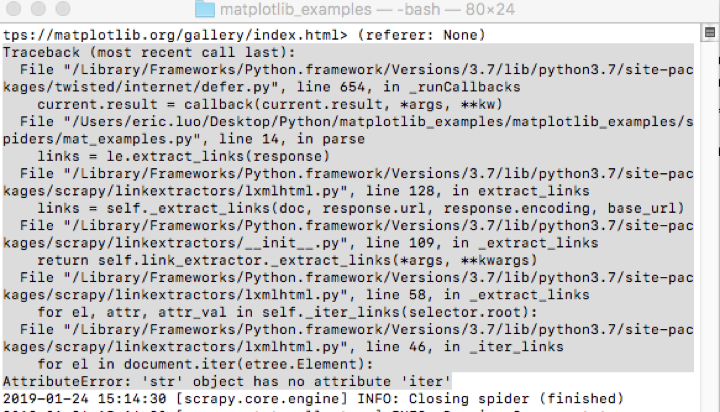
出现错误后自检代码并未发现问题,上网查找也未发现相关的问题;于是将代码改成(restrict_css)去抓取数据,发现是能正常获取到数据的,于是改回xpath;但这次先不使用linkextractor,采用scrapy自带的response.xpath()方法去获取对应链接所在标签的href属性值;发现这样是可以获取到正常的数据的:
即将:
le = LinkExtractor(restrict_xpaths='//a[contains(@class, "reference internal")]/@href')

links = le.extract_links(response)
改成:
links = respon.xpath(‘//a[contains(@class, "reference internal")]/@href').extract()
然后又发现报错是: 'str' object has no attribute 'iter'
而正常返回的links数据类型应该是list才对,不应该是str,所以猜测可能是由于规则写错了导致获取的数据不是list而变成了一个不知道的str;这样针对性的去修改restrict_xpaths中的规则,最后发现去掉/@href后能够获取我所需要的正常的数据;
即将:
le = LinkExtractor(restrict_xpaths='//a[contains(@class, "reference internal")]/@href')
改成:
le = LinkExtractor(restrict_xpaths='//a[contains(@class, "reference internal")]')
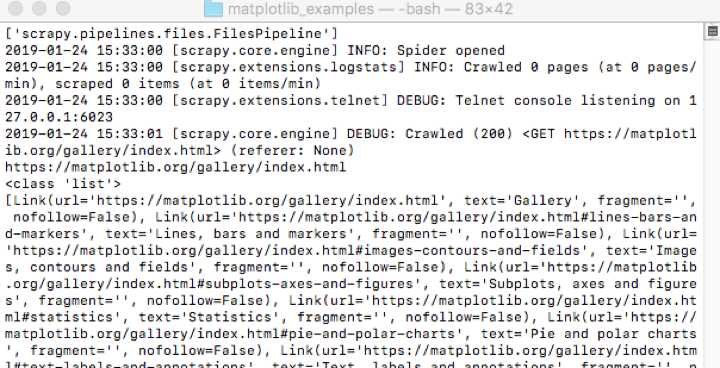
重新运行代码,发现成功获取数据,输出结果如下截图所示:
*****爬虫初学者,不喜勿喷*****
Python之scrapy linkextractors使用错误的更多相关文章
- Python之Scrapy爬虫框架安装及简单使用
题记:早已听闻python爬虫框架的大名.近些天学习了下其中的Scrapy爬虫框架,将自己理解的跟大家分享.有表述不当之处,望大神们斧正. 一.初窥Scrapy Scrapy是一个为了爬取网站数据,提 ...
- [Python爬虫] scrapy爬虫系列 <一>.安装及入门介绍
前面介绍了很多Selenium基于自动测试的Python爬虫程序,主要利用它的xpath语句,通过分析网页DOM树结构进行爬取内容,同时可以结合Phantomjs模拟浏览器进行鼠标或键盘操作.但是,更 ...
- python爬虫scrapy框架
Scrapy 框架 关注公众号"轻松学编程"了解更多. 一.简介 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量 ...
- python之scrapy框架基础搭建
一.创建工程 #在命令行输入scrapy startproject xxx #创建项目 二.写item文件 #写需要爬取的字段名称 name = scrapy.Field() #例 三.进入spide ...
- Python:Scrapy(三) 进阶:额外的一些类ItemLoader与CrawlSpider,使用原理及总结
学习自:Python Scrapy 爬虫框架实例(一) - Blue·Sky - 博客园 这一节是对前两节内容的补充,涉及内容为一些额外的类与方法,来对原代码进行改进 原代码:这里并没有用前两节的代码 ...
- Python爬虫Scrapy框架入门(0)
想学习爬虫,又想了解python语言,有个python高手推荐我看看scrapy. scrapy是一个python爬虫框架,据说很灵活,网上介绍该框架的信息很多,此处不再赘述.专心记录我自己遇到的问题 ...
- dota玩家与英雄契合度的计算器,python语言scrapy爬虫的使用
首发:个人博客,更新&纠错&回复 演示地址在这里,代码在这里. 一个dota玩家与英雄契合度的计算器(查看效果),包括两部分代码: 1.python的scrapy爬虫,总体思路是pag ...
- python爬虫scrapy框架——人工识别登录知乎倒立文字验证码和数字英文验证码(2)
操作环境:python3 在上一文中python爬虫scrapy框架--人工识别知乎登录知乎倒立文字验证码和数字英文验证码(1)我们已经介绍了用Requests库来登录知乎,本文如果看不懂可以先看之前 ...
- python爬虫Scrapy(一)-我爬了boss数据
一.概述 学习python有一段时间了,最近了解了下Python的入门爬虫框架Scrapy,参考了文章Python爬虫框架Scrapy入门.本篇文章属于初学经验记录,比较简单,适合刚学习爬虫的小伙伴. ...
随机推荐
- 你不知道的JavaScript--Item33 跨域总结与解决的方法
一.神马是跨域(Cross Domain) 说白点就是post.get的url不是你当前的站点,域名不同.比如在*aaa.com/a.html*里面,表单的提交action是bbb.com/b.htm ...
- spring+springmvc+hibernate架构、maven分模块开发样例小项目案例
maven分模块开发样例小项目案例 spring+springmvc+hibernate架构 以用户管理做測试,分dao,sevices,web层,分模块开发測试!因时间关系.仅仅測查询成功.其它的准 ...
- 抽象类(Abstract)和接口的不同点、共同点(Interface)。
同样点: (1) 都能够被继承 (2) 都不能被实例化 (3) 都能够包括方法声明 (4) 派生类必须实现未实现的方法 区 别: (1) 抽象基类能够定义字段.属性.方法实现.接口仅仅能定义属性.索引 ...
- 虚函数的特点就是执行的时候会下降到子类去执行同名覆盖函数 good
var t: TBitBtn;begin t:=TBitBtn.Create(nil); t.Name:='BitBtn100'; t.parent :=Self; // 这里下断点end; 一路跟踪 ...
- luogu1197 [JSOI2008]星球大战
题目大意 有一个无向图,每次删除一个节点,求删除后图中连通块的个数.(如果两个星球可以通过现存的以太通道直接或间接地连通,则这两个星球在同一个连通块中) 题解 连通块?用并查集可以找到一个连通块,但是 ...
- C# Path 有关于文件路径获取的问题 的方法
string Current = Directory.GetCurrentDirectory();//获取当前根目录 //private string strFilePath = Applicatio ...
- 【NOI 2014】 动物园
[题目链接] https://www.lydsy.com/JudgeOnline/problem.php?id=3670 [算法] KMP [代码] #include<bits/stdc++.h ...
- poj1041 John's trip——字典序欧拉回路
题目:http://poj.org/problem?id=1041 求字典序欧拉回路: 首先,如果图是欧拉图,就一定存在欧拉回路,直接 dfs 即可,不用 return 判断什么的,否则TLE... ...
- Java项目打包发布
Java项目打包发布 如果只想发布为一个可执行的jar包,使用eclipse的Export功能就可以了 使用eclipse的Export功能,将项目中的所有package打包为一个pet.jar文件, ...
- 当Shell遇上了Node.js(转载)
转载:http://developer.51cto.com/art/201202/315066.htm 好吧,我承认,这个标题有点暧昧的基情,但是希望下文的内部能给不熟悉或不喜欢Shell或WIN平台 ...