
Python爬虫——request实例:爬取网易云音乐华语男歌手top10歌曲
requests是python的一个HTTP客户端库,跟urllib,urllib2类似,但比那两个要简洁的多,至于request库的用法,
推荐一篇不错的博文:https://cuiqingcai.com/2556.html
话不多说,先说准备工作:
1,下载需要的库:request,BeautifulSoup( 解析html和xml字符串),xlwt(将爬取到的数据存入Excel表中)
2,至于BeautifulSoup 解析html方法,推荐一篇博文:http://blog.csdn.net/u013372487/article/details/51734047
3,re库,我们要用正则表达式来筛选爬取到的内容
好的,开始爬:
首先我们找到网易云音乐华语男歌手页面入口的URL:url = 'http://music.163.com/discover/artist/cat?id=1001'
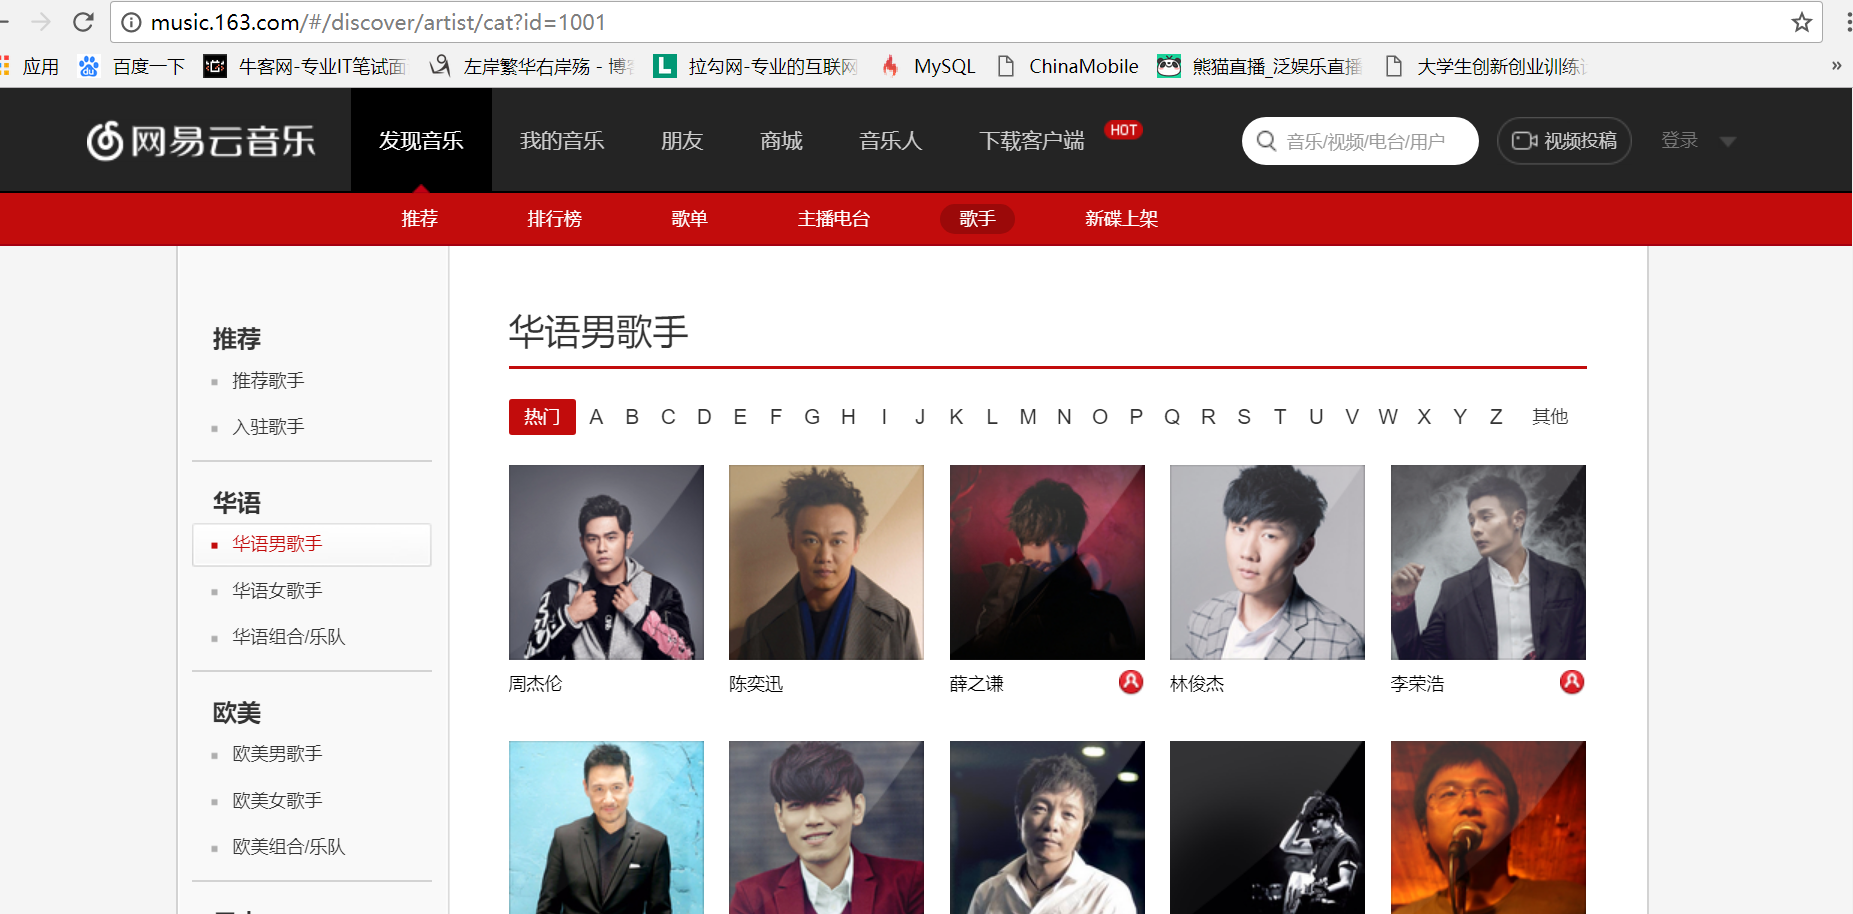
把整个网页爬取下来: html= requests.get(url).text
soup = BeautifulSoup(html,'html.parser'
我们要找到进入top10歌手页面的url,用浏览器的开发者工具,我们发现歌手的信息
都在<div class="u-cover u-cover-5">......</div>这个标签里面,如图:
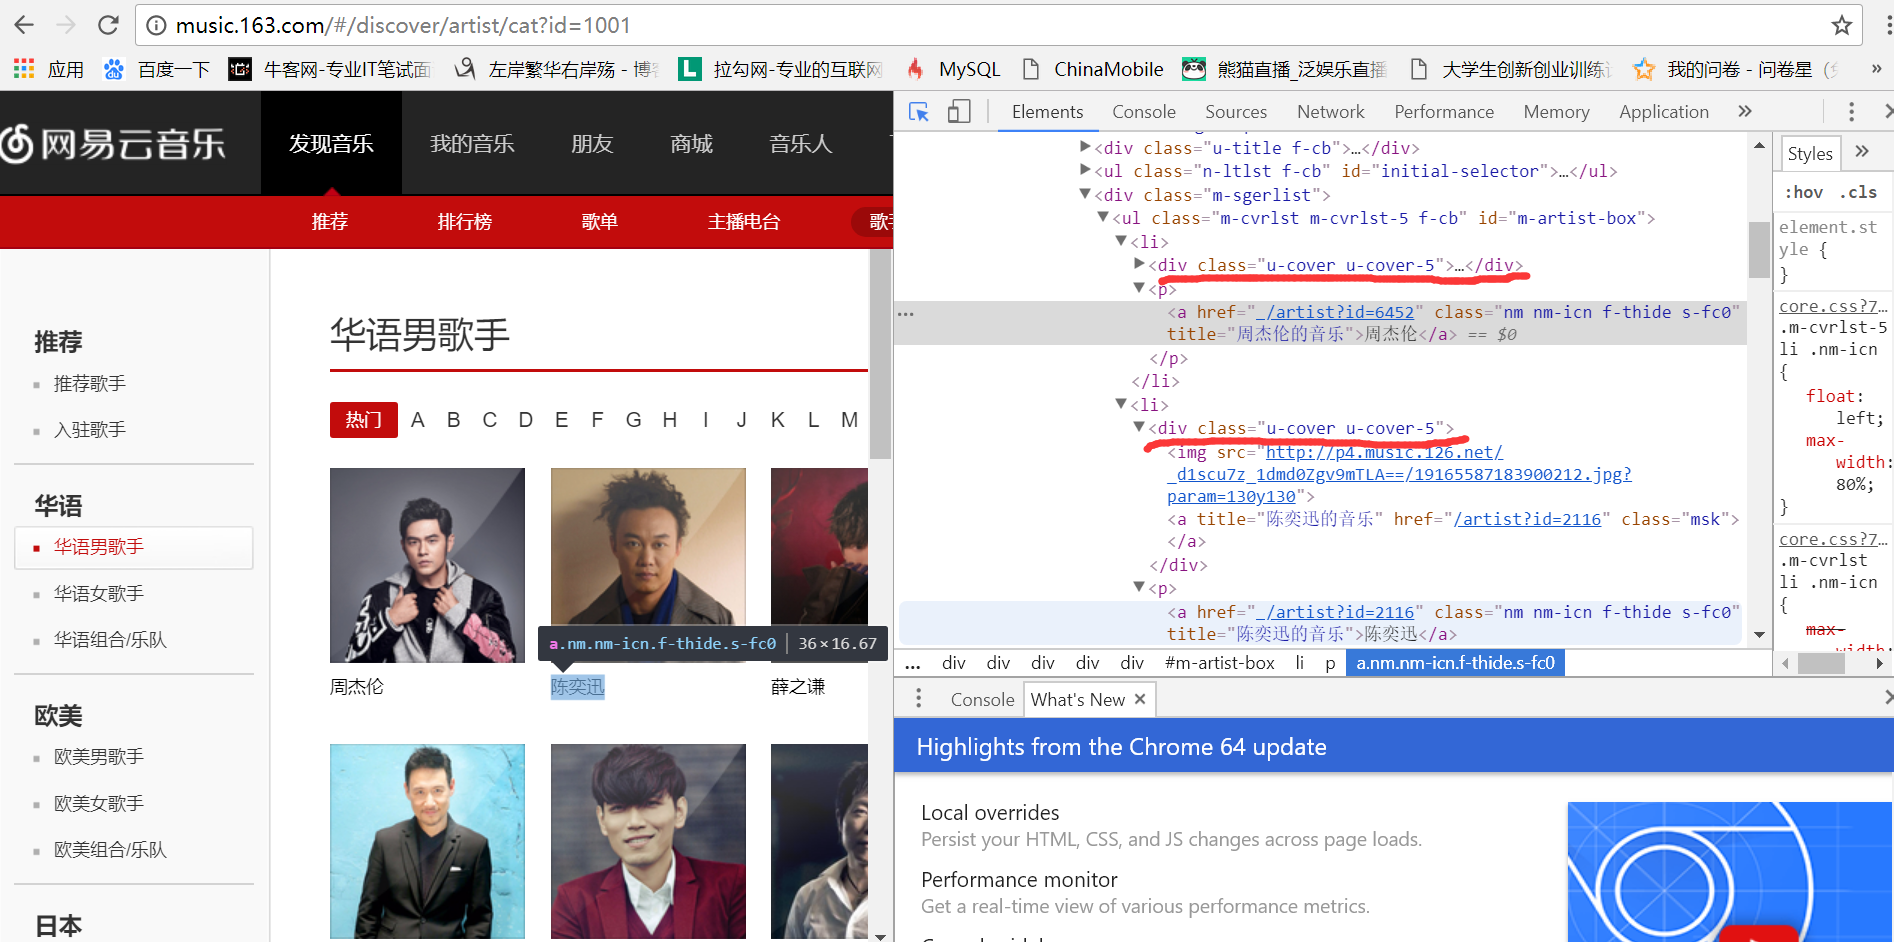
于是,我们把top10歌手的信息筛选出来:
top_10 = soup.find_all('div',attrs = {'class':'u-cover u-cover-5'})
singers = []
for i in top_10:
singers.append(re.findall(r'.*?<a class="msk" href="(/artist\?id=\d+)" title="(.*?)的音乐"></a>.*?',str(i))[0])
获取到歌手的信息后,依次进入歌手的界面,把他们的热门歌曲爬取并写入Excel表中,原理同上
附上完整代码:
 import xlwt

 import requests

 from bs4 import BeautifulSoup

 import re

 url = 'http://music.163.com/discover/artist/cat?id=1001'#华语男歌手页面

 r = requests.get(url)

 r.raise_for_status()

 r.encoding = r.apparent_encoding

 html=r.text  #获取整个网页

 soup = BeautifulSoup(html,'html.parser') #

 top_10 = soup.find_all('div',attrs = {'class':'u-cover u-cover-5'})

 #print(top_10)

 singers = []

 for i in top_10:

     singers.append(re.findall(r'.*?<a class="msk" href="(/artist\?id=\d+)" title="(.*?)的音乐"></a>.*?',str(i))[0])

 #print(singers)

 url = 'http://music.163.com'

 for singer in singers:

         try:

             new_url = url + str(singer[0])

             #print(new_url)

             songs=requests.get(new_url).text

             soup = BeautifulSoup(songs,'html.parser')

             Info = soup.find_all('textarea',attrs = {'style':'display:none;'})[0]

             songs_url_and_name = soup.find_all('ul',attrs = {'class':'f-hide'})[0]

             #print(songs_url_and_name)

             datas = []

             data1 = re.findall(r'"album".*?"name":"(.*?)".*?',str(Info.text))

             data2 = re.findall(r'.*?<li><a href="(/song\?id=\d+)">(.*?)</a></li>.*?',str(songs_url_and_name))

             for i in range(len(data2)):

                 datas.append([data2[i][1],data1[i],'http://music.163.com/#'+ str(data2[i][0])])

             #print(datas)

             book = xlwt.Workbook()

             sheet1=book.add_sheet('sheet1',cell_overwrite_ok = True)

             sheet1.col(0).width = (25*256)

             sheet1.col(1).width = (30*256)

             sheet1.col(2).width = (40*256)

             heads=['歌曲名称','专辑','歌曲链接']

             count=0

             for head in heads:

                 sheet1.write(0,count,head)

                 count+=1

             i=1

             for data in datas:

                 j=0

                 for k in data:

                     sheet1.write(i,j,k)

                     j+=1

                 i+=1

             book.save(str(singer[1])+'.xls')#括号里写存入的地址

         except:

             continue
Python爬虫——request实例:爬取网易云音乐华语男歌手top10歌曲的更多相关文章
- 如何用Python网络爬虫爬取网易云音乐歌曲
今天小编带大家一起来利用Python爬取网易云音乐,分分钟将网站上的音乐down到本地. 跟着小编运行过代码的筒子们将网易云歌词抓取下来已经不再话下了,在抓取歌词的时候在函数中传入了歌手ID和歌曲名两 ...
- python网络爬虫&&爬取网易云音乐
#爬取网易云音乐 url="https://music.163.com/discover/toplist" #歌单连接地址 url2 = 'http://music.163.com ...
- python爬虫+词云图,爬取网易云音乐评论
又到了清明时节,用python爬取了网易云音乐<清明雨上>的评论,统计词频和绘制词云图,记录过程中遇到一些问题 爬取网易云音乐的评论 一开始是按照常规思路,分析网页ajax的传参情况.看到 ...
- 爬取网易云音乐评论!python 爬虫入门实战(六)selenium 入门!
说到爬虫,第一时间可能就会想到网易云音乐的评论.网易云音乐评论里藏了许多宝藏,那么让我们一起学习如何用 python 挖宝藏吧! 既然是宝藏,肯定是用要用钥匙加密的.打开 Chrome 分析 Head ...
- python爬虫:了解JS加密爬取网易云音乐
python爬虫:了解JS加密爬取网易云音乐 前言 大家好,我是"持之以恒_liu",之所以起这个名字,就是希望我自己无论做什么事,只要一开始选择了,那么就要坚持到底,不管结果如何 ...
- 用Python爬取网易云音乐热评
用Python爬取网易云音乐热评 本文旨在记录Python爬虫实例:网易云热评下载 由于是从零开始,本文内容借鉴于各种网络资源,如有侵权请告知作者. 要看懂本文,需要具备一点点网络相关知识.不过没有关 ...
- Python爬取网易云音乐歌手歌曲和歌单
仅供学习参考 Python爬取网易云音乐网易云音乐歌手歌曲和歌单,并下载到本地 很多人学习python,不知道从何学起.很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手.很多已经做 ...
- python爬取网易云音乐歌曲评论信息
网易云音乐是广大网友喜闻乐见的音乐平台,区别于别的音乐平台的最大特点,除了“它比我还懂我的音乐喜好”.“小清新的界面设计”就是它独有的评论区了——————各种故事汇,各种金句频出.我们可以透过歌曲的评 ...
- python3爬虫应用--爬取网易云音乐(两种办法)
一.需求 好久没有碰爬虫了,竟不知道从何入手.偶然看到一篇知乎的评论(https://www.zhihu.com/question/20799742/answer/99491808),一时兴起就也照葫 ...
随机推荐
- java读取数据写入txt文件并将读取txt文件写入另外一个表
package com.xsw.test; import java.io.BufferedReader; import java.io.BufferedWriter; import java.io.F ...
- Java日期操作工具类
/** * 格式化日期显示格式 * * @param sdate * 原始日期格式 s - 表示 "yyyy-mm-dd" 形式的日期的 String 对象 * @param fo ...
- Android HTTP请求用HttpUrlConnection与HttpClient比较
在安卓和JAVA应用开发中需要访问网络,少不了要提交HTTP请求,而基本上目前有两个实现方式:HttpUrlConnection(即URL.openConnection)和HttpClient. 网上 ...
- java注解之二
从JDK5开始,Java增加了Annotation(注解),Annotation是代码里的特殊标记,这些标记可以在编译.类加载.运行时被读取,并执行相应的处理.通过使用Annotation,开发人员可 ...
- Java中用正则表达式判断日期格式是否正确
1.Java中用正则表达式判断日期格式是否正确 DateType.java: /** * @Title:DateType.java * @Package:com.you.dao * @Descript ...
- Java之List排序出错
Java之List排序出错 Bound mismatch: The generic method sort(List<T>) of type Collections is not appl ...
- linux和windows通用的路径
String path=request.getSession().getServletContext().getRealPath("/")+"js" + Sys ...
- Html行内元素和块级元素
1.关于行内元素和块状元素的说明 根据CSS规范的规定,每一个网页元素都有一个display属性,用于确定该元素的类型,每一个元素都有默认的display属性值,比如div元素,它的默认display ...
- TensorLayer官方中文文档1.7.4:API – 可视化
API - 可视化¶ TensorFlow 提供了可视化模型和激活输出等的工具 TensorBoard. 在这里,我们进一步提供一些可视化模型参数和数据的函数. read_image(image[, ...
- 深度学习框架: Keras官方中文版文档正式发布
今年 1 月 12 日,Keras 作者 François Chollet 在推特上表示因为中文读者的广泛关注,他已经在 GitHub 上展开了一个 Keras 中文文档项目.而昨日,Françoi ...