
caffe 根据txt生成多标签LMDB数据
1. 前提:
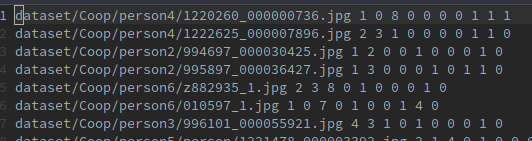
- 已经准备好train.txt, test.txt文件, 格式如下
此处有坑, 如果是windows下生成txt, 换行符为\r\n, 需要替换成 \n才能在linux运行.
可以使用sed -i "s/\s*$//g" filename统一去掉, 具体参考除去文件中显示的^M符号
- 已经编译好了支持多标签的caffe, 具体见多标签caffe重新编译

2. 编辑生成lmdb用的txt2lmdb.sh
以下是我的sh文件:
#!/usr/bin/env sh

# Create the imagenet lmdb inputs

####################################################

# 配置

####################################################

EXAMPLE=/home/zhuoshi/ZSZT/Geoffrey/Person-resnet18/lmdb_data		# lmdb存储位置

DATA=/home/zhuoshi/ZSZT/Geoffrey/Person-resnet18/data					# txt文件所在文件夹 - 同时也是.txt相对路径的起始点(图片绝对路径=$DATA+txt中相对路径)

CAFFE_HOME=/home/zhuoshi/ZSZT/Geoffrey/caffe/caffe-master          		# caffe的工具库

HEIGHT=256

WIDTH=256

####################################################

# 处理train

####################################################

echo "Creating train lmdb..."

TRAIN_PATH=$EXAMPLE/img_train_lmdb

# 如果存在,删除原数据

if [ ! -d "$TRAIN_PATH/" ];then

	echo "文件不存在"

	mkdir -p $TRAIN_PATH/

else

	echo "$TRAIN_PATH文件夹已存在"

	rm -rf $TRAIN_PATH/

	# mkdir -p $TRAIN_PATH/

fi

# 生成lmdb

$CAFFE_HOME/build/tools/convert_imageset --shuffle --resize_height=$HEIGHT --resize_width=$WIDTH  $DATA/  $DATA/train.txt  $TRAIN_PATH  #

echo "Creating train lmdb Done!, Create mean.binaryproto..."

# # 计算图片均值

$CAFFE_HOME/build/tools/compute_image_mean $TRAIN_PATH/ $TRAIN_PATH/mean.binaryproto

echo "train Done!"

####################################################

# 处理test

####################################################

echo "Creating test lmdb ..."

TEST_PATH=$EXAMPLE/img_test_lmdb

# 如果存在,删除原数据

if [ ! -d "$TEST_PATH/" ];then

	echo "文件不存在"

	mkdir $TEST_PATH

else

	echo "$TEST_PATH文件夹已存在"

	rm -rf $TEST_PATH/

	# mkdir $TEST_PATH/

fi

# 生成lmdb

$CAFFE_HOME/build/tools/convert_imageset --shuffle --resize_height=256 --resize_width=256  $DATA/  $DATA/test.txt  $TEST_PATH  #

echo "Creating test lmdb Done!, Create mean.binaryproto..."

# # 计算图片均值

$CAFFE_HOME/build/tools/compute_image_mean $TEST_PATH/ $TEST_PATH/mean.binaryproto

echo "test Done!"

####################################################

echo "Done."
其中:
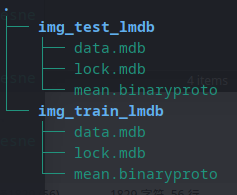
- EXAMPLE, 把生成的lmdb存储到什么位置
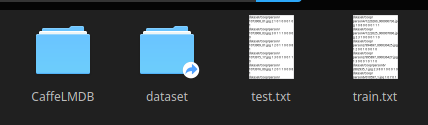
- DATA .txt存放绝对路径, 同时也是父目录, 即图片绝对路径=$DATA+txt中相对路径:
我的txt路径:
txt图片相对路径:
3. 运行
执行`sh txt2lmdb.sh`, (txt2lmdb.sh为脚本所在路径)
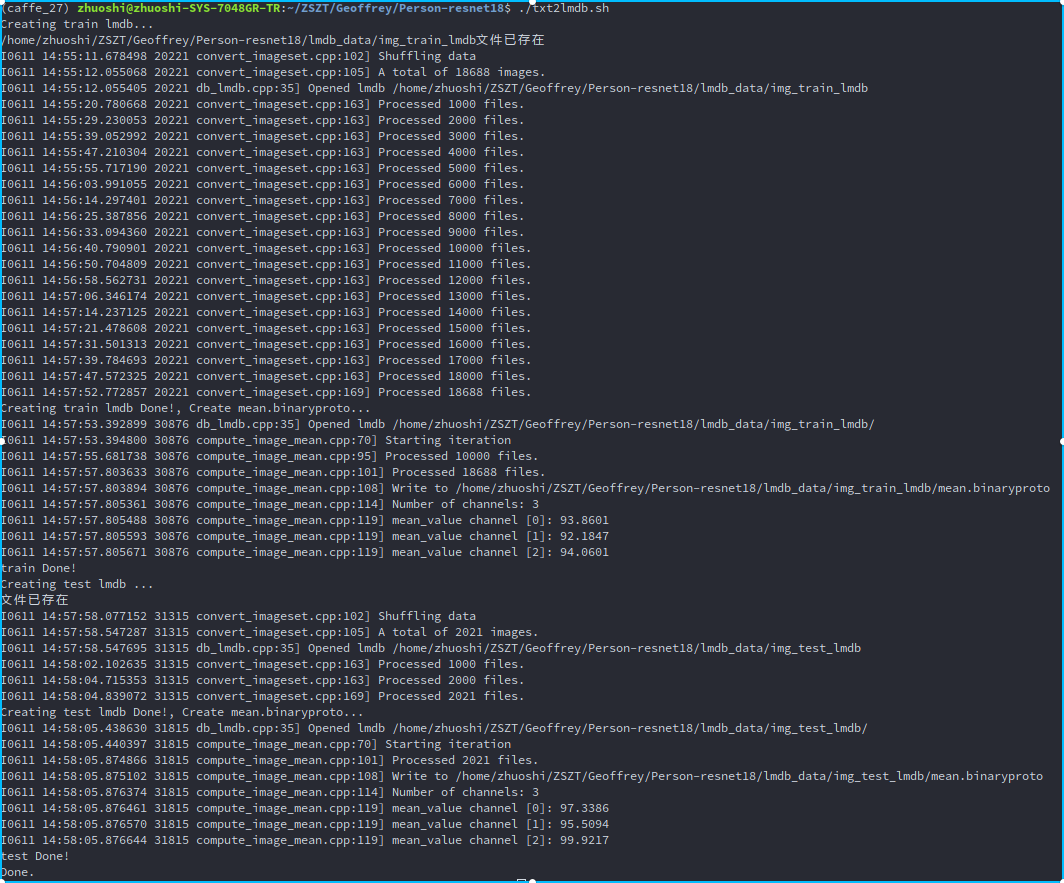
脚本会在$EXAMPLE下生成如下结果:
下面记录一下caffe自带的均值转换工具compute_image_mean.cpp参数:
$CAFFE_HOME/build/tools/compute_image_mean $TEST_PATH/ $TEST_PATH/mean.binaryproto
带两个参数:
- 第一个参数:$TEST_PATH/, 表示需要计算均值的数据,格式为lmdb的训练数据。
- 第二个参数:$TEST_PATH/mean.binaryproto, 计算出来的结果保存文件。
( 图片减去均值后,再进行训练和测试,会提高速度和精度。)
caffe 根据txt生成多标签LMDB数据的更多相关文章
- python 操作txt 生成新的文本数据
name: Jack ; salary: 12000 name :Mike ; salary: 12300 name: Luk ; salary: 10030 name :Tim ; salary: ...
- caffe读取多标签的lmdb数据
问题描述: lmdb文件支持数据+标签的形式,但是却只能写入一个标签,引入多标签的解决方法有很多,这儿详细说一下我的办法:制作多个data数据,分别加入一个标签.我的方法只适用于标签数量较少的情况,标 ...
- Caffe系列2——Windows10制作LMDB数据详细过程(手把手教你制作LMDB)
Windows10制作LMDB详细教程 原创不易,转载请注明出处:https://www.cnblogs.com/xiaoboge/p/10678658.html 摘要: 当我们在使用Caffe做深度 ...
- 【应用】:shell crontab定时生成oracle表的数据到txt文件,并上传到ftp
一.本人环境描述 1.oracle服务端装在win7 32位上,oracle版本为10.2.0.1.0 2.Linux为centos6.5 32位,安装在Oracle VM Vir ...
- Java-读取txt生成excel
本段代码的目的是从txt文本中读取相应格式的数据,然后写入到对应格式的excel文档中 在敲本段代码的时候,也学习了一些其它知识点,如下: 1.byte[] b_charset= String.get ...
- struts2标签库----数据标签详解
上篇文章我们介绍struts2标签库中的控制标签的基本使用和部分原理,本篇文章接着了解下标签库中有关数据标签的使用和原理.主要涉及以下数据标签: action标签:用于在视图页面跳转到一个Action ...
- caffe 用faster rcnn 训练自己的数据 遇到的问题
1 . 怎么处理那些pyx和.c .h文件 在lib下有一些文件为.pyx文件,遇到不能import可以cython 那个文件,然后把lib文件夹重新make一下. 遇到.c 和 .h一样的操作. 2 ...
- Djanog|requirements.txt生成
Django | requirement.txt 生成 pip django 1 pip 通常我们熟悉使用的都是 pip, 这个工具确实方便项目管理依赖包.当想把当前项目依赖的包的名称和版本导入指 ...
- 动态生成li标签,并设置点击事件
今天要解释的是如下界面 主要实现了: 1.模拟后台的json数据,动态生成li标签 2.导航栏的下划线 3.给li标签右边设置图片 4.动态生成的li标签,设置选中的li的点 ...
随机推荐
- SAVEPOINT 标记
create table duo( --创建表格 v_xuhao number(3), v_name varch ...
- 移动端返回上一页,刚需!document.referrer 详解
返回上一页,在PC端我们可以使用:history.go(-1)或者history.back(),可以正常返回第一层.这样,我们不需要上一页的 url 具体是什么,只要使用 history 一般都没啥问 ...
- ef mysql
App.config <configuration> <configSections> <!-- For more information on Entity Frame ...
- js下载后台返回的docx(返回格式:文档流)文件
原文地址: https://www.jianshu.com/p/a81c68c15fbd PS需要指定responseType类型,不然文件内容会乱码哦 咦?文件名乱码?需要手动设置文件名哦↓ 呀,文 ...
- Mybatis操作oracle数据库的一些坑
oracle区分大小写,如果不想区分,必须要用引号包住 使用mybatis的generator生成的时候,建议使用全大写表,中间用下划线隔开,会生成驼峰字段 oracle没有空字符串的概念 写myba ...
- input子系统 KeyPad-Touch上报数据格式与机制【转】
转自:https://www.cnblogs.com/0822vaj/p/4185634.html -------------------------------------------------- ...
- 结合jira搭建自动化测试平台
mysql 语句查看 python manage.py sqlmigrate your_app_name 0001 代码如下 #coding=utf8 #https://jira.readthedoc ...
- webpack打包文件
npm init -y//生成package.json npm install webpack webpack-cli --save-dev//安装webpack和webpack-cli根据入口文件. ...
- scrapy 爬取时很多重复 及日志输出
日志输出参考:https://blog.csdn.net/weixin_41666747/article/details/82716688 首先 item 要设置循环外 第二,request 要设置下 ...
- Maven Install报错:Perhaps you are running on a JRE rather than a JDK?
我用的是idea,解决办法是:安装jdk,配置环境变量