
寻找U2OS中表达的基因及其promoter并用于后续annotation
方法1.RNA-seq得到不同表达程度基因
方法2. 直接download U2OS_gene.csv https://cancer.sanger.ac.uk/cell_lines/download
最开始excel直接选用25%最高和25%最低,U2OS细胞共~16000基因,故复制前4000行的gene symbol并存为txt;
table browser下载'group:Genes and gene prediction; track:UCSC genes; outpu format:selected fileds from primary and related tables' then getoutput,如下图选择
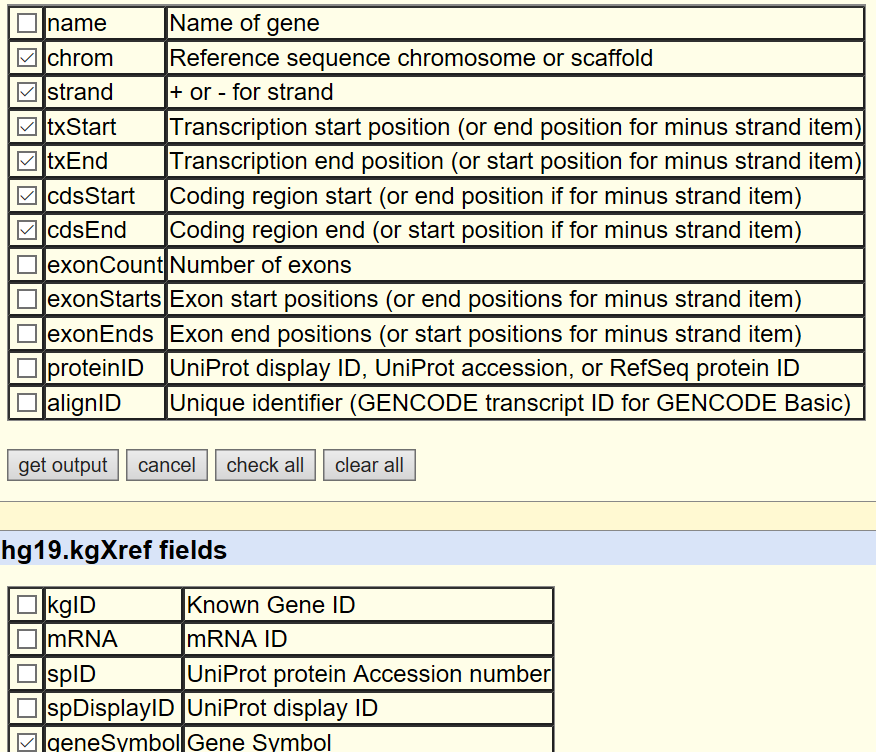
问题出现在grep -wFf 25%_most_highly_expressed_gene_name.txt hg19_geneid_genesymbol.txt > 25%_most_highly_expressed_geneid.txt总是没有输出
trouble shooting首先检查代码,自定义两个文件1.txt 2.txt然后 grep -wFf 1.txt 2.txt成功;
然后检查输入文件hg19_geneid_genesymbol.txt,自定义基因文件(随便选几个U2OS/non-U2OS基因 vi gene.txt),grep -wFf gene.txt hg19_geneid_genesymbol.txt成功;
最后发现问题出在25%_most_highly_expressed_gene_name.txt,最开始得到这个文件是直接从csv中copy and paste,但csv是 comma delimited,所以复制事实上连,一起复制了
#$ head U2OS_genes.csv

#$ head 25%_most_highly_expressed_gene_name.txt

事实上在做grep的时候是“ ,MED6, ”,因此无法匹配 hg19_geneid_genesymbol.txt,这也是为什么grep 'MED6' hg19_geneid_genesymbol.txt 可以work的原因
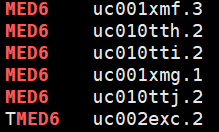
正确做法
#0.6是第4000个基因的zscore
awk -F',' '$5 > 0.6 {print $3}' U2OS_genes.csv > 25%_most_highly_expressed_gene_name.txt
0.6有点过低,做zscore散点图可发现用2更为合理
awk -F',' '$5 > 2 {print $3}' U2OS_genes.csv > highest_expressed_gene_name.txt

更为准确的方法是用R quantile得到合适Z score筛选得到most_expressed 和 least_expressed
grep -wFf highest_expressed_genesym.txt gene_hg19.bed > highest_expressed_gene.bed
PS:head gene_hg19.bed


一个基因有不同的cds
https://www.jianshu.com/p/cc5cd7053d6e
寻找U2OS中表达的基因及其promoter并用于后续annotation的更多相关文章
- 逆向知识第八讲,if语句在汇编中表达的方式
逆向知识第八讲,if语句在汇编中表达的方式 一丶if else的最简单情况还原(无分支情况) 高级代码: #include "stdafx.h" int main(int argc ...
- 寻找数组中的第K大的元素,多种解法以及分析
遇到了一个很简单而有意思的问题,可以看出不同的算法策略对这个问题求解的优化过程.问题:寻找数组中的第K大的元素. 最简单的想法是直接进行排序,算法复杂度是O(N*logN).这么做很明显比较低效率,因 ...
- 利用Manacher算法寻找字符串中的最长回文序列(palindrome)
寻找字符串中的最长回文序列和所有回文序列(正向和反向一样的序列,如aba,abba等)算是挺早以前提出的算法问题了,最近再刷Leetcode算法题的时候遇到了一个(题目),所以就顺便写下. 如果用正反 ...
- 实现一个算法,寻找字符串中出现次数最少的、并且首次出现位置最前的字符 如"cbaacfdeaebb",符合要求的是"f",因为他只出现了一次(次数最少)。并且比其他只出现一次的字符(如"d")首次出现的位置最靠前。
实现一个算法,寻找字符串中出现次数最少的.并且首次出现位置最前的字符如"cbaacfdeaebb",符合要求的是"f",因为他只出现了一次(次数最少).并且比其 ...
- [经典算法题]寻找数组中第K大的数的方法总结
[经典算法题]寻找数组中第K大的数的方法总结 责任编辑:admin 日期:2012-11-26 字体:[大 中 小] 打印复制链接我要评论 今天看算法分析是,看到一个这样的问题,就是在一堆数据 ...
- 寻找数组中第K大数
1.寻找数组中的第二大数 using System; using System.Collections.Generic; using System.Linq; using System.Text; u ...
- C语言中表达n次方
C语言中表达n次方可以用pow函数. 函数原型:double pow(double x, double y) 功 能:计算x^y的值 返 回 值:计算结果 举例: double a; a = p ...
- Java实现 蓝桥杯 算法训练 寻找数组中最大值
算法训练 寻找数组中最大值 时间限制:1.0s 内存限制:512.0MB 提交此题 问题描述 对于给定整数数组a[],寻找其中最大值,并返回下标. 输入格式 整数数组a[],数组元素个数小于1等于10 ...
- WPF:指定的命名连接在配置中找不到、非计划用于 EntityClient 提供程序或者无效的解决方法
文/嶽永鹏 WPF 数据绑定中绑定到ENTITY,如果把数据文件做成一个类库,在UI文件中去应用它,可能遇到下面这种情况. 指定的命名连接在配置中找不到.非计划用于 EntityClient 提供程序 ...
随机推荐
- 2017 United Kingdom and Ireland Programming Contest (UKIEPC 2017)
A. Alien Sunset 暴力枚举答案即可. #include<cstdio> int n,i,mx; struct P{ int h,r,t; bool night(int x){ ...
- PHP定界符<<<EOF
PHP定界符<<<EOF 一.为什么需要使用定界符: 因为在编程过程中难免会遇到用echo来输出大段的html和javascript脚本的情况, 如果用传统的输出方法 ——按字符串输 ...
- __x__(13)0906第三天__xhtml 的语法规范
html中不区分大小写,但是最好用小写. 注释不能嵌套. html标签必须结束,即 <></> 或者 < /> html标签不能交叉嵌套. html的标签,有 ...
- react_app 项目开发 (3)_单页面设计_react-router4
(web) 利用 react-router4 实现 单页面 开发 SPA 应用 ---- (Single Page Web Application) 整个应用只有 一个完整的页面 单击链接不会刷新页面 ...
- mongodb聚合命令
聚合aggregate 聚合(aggregate)是基于数据处理的聚合管道,每个文档通过一个由多个阶段(stage)组成管道,可以对每个阶段的管道进行分组.过滤等功能,然后经过一系列的处理,输出相应的 ...
- smarty 循环一维关联数组
<?php $oStatusList = array('1'=>'待投放','2'=>'正在运行','3'=>'暂停','4'=>'已完成','5'=>'已删除') ...
- Confluo: Distributed Monitoring and Diagnosis Stack for High-speed Networks
https://rise.cs.berkeley.edu/blog/confluo-millisecond-level-queries-on-large-scale-streaming-data/ht ...
- 工作中对git使用的总结
git与svn的区别,简单的说, svn在checkout后,如果不提交,那么版本库没有记录,如果修改的文件比较多,中间想回退几个文件,非常麻烦.git 是clone下来代码和记录,不提交 ...
- vue 子组件调用父组件的方法
vue中 父子组件的通信: 子组件通过 props: { //子组件中写的. childMsg: { //字段名 type: Array,//类型 default: [0,0,0] //这样可以指定默 ...
- 【论文阅读】Deep Mixture of Diverse Experts for Large-Scale Visual Recognition
导读: 本文为论文<Deep Mixture of Diverse Experts for Large-Scale Visual Recognition>的阅读总结.目的是做大规模图像分类 ...