
论文笔记:Prediction-Tracking-Segmentation
Prediction-Tracking-Segmentation
2019-04-09 18:47:30
Paper:https://arxiv.org/pdf/1904.03280.pdf
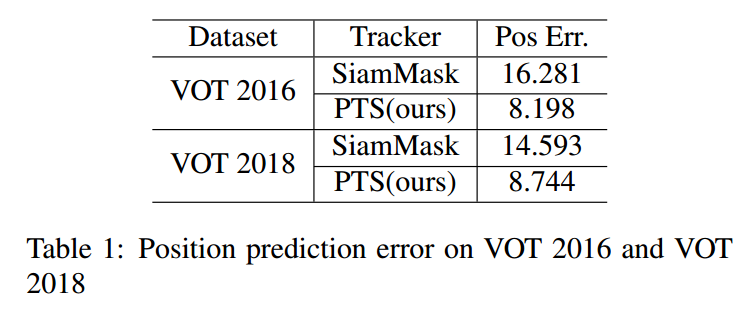
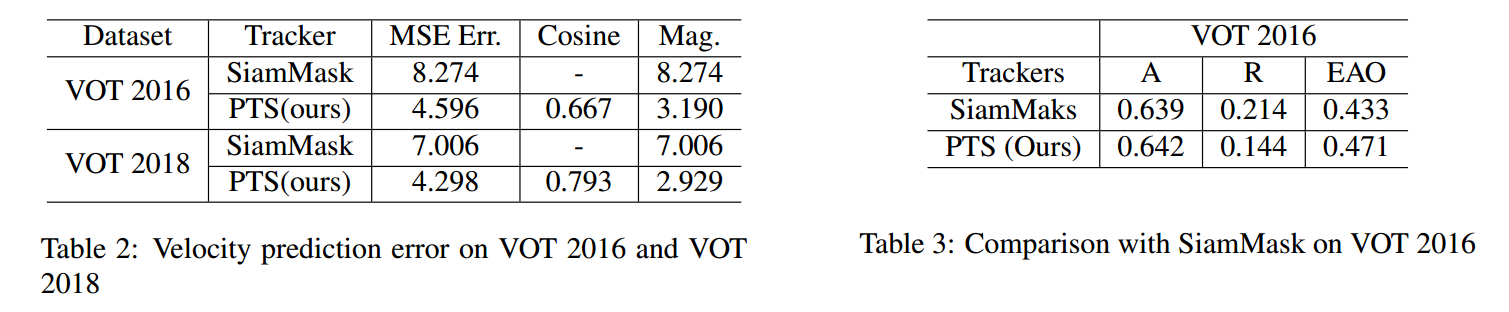
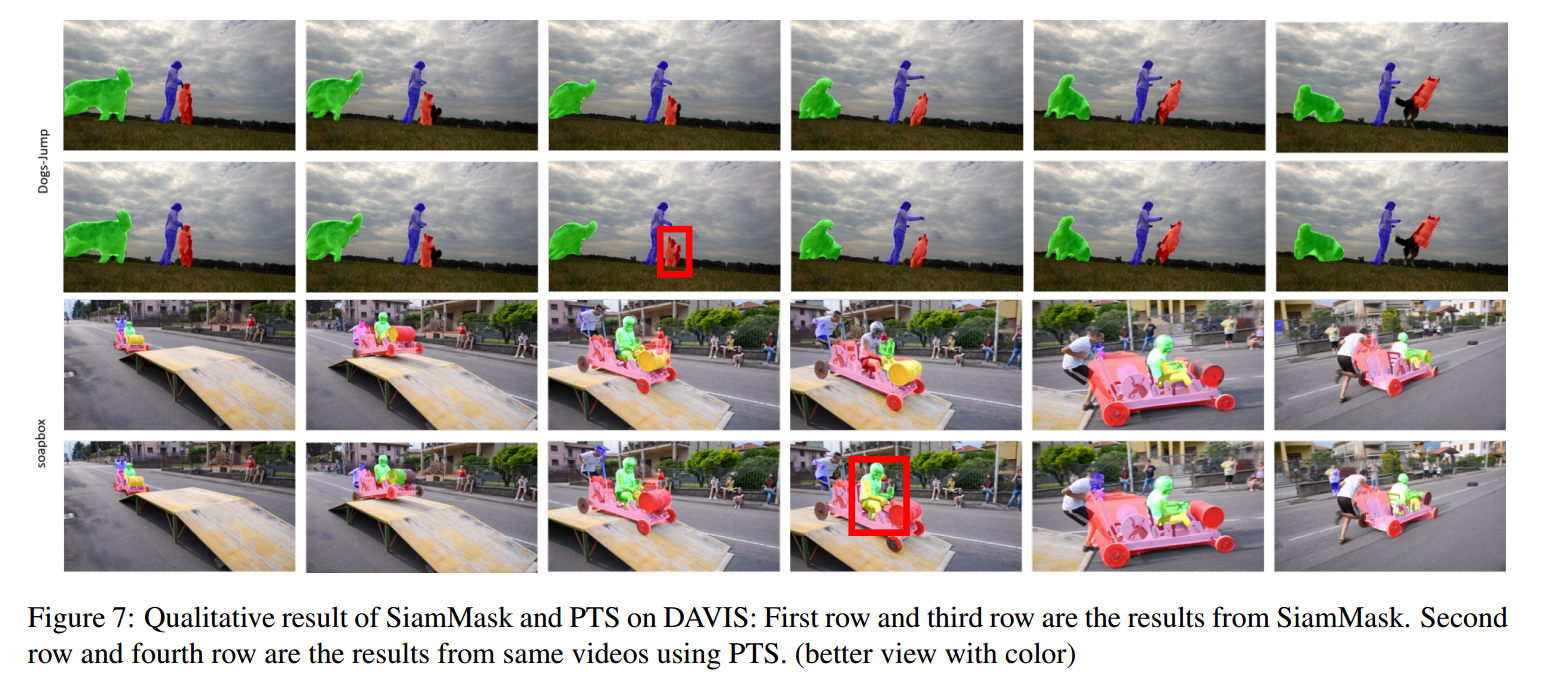
之所以要讲这篇文章,是因为,我很喜欢这个文章的思路,即:基于 prediction 的跟踪。废话不多说,来看文章的核心思想:Prediction-Tracking-Segmentation。文章的提到,现有的跟踪和分割的方法都是基于 appearance 的,而很少有考虑 motion information;特别是基于 tracking-by-detection 的 framework,严重依赖于 Local search region;从而导致对某些挑战性的因素,特别敏感。这些因素有:occlusion,fast motion and camera motion。
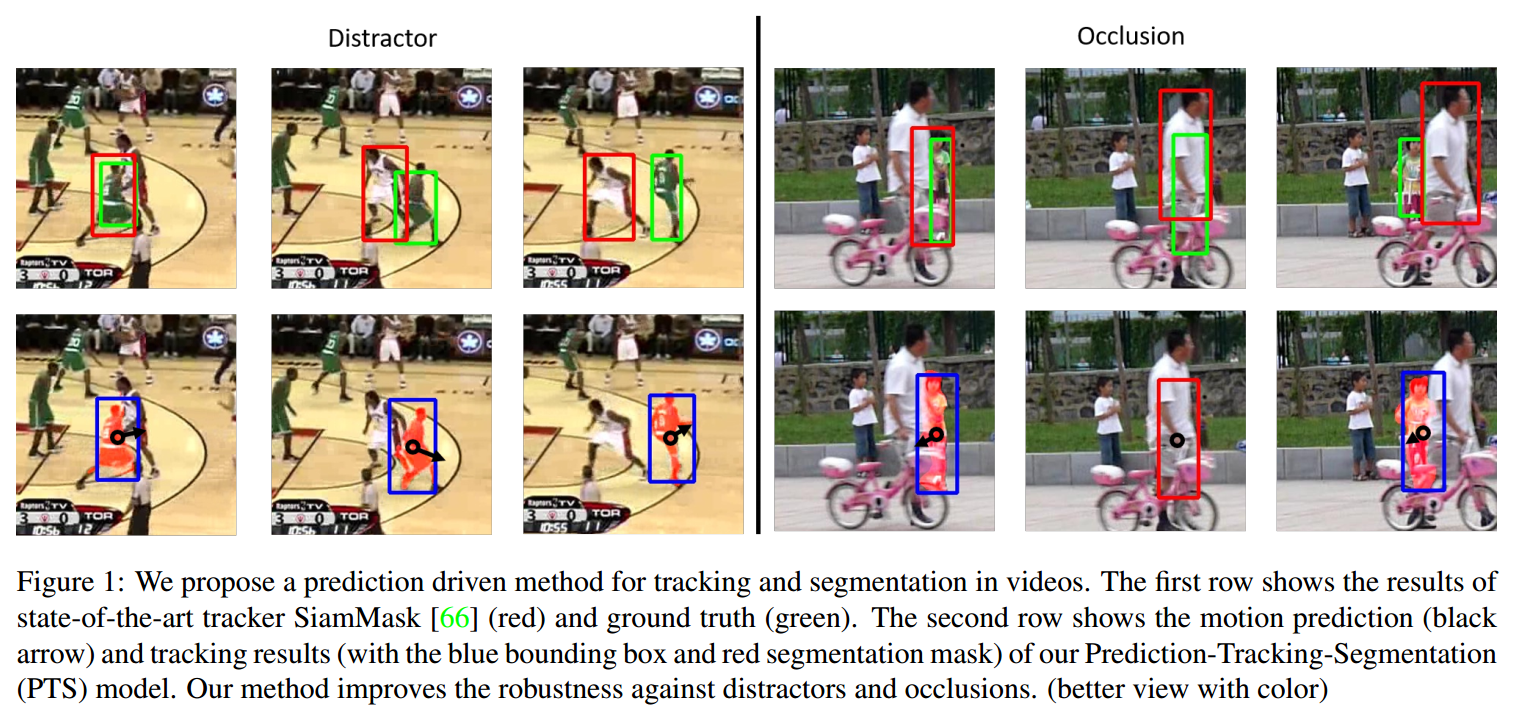
如上图所示,即便是目前 SOTA 的跟踪算法 SiamMask(CVPR-2019) 在处理遮挡问题上,也很是头疼。于是作者提出充分利用 motion information 来解决上述难度:
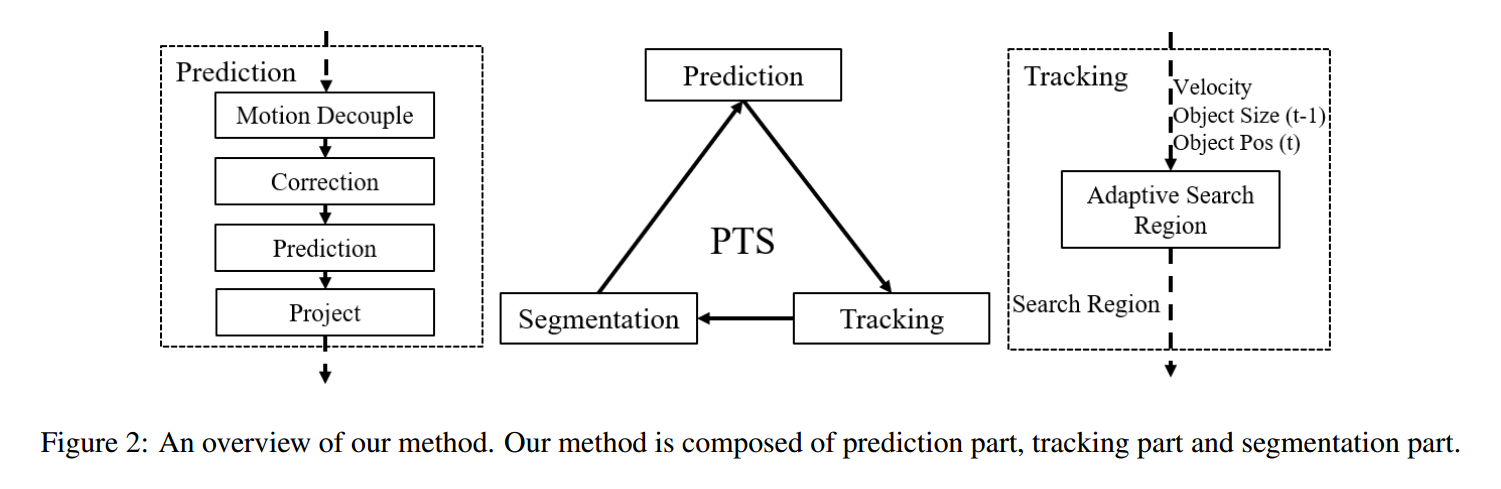
给定图像的目标运动是 camera motion 和 object motion 的叠加。前者是随机的,而后者是符合 Newton's First Law 。我们首先每间隔 n 帧,选择一个 reference frame,所以,将 long video 分解为多个 n-frame video 的短视频。第二,作者采用 ARIT("Action recognition with improved trajectories." ICCV 2013.)提出的方法来 camera motion 和 object motion 在每一个短视频内部进行分离。ARIT 假设 pending detection frame 及其 reference frame 是与 homography 相关的。这个假设在大部分的场景下都是成立的,因为一般两帧时间的运动是较小的。为了预测 homography,第一步是找到两帧之间的对应关系。在 ARIT 中,我们组合了 SURF features 和 从光流中得到的 motion vectors,来产生足够的和互补的候选匹配。此处,我们采用 PWCNet (Project,Code) 来进行 dense flow generation。
由于 homography matrix 包含 8 个 free variables,至少应该用 4 个 background points pairs。我们用 Eq 1 来计算 the least square solution,并且用 RANSAC 优化得到鲁棒的 solution。由于有如下的假设:the background occupies more than half of the images, 我们将视频帧之间的 matching points 分化为 4 个部分,然后每一个 point 在每一个选择的 piece 内部是随机选择的,用于改善 RANSAC algorithm 的效率:

简单起见,所有的后续操作都是在 reference coordinate,投影回当来的视频帧。图3 展示了分解步骤的工作原理:
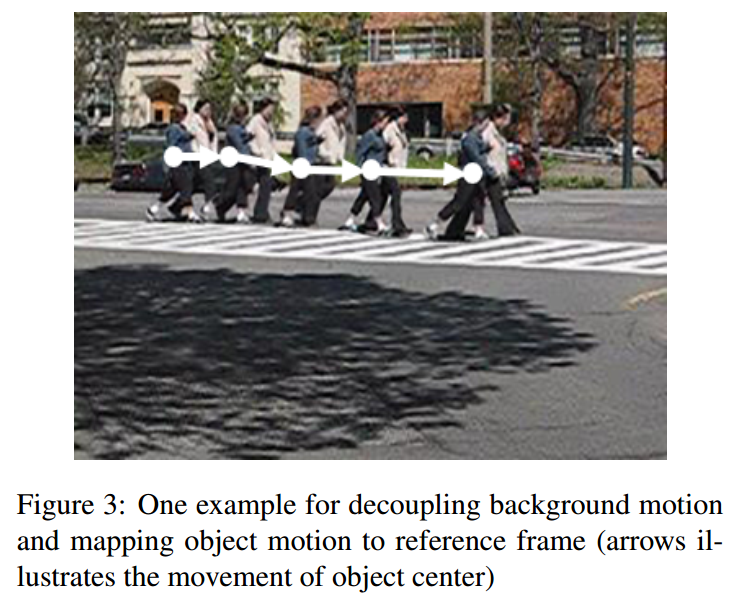
这个视频是由手持摄像机拍摄的,并且有抖动的背景。行人的运动是高度不可预测的。但是,通过将 target frame 投影到 reference frame 上,行人的运动变的更加可预测和连续。为了找到最具有代表性的目标位置,我们计算了物体分割的 “center of mass” :

背景运动预测 和 掩膜分割 的噪声可以被引入到物体位置预测中,从而影响预测的精度。为了更好的预测物体状态,我们利用 Kalman Filter 通过当前和前一帧的度量(measurement),来提供准确的位置信息。作为经典的跟踪算法,the Kalman Filter 通过如下两步来预测物体的状态:prediction 和 correction。在 Prediction 步骤,基于 the dynamic model (Eq. 3) 来预测目标状态,产生用于 Siamese Tracker 的搜索区域,以进行物体分割。所以,下一帧物体位置的预测度量可以用 Eq. 2 来计算。然后,在 Correction 步骤,给定来自 Siamese Network 的位置度量,在当前的步骤中,可以更加确定位置度量的置信度。
用于物体位置更新的 dynamic model 可以表达为:
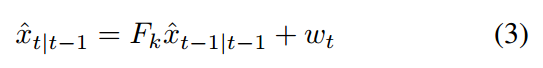
在上述公式中,等号左侧的 x 是 priori state estimation,是带有位置信息的 4 维的向量 [x, y, dx, dy]。需要注意的是,速度项 (dx, dy) 是从 time t-1 and t 之间的信息预测得到的。wt 是系统中的随机噪声。Ft 是从 time t-1 到 t 的转移矩阵。
在预测状态之后,the Kalman Filter 利用 measurements 来矫正其预测,用 Eq. 4。在公式中,$\hat{y}_t$ 是 prediction 和 measurement 之间的 residuals。$K_t$ 是给定的最优 Kalman gain,从预测的噪声协方差,measure matrix and measurement matrxi covariance 中得到的,如公式 5 所示。
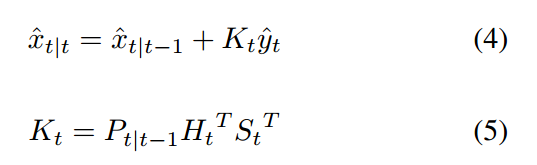
需要注意的是,由于 Kalman Filter 是一个 recursive algorithm,预测的 error covariance (P) 也应该根据预测结果,进行更新。
有了上述预测,我们就可以以上述预测的物体位置为中心点,确定一个搜索区域。我们将预测的物体中心位置投影回到 pending detection frame,用 Eq. 6:
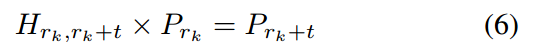
给定预测的位置,我们从而可以设置搜索区域 S:
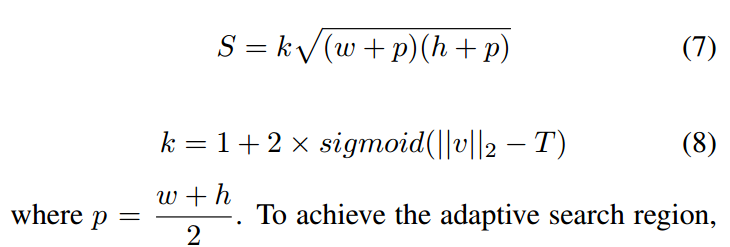
搜索区域大小 S 应该根据 Eq. 8 预测的速度,进行调整。v 是 Kalman Filter 预测的速度,T 是速度的阈值。搜索区域以中心点 $P_{r_k+t}$ 裁剪下来,然后 resize 到 255*255。
为了使得 one-shot segmentation framework 适合 tracking 任务,我们采用用于自动包围盒回归的优化策略,提供了较高的 IoU 和 mAP。
关于 Segmentation part,就和 SiamMask 很类似了,感兴趣的读者可以参考 SiamMask。

==
论文笔记:Prediction-Tracking-Segmentation的更多相关文章
- 论文笔记《Tracking Using Dynamic Programming for Appearance-Based Sign Language Recognition》
一.概述 这是我在做手势识别的时候,在解决手势画面提取的时候看的一篇paper,这里关键是使用了动态规划来作为跟踪算法,效果是可以比拟cameshift和kf的,但在occlusion,gaps或者离 ...
- 论文笔记:Tracking by Natural Language Specification
Tracking by Natural Language Specification 2018-04-27 15:16:13 Paper: http://openaccess.thecvf.com/ ...
- 论文笔记:Semantic Segmentation using Adversarial Networks
Semantic Segmentation using Adversarial Networks 2018-04-27 09:36:48 Abstract: 对于产生式图像建模来说,对抗训练已经取得了 ...
- 论文笔记之:Visual Tracking with Fully Convolutional Networks
论文笔记之:Visual Tracking with Fully Convolutional Networks ICCV 2015 CUHK 本文利用 FCN 来做跟踪问题,但开篇就提到并非将其看做 ...
- 论文笔记: Dual Deep Network for Visual Tracking
论文笔记: Dual Deep Network for Visual Tracking 2017-10-17 21:57:08 先来看文章的流程吧 ... 可以看到,作者所总结的三个点在于: 1. ...
- 论文笔记之:Action-Decision Networks for Visual Tracking with Deep Reinforcement Learning
论文笔记之:Action-Decision Networks for Visual Tracking with Deep Reinforcement Learning 2017-06-06 21: ...
- Deep Reinforcement Learning for Visual Object Tracking in Videos 论文笔记
Deep Reinforcement Learning for Visual Object Tracking in Videos 论文笔记 arXiv 摘要:本文提出了一种 DRL 算法进行单目标跟踪 ...
- 论文笔记系列-Auto-DeepLab:Hierarchical Neural Architecture Search for Semantic Image Segmentation
Pytorch实现代码:https://github.com/MenghaoGuo/AutoDeeplab 创新点 cell-level and network-level search 以往的NAS ...
- Video Frame Synthesis using Deep Voxel Flow 论文笔记
Video Frame Synthesis using Deep Voxel Flow 论文笔记 arXiv 摘要:本文解决了模拟新的视频帧的问题,要么是现有视频帧之间的插值,要么是紧跟着他们的探索. ...
- 论文笔记:语音情感识别(四)语音特征之声谱图,log梅尔谱,MFCC,deltas
一:原始信号 从音频文件中读取出来的原始语音信号通常称为raw waveform,是一个一维数组,长度是由音频长度和采样率决定,比如采样率Fs为16KHz,表示一秒钟内采样16000个点,这个时候如果 ...
随机推荐
- react高阶组件的使用
为了提高代码的复用在react中我们可以使用高阶组件 1.添加高阶组件 高阶组件主要代码模板HOC.js export default (WrappedComponent) => { retur ...
- JMeter压测基础(三)——Mysql数据库
JMeter压测基础(三)——Mysql数据库 环境准备 mysql驱动 JMeter jdbc配置 JMeter jdbc请求 1.下载mysql驱动:mysql-connector-java.ja ...
- .net core mysql ef
利用nuget添加以下引用 MySql.Data.EntityFrameworkCore Pomelo.EntityFrameworkCore.MySql Micros ...
- ROS学习备忘
1. remap的解释 For example, you are given a node that says it subscribes to the "chatter" top ...
- Vue + webpack 项目实践
Vue.js 是一款极简的 mvvm 框架,如果让我用一个词来形容它,就是 “轻·巧” .如果用一句话来描述它,它能够集众多优秀逐流的前端框架之大成,但同时保持简单易用.废话不多说,来看几个例子: & ...
- 2019-oo-第一次总结
一.度量分析程序结构 1.UML类图分析 1.1第一次作业 1.2第二次作业 1.3第三次作业 1.4总结 从UML类图三次作业的可以看出,我从一个类到逐渐利用多个类,代码结构在不 ...
- Xamarin Forms Api请求开源框架Refit
用于.NET Core,Xamarin和.NET的自动类型安全的REST库,Refit是一个受Square Square Retrofit库影响的库,但它比REST API更容易: public in ...
- JSON错误
今天遇到了json转换的错误. 原因:少导入了jar包 解决方法把所有的jar导入
- jenkins+Gitlab+maven+tomcat实现自动集成、打包、部署
一.前言 首先出于提高自己技术水平和琢磨能做点什么能提高工作效率,上线工作实在无聊.重复(手动编译.打包,传包,重启),于是就想到了jenkins,jenkins持续集成已经不是什么新鲜的话题,网上文 ...
- Android -- Glide框架详解(一)
1,使用这个框架快两年了,今天去github上去看了一下,貌似已经从3.X升级到4.X了,想着自己还没有对这个框架在博客上做过总结,所以这里打算出三篇博客来介绍,内容有基本使用.3.X与4.X的不通. ...