
最新豆瓣top250爬虫案例代码分析[注释齐全]
导入包
# json包

import json

#正则表达式包

import re

import requests

from requests import RequestException
定义爬取html函数
#函数:获取一页html

def get_one_page(url):

    try:

        headers = {

            'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/103.0.0.0 Safari/537.36'

        }

        '''

        Response对象返回包含了整个服务器的资源

        Response对象的属性,有以下几种

        r.status_code: HTTP请求的返回状态,200表示连接成功,404表示失败

        2.r.text: HTTP响应内容的字符串形式,即,url对应的页面内容

        3.r.encoding:从HTTP header中猜测的响应内容编码方式

        4.r.apparent_encoding:从内容中分析出的响应内容编码方式(备选编码方式)

        5.r.content: HTTP响应内容的二进制形式

        '''

        response = requests.get(url, headers=headers, timeout=1000)

        if response.status_code == 200:

            return response.text

    except requests.exceptions.RequestException as e:

        print(e)
定义解析html函数【正则】
#函数:解析一页html
def parse_one_page(html):
#re.compile 是预编译正则表达式函数,是用来优化正则的,它将正则表达式转化为对象
#re.compile 函数用于编译正则表达式,生成一个 Pattern 对象,pattern 是一个字符串形式的正则表达式
#pattern 是一个匹配对象Regular Expression,它单独使用就没有任何意义,需要和findall(), search(), match()搭配使用。
pattern = re.compile(
'<em class="">(\d+)</em>.*?<a href="(.*?)">.*?' +
'<img width="100" alt=".*?" src="(.*?)" class=""' +
'>.*?<span class="title">(.*?)</span>.*?<span ' +
'class="other"> / (.*?)</span>.*?<div ' +
'class="bd">.*?<p class="">.*?导演: (.*?) .*?<br>' +
'.*?(\d{4}) / (.*?) / (.*?)\n' +
'.*?</p>.*?<span class="rating_num" property="v:' +
'average">(.*?)</span>',
re.S)
items = re.findall(pattern, html)
for item in items:
yield {
'index': item[0],
'page_src': item[1],
'img_src': item[2],
'title': item[3],
'other_title': item[4],
'director': item[5],
'release_date': item[6],
'country': item[7],
'type': item[8],
'rate': item[9],
}
定义保存内容函数
#函数:将内容写入文件

def write_to_file(content):

    with open('douban_movie_rankings.txt', 'a', encoding='utf-8') as f:

        f.write(json.dumps(content, ensure_ascii=False) + '\n')
定义主函数
#主空函数

def main():

    #用于翻页

    for offset in range(10):

        #获取网址

        url = f'https://movie.douban.com/top250?start={offset * 25}&filter='

        #获取html文件

        html = get_one_page(url)

        for item in parse_one_page(html):

            print(item)

            write_to_file(item)
定义魔法函数
if __name__ == '__main__':

    main()
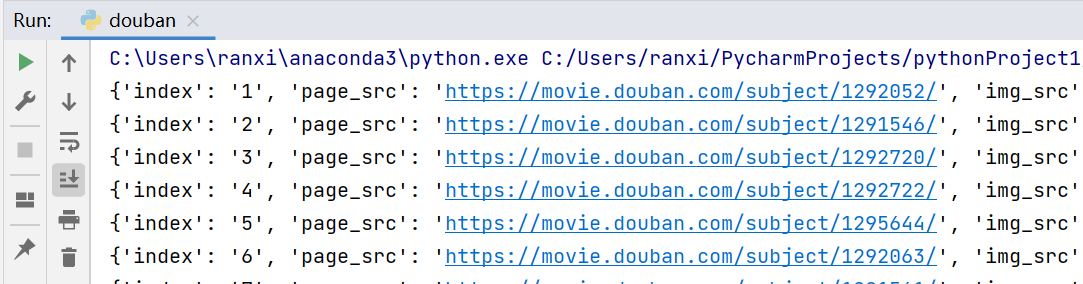
运行结果:
原创作者:孤飞-博客园
原文链接:https://www.cnblogs.com/ranxi169/p/16564490.html
最新豆瓣top250爬虫案例代码分析[注释齐全]的更多相关文章
- 正则表达式实战:最新豆瓣top250爬虫超详细教程
检查网页源代码 首先让我们来检查豆瓣top250的源代码,一切网页爬虫都需要从这里开始.F12打开开发者模式,在元素(element)页面通过Ctrl+F直接搜索你想要爬取的内容,然后就可以开始编写正 ...
- Java豆瓣电影爬虫——使用Word2Vec分析电影短评数据
在上篇实现了电影详情和短评数据的抓取.到目前为止,已经抓了2000多部电影电视以及20000多的短评数据. 数据本身没有规律和价值,需要通过分析提炼成知识才有意义.抱着试试玩的想法,准备做一个有关情感 ...
- unity3d 射弹基础案例代码分析
#pragma strict import UnityEngine.UI; function Start () { } var speed : int = 5; var newobject : Tra ...
- Java豆瓣电影爬虫——抓取电影详情和电影短评数据
一直想做个这样的爬虫:定制自己的种子,爬取想要的数据,做点力所能及的小分析.正好,这段时间宝宝出生,一边陪宝宝和宝妈,一边把自己做的这个豆瓣电影爬虫的数据采集部分跑起来.现在做一个概要的介绍和演示. ...
- Forward团队-爬虫豆瓣top250项目-项目总结
托管平台地址:https://github.com/xyhcq/top250 小组名称:Forward团队 组长:马壮 成员:李志宇.刘子轩.年光宇.邢云淇.张良 我们这次团队项目内容是爬取豆瓣电影T ...
- Python爬虫之多线程下载豆瓣Top250电影图片
爬虫项目介绍 本次爬虫项目将爬取豆瓣Top250电影的图片,其网址为:https://movie.douban.com/top250, 具体页面如下图所示: 本次爬虫项目将分别不使用多线程和使 ...
- Forward团队-爬虫豆瓣top250项目-项目进度
项目地址:https://github.com/xyhcq/top250 我们的项目是爬取豆瓣top250的电影的信息,在做这个项目前,我们都没有经验,完全是从零开始,过程中也遇到了很多困难,不过我们 ...
- 《Forward团队-爬虫豆瓣top250项目-开发文档》
码云地址:https://github.com/xyhcq/top250 模块功能:获取豆瓣top250网页的源代码,并分析. def getHTMLText(url,k): # 获取网页源代码 tr ...
- 基础爬虫,谁学谁会,用requests、正则表达式爬取豆瓣Top250电影数据!
爬取豆瓣Top250电影的评分.海报.影评等数据! 本项目是爬虫中最基础的,最简单的一例: 后面会有利用爬虫框架来完成更高级.自动化的爬虫程序. 此项目过程是运用requests请求库来获取h ...
随机推荐
- 好客租房19-react组件基础目标
1能够使用函数创建组件 2能够使用class创建组件 3能够给react元素绑定事件 4能够使用state和setstate 5能够处理事件中的this指向问题 6能够使用受控组件处理表单
- CF335E Counting Skyscrapers 题解
提供一种最劣解第一且巨大难写的做法( Bob 显然真正的楼量可以达到 \(314!\),是没办法直接做的,再加上唯一方案的样例,可以猜测有简单的结论. 考虑当楼高度为 \(k(k<h)\) 时, ...
- C#/VB.NET 在PDF表格中添加条形码
条码的应用已深入生活和工作的方方面面.在处理条码时,常需要和各种文档格式相结合.当需要在文档中插入.编辑或者删除条码时,可借助于一些专业的类库工具来实现.本文,以操作PDF文件为例,介绍如何在编辑表格 ...
- 数据库常用DDL语句
一.创建表 CREATE TABLE TABLE_NAME( #create table 表名 ID INT(4) PRIMARY KEY, #字段名 数据类型 完整性约束条件 NAME VARCHA ...
- Training loop Run Builder
以下内容来自deeplizard pyorch_P31
- AtCoder ABC 250 总结
AtCoder ABC 250 总结 总体 连续若干次一样的结果:30min 切前 4 题,剩下卡在 T5 这几次卡在 T5 都是一次比一次接近, 什么 dp 前缀和打挂,精度被卡,能水过的题连水法都 ...
- Linux文本搜索及截取操作
Linux文本搜索及截取操作 cat 查看 grep 搜索 awk 截取 查看dna-server.xml 文件的内容 [root@localhost servers]# cat cwag9002/w ...
- React + Typescript领域初学者的常见问题和技巧
React + Typescript领域初学者的常见问题和技巧 创建一个联合类型的常量 Key const NAME = { HOGE: "hoge", FUGA: "f ...
- 【Redis】集群故障转移
集群故障转移 节点下线 在集群定时任务clusterCron中,会遍历集群中的节点,对每个节点进行检查,判断节点是否下线.与节点下线相关的状态有两个,分别为CLUSTER_NODE_PFAIL和CLU ...
- 接口偶尔超时,竟又是JVM停顿的锅!
原创:扣钉日记(微信公众号ID:codelogs),欢迎分享,转载请保留出处. 简介 继上次我们JVM停顿十几秒的问题解决后,我们系统终于稳定了,再也不会无故重启了! 这是之前的文章:耗时几个月,终于 ...