
Python爬虫知乎文章,采集新闻60秒
前言
发现很多人需要新闻的接口,所以自己去搜索了下,发现知乎上正好有对应的用户每天发布新闻简讯,所以自己想写一个新闻的爬虫。如果想做成接口的话,可以加上flask模块即可,这里就暂时只进行爬虫部分的编写。
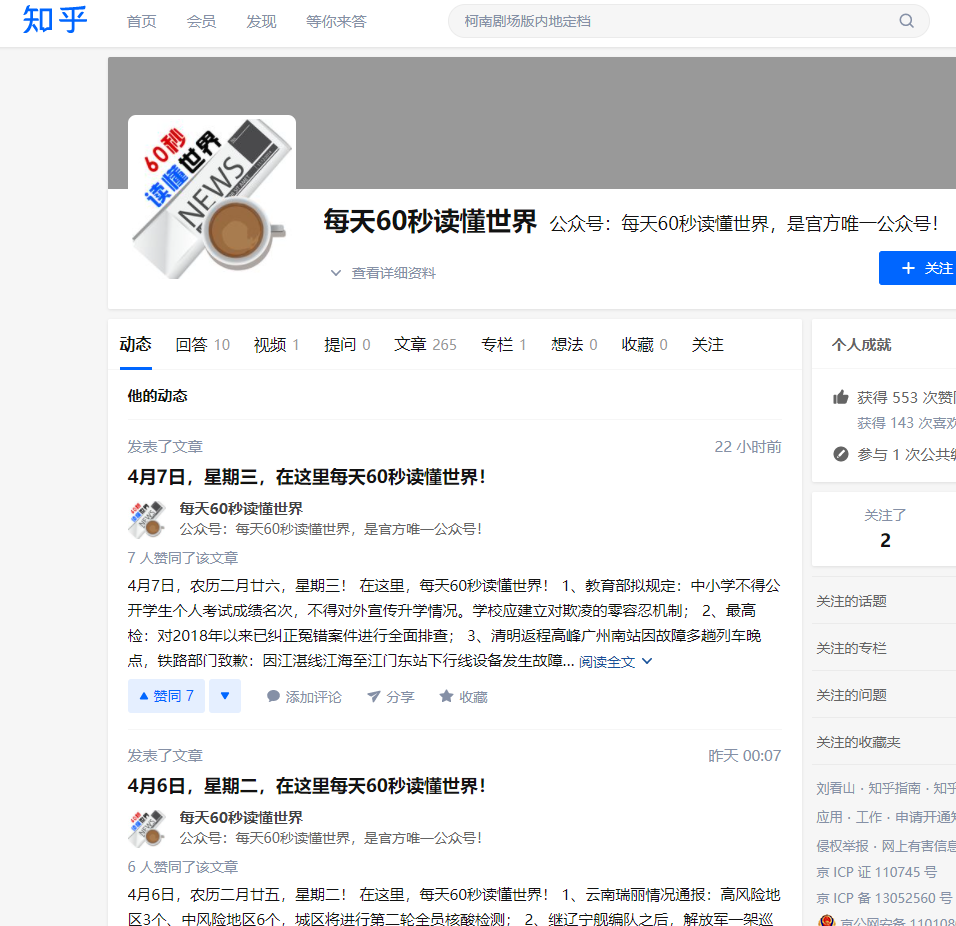
目标站点
网址:https://www.zhihu.com/people/mt36501
通过这个网址进去,我只想要今天的内容,所以还要进行过滤。
开始编写代码
# 导入要使用的库
import requests, re, time
# 目标网址
url = 'https://www.zhihu.com/people/mt36501'
# 模拟请求头
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) '
'Chrome/70.0.3538.102 Safari/537.36 Edge/18.18362',
'Accept': 'image/png, image/svg+xml, image/*; q=0.8, */*; q=0.5',
}
# 请求网址返回内容
resp = requests.get(url,headers=headers).text
# 过滤标题
h2 = re.findall(r'<h2 class="ContentItem-title">.*?</h2>', resp, re.S)
# 遍历每一个标题,因为发现有时候会发与新闻不想关的内容
for i in h2:
# 获取当前日期
now_time = time.strftime("%#m月%#d日", time.localtime())
# 过滤出链接
link = re.findall(r'href="(.*?)"', str(i), re.S)[0]
# 过滤出标题
title = re.findall(r'Title">(.*?)</a>', str(i), re.S)
# 如果为空跳过
if title == []:
continue
else:
# 获取文章的日期
title = str(title[0]).split(',')[0]
# 文章日期与当前日期比较
if title == now_time and link != '':
#print(title, link)
# 如果日期为今天,请求对应的网址,获取对应文章的内容
con_resp = requests.get('https:' + link, headers=headers).text
# 只要我们想要的内容,并过滤掉一些字符
p = re.findall(r'<p>(.*?)</p>', con_resp.replace('"', '"').replace('&', '&'), re.S)
sum = 0
text = ''
# 遍历每一条获取到的新闻赋值给text
for index, i in enumerate(p):
sum += 1
if sum == 1 | sum == 3:
continue
print(i)
elif i == '':
print(i)
continue
else:
if index == len(p) - 1:
text += i
else:
text += i + '\n\n'
print(text)
Python爬虫知乎文章,采集新闻60秒的更多相关文章
- python爬虫知乎问答
python爬虫知乎问答 import cookielibimport base64import reimport hashlibimport jsonimport rsaimport binasci ...
- python爬虫知乎
在之前写过一篇使用python爬虫爬取电影天堂资源的博客,重点是如何解析页面和提高爬虫的效率.由于电影天堂上的资源获取权限是所有人都一样的,所以不需要进行登录验证操作,写完那篇文章后又花了些时间研究了 ...
- 如何利用 Python 爬虫实现给微信群发新闻早报?(详细)
1. 场景 经常有小伙伴在交流群问我,每天的早报新闻是怎么获取的? 其实,早期使用的方案,是利用爬虫获取到一些新闻网站的标题,然后做了一些简单的数据清洗,最后利用 itchat 发送到指定的社群中. ...
- python爬虫-知乎登录
#!/usr/bin/env python3 # -*- coding: utf-8 -*- ''' Required - requests (必须) - pillow (可选) ''' import ...
- python爬虫,爬取一系列新闻
这个作业的要求来自于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/2941. 由于存在多次请求,所以稍微将请求封装如下 def tr ...
- Python爬虫 —— 知乎之selenium模拟登陆获取cookies+requests.Session()访问+session序列化
代码如下: # coding:utf-8 from selenium import webdriver import requests import sys import time from lxml ...
- python爬虫---表情包批量采集
代码: import requests from pyquery import PyQuery as pq # 比xpath还要灵活的html解析工具 # 定义请求 headers = { " ...
- python爬虫---豆瓣Top250电影采集
代码: import requests from bs4 import BeautifulSoup as bs import time def get_movie(url): headers = { ...
- python爬虫---虎牙直播封面采集
代码: import requests from lxml import etree # html解析库 source = requests.get("https://www.huya.co ...
随机推荐
- Java REPL & JShell
Java REPL & JShell Java 11 JShell Java Shell https://www.infoq.com/articles/jshell-java-repl/ Th ...
- NGK.IO会是一个投资优质项目吗?
互联网发展至今,技术已经高度成熟,人们发现了互联网的好处后,互联网逐渐渗入到家家户户.随着时代的变迁,人们对HTTP长期作为主流霸占互联网食物链的顶端感到不满足.当人类开始变得挑剔,HTTP的劣势就逐 ...
- NGK DeFi项目即将上线,打造去中心化闭环金融生态!
据最新官方消息称:NGK已于近日宣布将进军DeFi领域,NGK此次的DeFi的项目将会是一个去中心的交易平台,其最大的功能是进行数字货币的交换.在用户选择了需要支付的数字货币和想购买的数字货币后,系统 ...
- [转]ROS Q&A | How to read LaserScan data
http://www.theconstructsim.com/read-laserscan-data/ Step 1. Open a project on ROS Development Studio ...
- 推荐一款好用的免费远程控制软件——ToDesk
创作立场声明:我在本文中评测的软件为自用,感觉不错并且全免费,第一时间发出来和大家分享,欢迎理性观点交流碰撞. 疫情刚开始的时候,待在家里不能上班,但是还是有很多工作需要在线完成,常常需要跑回办公室拿 ...
- Ping 的工作原理你懂了,那 ICMP 你懂不懂?
计算机网络我也连载了很多篇了,大家可以在我的公众号「程序员cxuan」 或者我的 github 系统学习. 计算机网络第一篇,聊一聊网络基础 :计算机网络基础知识总结 计算机网络第二篇,聊一聊 TCP ...
- vue项目配置 `webpack-obfuscator` 进行代码加密混淆
背景 公司代码提供给第三方使用,为了不完全泄露源码,需要对给出的代码进行加密混淆,前端代码虽然无法做到完全加密混淆,但是通过使用 webpack-obfuscator 通过增加随机废代码段.字符编码转 ...
- 使用OWASP Dependency-Check对应用做个安检
俗话说"人怕出名猪怕壮",当系统小有名气以后就会被一些黑客盯上,三天两头的用各种漏洞扫描工具做渗透,如果不希望某天你负责的系统因为安全问题而出名,那就提前行动起来吧,这就是今天要讲 ...
- vivo 官网资源包适配多场景的应用
本文介绍了资源包的概念及使用场景,同时对资源包的几种使用方案进行对比.通过本文,大家可以快速掌握资源包的使用方法,解决单一配置满足多场景.多样式的问题. 一.业务背景 随着官网项目的业务深入发展,单纯 ...
- pyinstaller打包exe运行失败
使用Pyinstaller来打包自己开发的软件时遇到的几个问题及解决方法.工具主要功能是数据分析,使用机器学习算法完成数据训练和预测功能.主要用到了两个学习库keras和sklearn,所以说在打包时 ...