
python批量爬取猫咪图片
不多说直接上代码
首先需要安装需要的库,安装命令如下
pip install BeautifulSoup
pip install requests
pip install urllib
pip install lxmlfrom bs4 import BeautifulSoup # 贵族名宠网页爬虫
import requests

import urllib.request

# 网址

url = 'http://www.hengdadog.com/sale-1.html'

def allpage():  # 获得所有网页

    all_url = []

    for i in range(1, 8): #循环翻页次数

        each_url = url.replace(url[-6], str(i))  # 替换

        all_url.append(each_url)

    return (all_url)  # 返回地址列表

if __name__ == '__main__':

    img_url = allpage()  # 调用函数

    for url in img_url:

        # 获得网页源代码

        print(url)

        requ = requests.get(url)

        req = requ.text.encode(requ.encoding).decode()

        html = BeautifulSoup(req, 'lxml')

        t = 0

        # 选择目标url

        img_urls = html.find_all('img')

        for k in img_urls:

            img = k.get('src')  # 图片

            print(img)

            name = str(k.get('alt'))  # 名字,这里的强制类型转换很重要

            type(name)

            # 先本地新建一下文件夹,保存图片并且命名

            path = 'F:\\CAT\\'  # 路径

            file_name = path + name + '.jpg'

            imgs = requests.get(img)     # 存储入文件

            try:

                urllib.request.urlretrieve(img, file_name)  # 打开图片地址,下载图片保存在本


            except:

                print("error")
运行效果:
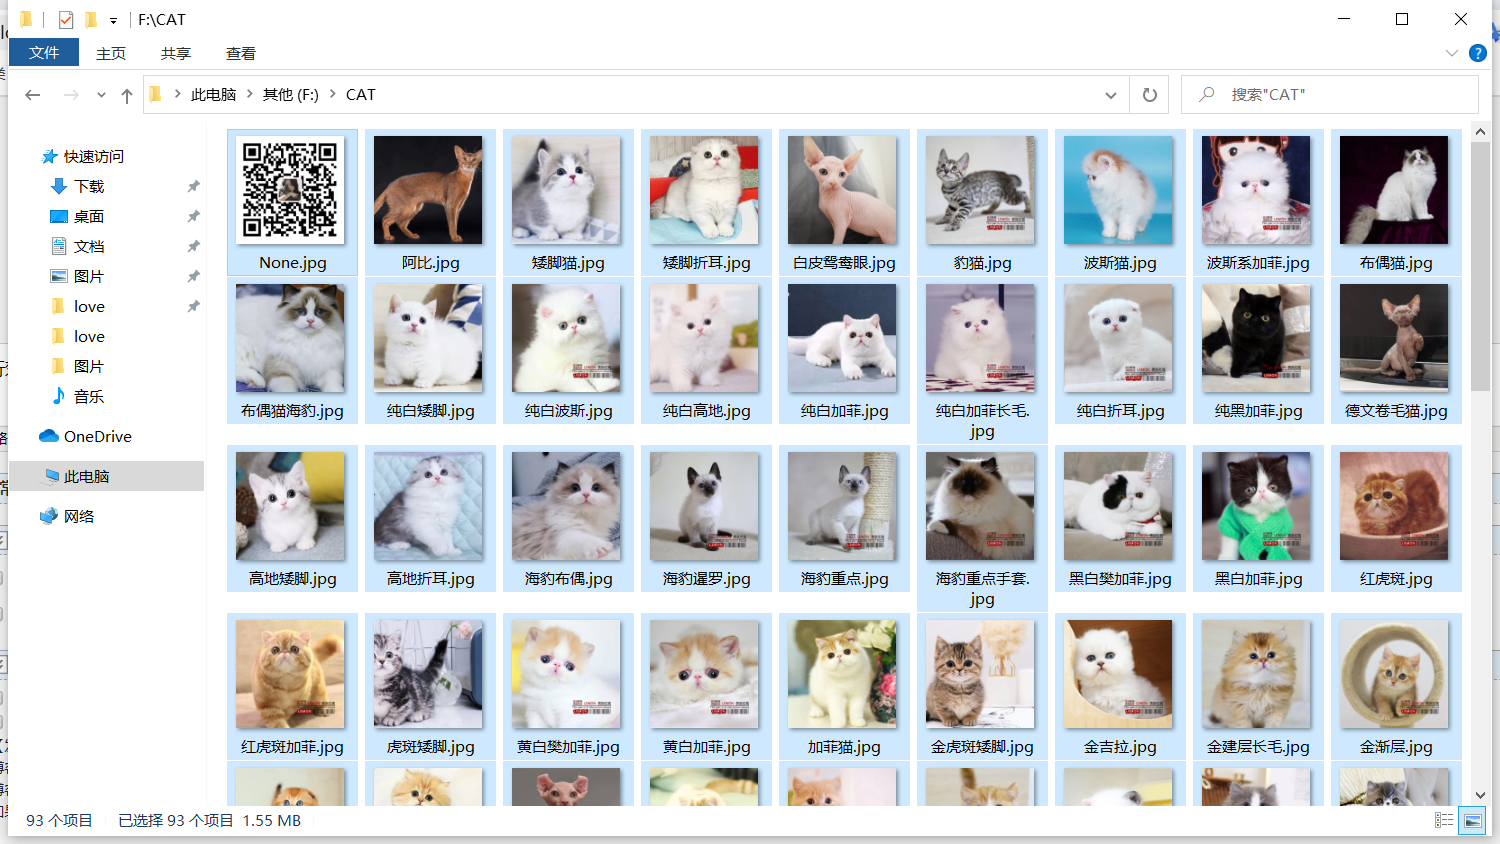
上面代码有不少缺陷,比如需要手动创建目录以及判断目录是否存在,下载没有提示,于是做了些优化:
from bs4 import BeautifulSoup  # 贵族名宠网页爬虫

import requests

import urllib.request

import os

# 网址

url = 'http://www.hengdadog.com/sale-1.html'

if os.path.exists('F:\\CAT'):#判断目录是否存在,存在则跳过,不存在则创建

    pass

else:

    os.mkdir('F:\\CAT')

def allpage():  # 获得所有网页

    all_url = []

    for i in range(1, 10): #循环翻页次数

        each_url = url.replace(url[-6], str(i))  # 替换

        all_url.append(each_url)

    return (all_url)  # 返回地址列表

if __name__ == '__main__':

    img_url = allpage()  # 调用函数

    for url in img_url:

        # 获得网页源代码

        print(url)

        requ = requests.get(url)

        req = requ.text.encode(requ.encoding).decode()

        html = BeautifulSoup(req, 'lxml')

        t = 0

        # 选择目标url

        img_urls = html.find_all('img')

        for k in img_urls:

            img = k.get('src')  # 图片

            print(img)

            name = str(k.get('alt'))  # 名字,这里的强制类型转换很重要

            type(name)

            # 保存图片并且命名

            path = 'F:\\CAT\\'  # 路径

            file_name = path + name + '.jpg'

            imgs = requests.get(img)     # 存储入文件

            try:

                urllib.request.urlretrieve(img, file_name)  # 打开图片地址,下载图片保存在本地,

                print('正在下载图片到F:\CAT目录······')

            except:

                print("error")
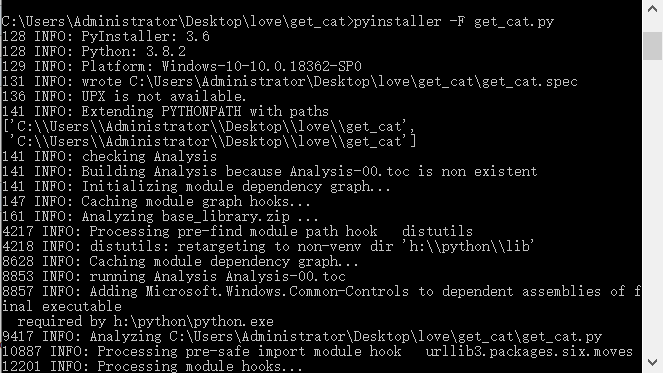
打包成EXE文件:
进入文件目录输入如下命令
pyinstaller -F get_cat.py
python批量爬取猫咪图片的更多相关文章
- 使用Python爬虫爬取网络美女图片
代码地址如下:http://www.demodashi.com/demo/13500.html 准备工作 安装python3.6 略 安装requests库(用于请求静态页面) pip install ...
- 从0实现python批量爬取p站插画
一.本文编写缘由 很久没有写过爬虫,已经忘得差不多了.以爬取p站图片为着手点,进行爬虫复习与实践. 欢迎学习Python的小伙伴可以加我扣群86七06七945,大家一起学习讨论 二.获取网页源码 爬取 ...
- python爬虫——爬取NUS-WIDE数据库图片
实验室需要NUS-WIDE数据库中的原图,数据集的地址为http://lms.comp.nus.edu.sg/research/NUS-WIDE.htm 由于这个数据只给了每个图片的URL,所以需 ...
- python 批量爬取四级成绩单
使用本文爬取成绩大致有几个步骤:1.提取表格(或其他格式文件——含有姓名,身份证等信息)中的数据,为进行准考证爬取做准备.2.下载准考证文件并提取出准考证和姓名信息.3.根据得到信息进行数据分析和存储 ...
- 用Python批量爬取优质ip代理
前言 有时候爬的次数太多时ip容易被禁,所以需要ip代理的帮助.今天爬的思路是:到云代理获取大量ip代理,逐个检测,将超时不可用的代理排除,留下优质的ip代理. 一.爬虫分析 首先看看今天要爬取的网址 ...
- python批量爬取动漫免费看!!
实现效果 运行环境 IDE VS2019 Python3.7 Chrome.ChromeDriver Chrome和ChromeDriver的版本需要相互对应 先上代码,代码非常简短,包含空行也才50 ...
- Python批量爬取谷歌原图,2021年最新可用版
文章目录 前言 一.环境配置 1.安装selenium 2.使用正确的谷歌浏览器驱动 二.使用步骤 1.加载chromedriver.exe 2.设置是否开启可视化界面 3.输入关键词.下载图片数.图 ...
- python 批量爬取代理ip
import urllib.request import re import time import random def getResponse(url): req = urllib.request ...
- java爬取猫咪上的图片
首先是对知识点归纳 1.用到获取网页源代码,分析图片地址,发现图片的地址都是按编号排列的,所以想到用循环获取 2.保存图片要用到流操作和文件操作,对两部分知识进行了复习巩固 3.保存后的图片有一部分是 ...
随机推荐
- vue-cli 工程目录结构介绍 详细介绍
vue-cli目录结构: vue-cli目录解析: build 文件夹:用于存放 webpack 相关配置和脚本.开发中仅 偶尔使用 到此文件夹下 webpack.base.conf.js 用于配置 ...
- B. Two Fairs 解析(思維、DFS、組合)
Codeforce 1276 B. Two Fairs 解析(思維.DFS.組合) 今天我們來看看CF1276B 題目連結 題目 給一個連通圖,並給兩個點(\(a,b\)),求有多少點對使得:任一路徑 ...
- BIO编程
在实际的工作开发中,传统的模型有client/service模型.client端和service端要进行通信的话,有一种套接字的方式.传统的socket编程,包含一个socket服务端和一到多个soc ...
- 03 . Go框架之Gin框架从入门到熟悉(Cookie和Session,数据库操作)
Cookie Cookie是什么 HTTP是无状态协议,服务器不能记录浏览器的访问状态,也就是说服务器不能区分两次请求是否由同一个客户端发出 Cookie就是解决HTTP协议无状态的方案之一,中文是小 ...
- Jmeter 函数助手对话框简单使用
第一步 打开Jmeter,Tools > 函数助手对话框 下拉框选择_CSVRead ,如下图所示: 第二步: 准备一份测试数据,保存在本地盘符里,数据如下图所示: 第三步,填数据, (1) ...
- 【Luogu】P6232 [eJOI2019]挂架 题解
这道题跟CSP/S 2019 D1T1有点像. 我们先来模拟一下 \(n=4\) 的情况, 不难得出,最后的衣架挂钩顺序: 下标: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 1 ...
- MYSQL字段
这里我的测试环境是wampserver 选择数据库 选择表 或者创建数据库和表 SHOW DATABASES; 查看数据库 CREATE DATABASE 数据库名; 创建数据库 在 MySQL 中, ...
- 你真的会用PostGIS中的buffer缓冲吗?
buffer - 图形缓冲区分析,GIS中最基本的空间分析之一. 实现buffer的工具有很多种,例如前端的truf.js.服务端的ArcGISserver.桌面端的ArcMap.数据库端的PosrG ...
- 12装饰器及*args,**kwargs
注:参数和返回值都是一个函数. 1,无参数 def decotare1(func): def wrapper(): print("First") func() return wra ...
- tp6.0.x 反序列化漏洞
tp6 反序列化漏洞复现 环境 tp6.0 apache php7.3 漏洞分析 反序列化漏洞需要存在 unserialize() 作为触发条件,修改入口文件 app/controller/Index ...