
大数据学习笔记——Spark完全分布式完整部署教程
Spark完全分布式完整部署教程
继Mapreduce之后,作为新一代并且是主流的计算引擎,学好Spark是非常重要的,这一篇博客会专门介绍如何部署一个分布式的Spark计算框架,在之后的博客中,更会讲到Spark的基本模块的介绍以及底层原理,好了,废话不多说,直接开始吧!
1. 安装准备
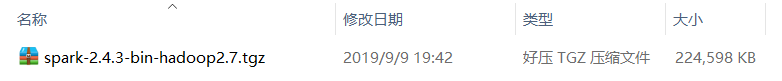
部署Spark时,我们使用的版本如下所示:
2. 正式安装
1. 将spark-2.4.3-bin-hadoop2.7.tgz文件使用远程传输软件发送至/home/centos/downloads目录下
2. 将spark-2.4.3-bin-hadoop2.7.tgz解压缩至/soft目录下
tar -xzvf spark-2.4.3-bin-hadoop2.7.tgz -C /soft
3. 进入到/soft目录下,配置spark的符号链接
cd /soft
ln -s spark-2.4.3-bin-hadoop2.7 spark
4. 修改并生效环境变量
nano /etc/profile
在文件末尾添加以下代码:
#spark环境变量
export SPARK_HOME=/soft/spark
export PATH=$PATH:$SPARK_HOME/bin
生效环境变量后保存退出
source /etc/profile
5. 规划集群部署方案
根据现有的虚拟机配置,集群部署方案为:s101节点作为master节点,s102 - s104作为worker节点
6. 使用脚本分发spark软件包以及/etc/profile文件到所有节点
cd /soft
xsync.sh spark-2.4.3-bin-hadoop2.7
xsync.sh /etc/profile
7. 使用ssh连接到除s101外的其他所有节点创建符号链接
ssh s102
cd /soft
ln -s spark-2.4.3-bin-hadoop2.7 spark
exit
其他节点同理
8. 配置spark的配置文件并分发到所有节点
cd /soft/spark/conf
cp spark-env.sh.template spark-env.sh
nano spark-env.sh
在文件末尾处添加后保存退出:
export JAVA_HOME=/soft/jdk
export HADOOP_CONF_DIR=/soft/hadoop/etc/hadoop
准备好如下文件,避免每次提交spark job上传spark类库:
先用WinScp将spark的类库放到/home/centos目录下
将spark的类库上传到HDFS文件系统上去:hdfs dfs -put /home/centos/spark_lib.zip /
修改spark-defaults配置文件:
cp spark-defaults.conf.template spark-defaults.conf
nano spark-defaults.conf
在文件末尾处添加后保存退出:
spark.yarn.archive hdfs://mycluster/spark_lib.zip
cp slaves.template slaves
nano slaves
在文件中末尾处删除localhost并添加以下命令后后保存退出:
s102
s103
s104
分发上述三个个配置文件
xsync.sh spark-env.sh
xsync.sh spark-defaults.conf
xsync.sh slaves
9. 启动spark集群
/soft/spark/sbin/start-all.sh
10. 查看进程
xcall.sh jps
出现以下画面:

11. 查看WebUI
http://s101:8080
配置大功告成!!!

12. 结合hadoop启动spark的各种模式检测是否都能正常启动
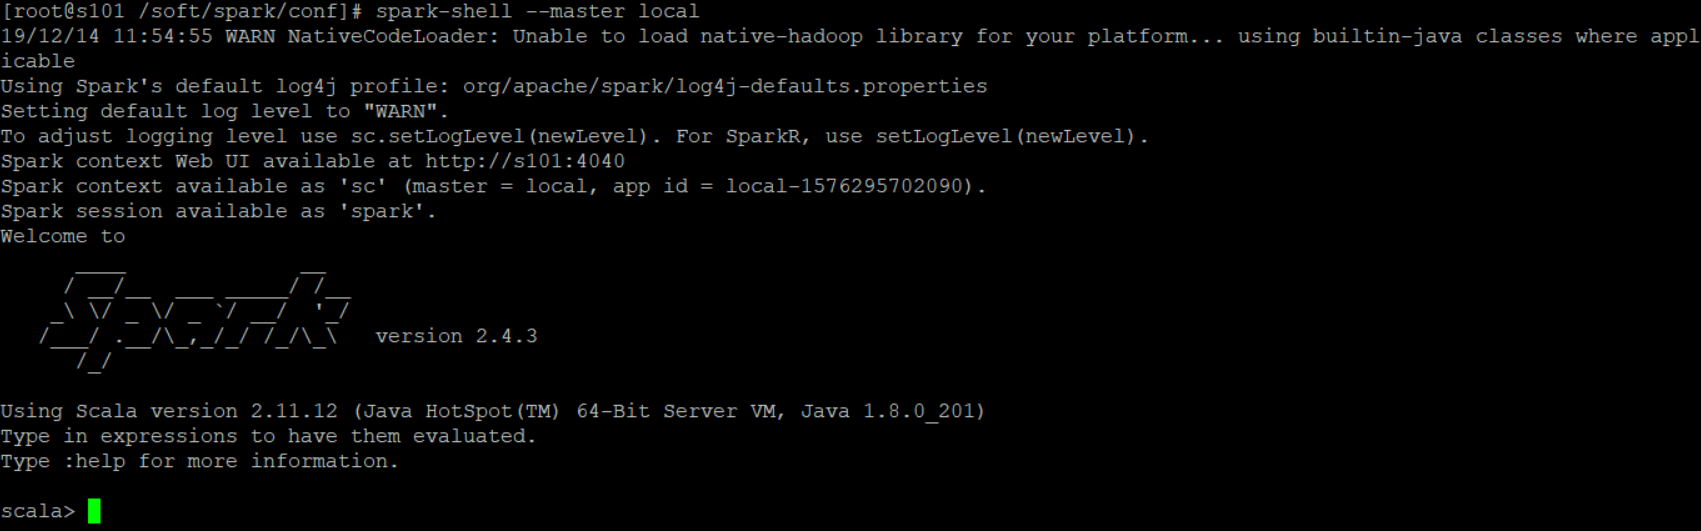
启动local模式:spark-shell --master local
启动hadoop集群:
xzk.sh start
start-all.sh
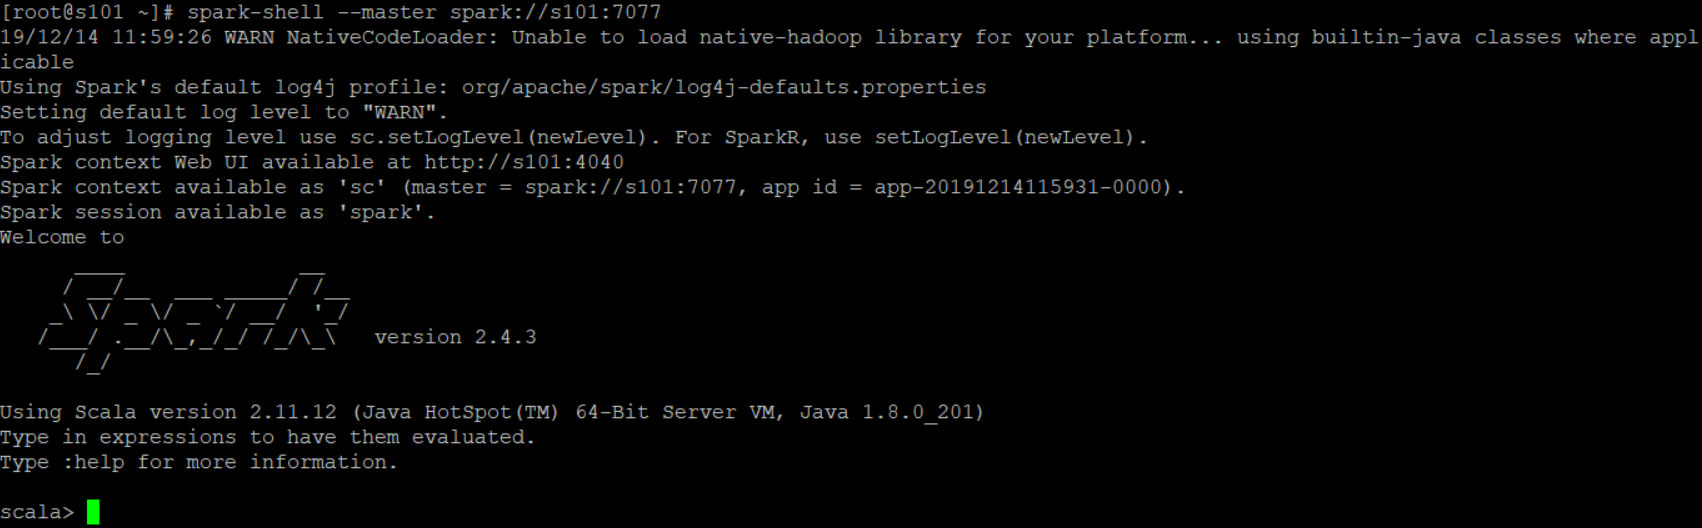
然后启动standalone模式:spark-shell --master spark://s101:7077
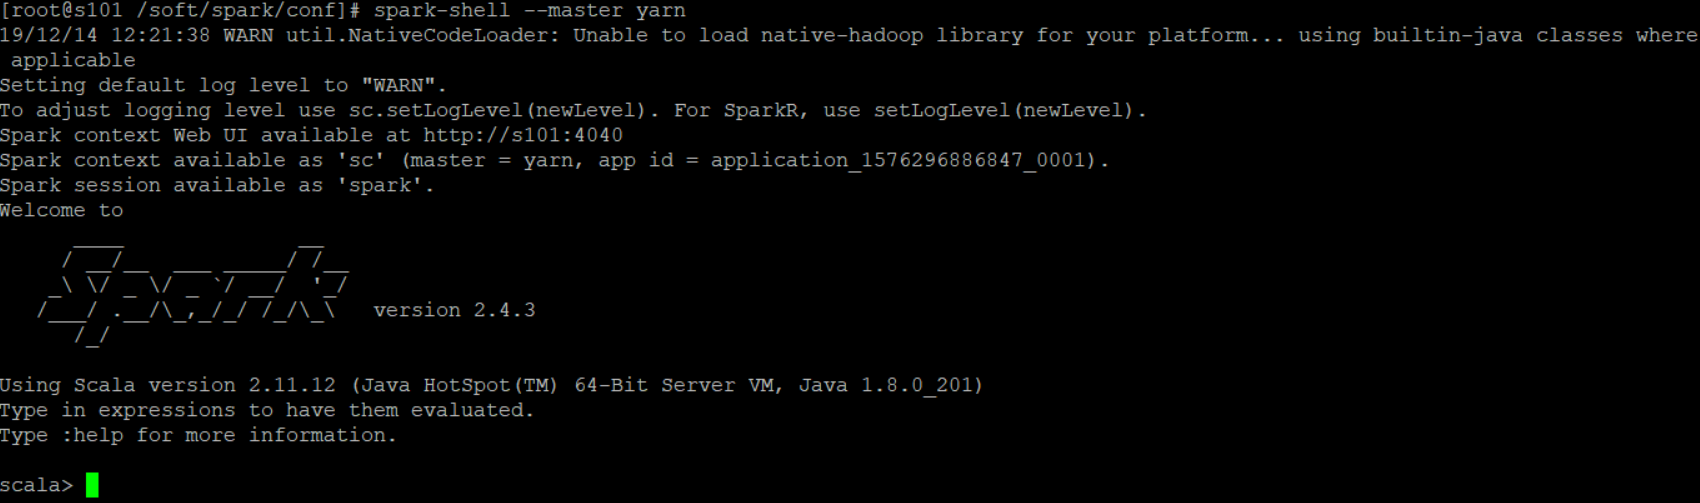
最后测试yarn模式是否能连接成功:spark-shell --master yarn
大数据学习笔记——Spark完全分布式完整部署教程的更多相关文章
- 大数据学习笔记——Spark工作机制以及API详解
Spark工作机制以及API详解 本篇文章将会承接上篇关于如何部署Spark分布式集群的博客,会先对RDD编程中常见的API进行一个整理,接着再结合源代码以及注释详细地解读spark的作业提交流程,调 ...
- 大数据学习笔记——Hbase高可用+完全分布式完整部署教程
Hbase高可用+完全分布式完整部署教程 本篇博客承接上一篇sqoop的部署教程,将会详细介绍完全分布式并且是高可用模式下的Hbase的部署流程,废话不多说,我们直接开始! 1. 安装准备 部署Hba ...
- 大数据学习笔记——Linux完整部署篇(实操部分)
Linux环境搭建完整操作流程(包含mysql的安装步骤) 从现在开始,就正式进入到大数据学习的前置工作了,即Linux的学习以及安装,作为运行大数据框架的基础环境,Linux操作系统的重要性自然不言 ...
- 大数据学习笔记——Hadoop编程实战之HDFS
HDFS基本API的应用(包含IDEA的基本设置) 在上一篇博客中,本人详细地整理了如何从0搭建一个HA模式下的分布式Hadoop平台,那么,在上一篇的基础上,我们终于可以进行编程实操了,同样,在编程 ...
- 大数据学习笔记——Java篇之集合框架(ArrayList)
Java集合框架学习笔记 1. Java集合框架中各接口或子类的继承以及实现关系图: 2. 数组和集合类的区别整理: 数组: 1. 长度是固定的 2. 既可以存放基本数据类型又可以存放引用数据类型 3 ...
- 大数据学习笔记——Hadoop高可用完全分布式模式完整部署教程(包含zookeeper)
高可用模式下的Hadoop集群搭建 本篇博客将会在之前写过的Linux的完整部署的基础上进行,暂时不会涉及到伪分布式或者完全分布式模式搭建,由于HA模式涉及到的配置文件较多,维护起来也较为复杂,相信学 ...
- 大数据学习笔记5 - Spark
Spark是一个基于内存计算的大数据并行计算框架.所以,Spark并不能完全替代Hadoop,主要用于替代Hadoop中的MapReduce计算模型. 在实际应用中,大数据处理无非是以下几个类型: 复 ...
- 大数据学习笔记——Sqoop完整部署流程
Sqoop详细部署教程 Sqoop是一个将hadoop与关系型数据库之间进行数据传输,批量数据导入导出的工具,注意,导入是指将数据从RDBMS导入到hadoop而导出则是指将数据从hadoop导出到R ...
- 大数据学习笔记之Hadoop(一):Hadoop入门
文章目录 大数据概论 一.大数据概念 二.大数据的特点 三.大数据能干啥? 四.大数据发展前景 五.企业数据部的业务流程分析 六.企业数据部的一般组织结构 Hadoop(入门) 一 从Hadoop框架 ...
随机推荐
- Redis单节点数据同步到Redis集群
一:Redis集群环境准备 1:需要先安装好Redis集群环境并配置好集群 192.168.0.113 7001-7003 192.168.0.162 7004-7006 2:检查redis集群 [r ...
- vim光标移动、跳转
这里记载我用到并需要下次会用的vim快捷键 vim的三个模式:命令行模式.插入模式.底行模式 从命令模式到插入模式: a 光标后输入 A 行尾输入 i 光标前输入 I 行首输入 o 上一行输入 O 下 ...
- 【algo&ds】7.最短路径问题
单源最短路径问题:从某固定源点出发,求其到所有其他顶点的最短路径 (有向)无权图:BFS (有向)有权图:Dijkstra算法 多源最短路径问题:求任意两顶点间的最短路径 直接将单源最短路算法调用|V ...
- 快速搭建 SpringCloud 微服务开发环境的脚手架
本文适合有 SpringBoot 和 SpringCloud 基础知识的人群,跟着本文可使用和快速搭建 SpringCloud 项目. 本文作者:HelloGitHub-秦人 HelloGitHub ...
- pdf 在线预览之 pdfjs插件
这个插件不需要阅读器 也不会屏蔽签章 但是也是兼容到ie11
- Oracle 分区表管理之组合分区(分区索引失效与性能比较)
整体结构如下: Oracle 分区表管理之组合分区(分区索引失效与性能比较) 虽然老早就使用了分区表,终于有时间写有关分区表的内容:不是所有的场景数据量变大需要用到分区表,一般单表数据超过2g可以考 ...
- 【python测试开发栈】—python内存管理机制(二)—垃圾回收
在上一篇文章中(python 内存管理机制-引用计数)中,我们介绍了python内存管理机制中的引用计数,python正是通过它来有效的管理内存.今天来介绍python的垃圾回收,其主要策略是引用计数 ...
- 用IDCNN和CRF做端到端的中文实体识别
实体识别和关系抽取是例如构建知识图谱等上层自然语言处理应用的基础.实体识别可以简单理解为一个序列标注问题:给定一个句子,为句子序列中的每一个字做标注.因为同是序列标注问题,除去实体识别之外,相同的技术 ...
- PostgreSQL的使用向导
目录 数据库 创建数据库 进入数据库 查看版本 查看当前时间日期 简单的select 获得帮助命令 退出psql客户端 创建表 weather和cities表的创建 删除表 插入数据 数据库导出成cs ...
- Wordpress未授权查看私密内容漏洞 分析(CVE-2019-17671)
目录 0x00 前言 0x01 分析 0x02 思考 0x03 总结 0x04 参考 0x00 前言 没有 0x01 分析 这个漏洞被描述为"匿名用户可访问私密page",由此推断 ...