
(4)一起来看下mybatis框架的缓存原理吧
本文是作者原创,版权归作者所有.若要转载,请注明出处.本文只贴我觉得比较重要的源码,其他不重要非关键的就不贴了
我们知道.使用缓存可以更快的获取数据,避免频繁直接查询数据库,节省资源.
MyBatis缓存有一级缓存和二级缓存.
1.一级缓存也叫本地缓存,默认开启,在一个sqlsession内有效.当在同一个sqlSession里面发出同样的sql查询请求,Mybatis会直接从缓存中查找。如果没有则从数据库查找
下面我们贴一下一级缓存的测试结果
String resource = "mybatis.xml";

    //读取配置文件,生成读取流

    InputStream inputStream = Resources.getResourceAsStream(resource);

    //返回的DefaultSqlSessionFactory是SqlSessionFactory接口的实现类,

    //这个类只有一个属性,就是Configuration对象,Configuration对象用来存放读取xml配置的信息

    SqlSessionFactory sqlSessionFactory = new SqlSessionFactoryBuilder().build(inputStream);

    //SqlSession是与数据库打交道的对象 SqlSession对象中有上面传来的Configuration对象,

    //SqlSession对象还有executor处理器对象,executor处理器有一个dirty属性,默认为false

    //返回的DefaultSqlSession是SqlSession接口的实现类

    SqlSession sqlSession = sqlSessionFactory.openSession();

    //SqlSession sqlSession2 = sqlSessionFactory.openSession();

    //通过动态代理实现接口 ,用动态代理对象去帮我们执行SQL

    //这里生成mapper实际类型是org.apache.ibatis.binding.MapperProxy

    DemoMapper mapper = sqlSession.getMapper(DemoMapper.class);

    DemoMapper mapper2 = sqlSession.getMapper(DemoMapper.class);

    //这里用生成的动态代理对象执行

    String projId="0124569b738e405fb20b68bfef37f487";

    String sectionName="标段";

    List<ProjInfo> projInfos = mapper.selectAll(projId, sectionName);

    List<ProjInfo> projInfos2 = mapper2.selectAll(projId, sectionName);

    System.out.println(projInfos.hashCode());//这里和下面那条的查询结果的hashcode是一样的

    System.out.println(projInfos2.hashCode());//

    sqlSession.close();

    sqlSession = sqlSessionFactory.openSession();

    DemoMapper mapper5 = sqlSession.getMapper(DemoMapper.class);

    List<ProjInfo> projInfos5 = mapper5.selectAll(projId, sectionName);

    System.out.println(projInfos5.hashCode());//这里和上面两条的查询结果的hashcode是不一样的

好,我们可以看到,上面两条的查询结果的hashcode一样,第三条不一样,一级缓存生效了
2.二级缓存是mapper级别的,就是说二级缓存是以Mapper配置文件的namespace为单位创建的。
二级缓存默认是不开启的,需要手动开启二级缓存,如下需要在mybatis配置文件中的settting标签里面加入开启
<settings>

        <!-- 开启二级缓存。value值填true -->

        <setting name="cacheEnabled" value="true"/>

        <!--  配置默认的执行器。SIMPLE 就是普通的执行器;

        REUSE 执行器会重用预处理语句(prepared statements); BATCH 执行器将重用语句并执行批量更新。默认SIMPLE  -->

        <setting name="defaultExecutorType" value="SIMPLE"/>

    </settings>
实现二级缓存的时候,MyBatis要求返回的对象必须是可序列化的,如图
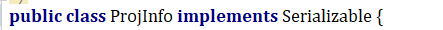
还要在mapper,xml文件中添加cache标签,标签里的readOnly属性需填true 如下:
<cache readOnly="true" ></cache>

    <select id="selectAll" resultType="com.lusaisai.po.ProjInfo">

        SELECT id AS sectionId,section_name AS sectionName,proj_id AS projId

        FROM b_proj_section_info

        WHERE proj_id=#{projId} AND section_name LIKE CONCAT('%',#{sectionName},'%')

    </select>
我们再来看下二级缓存的运行结果
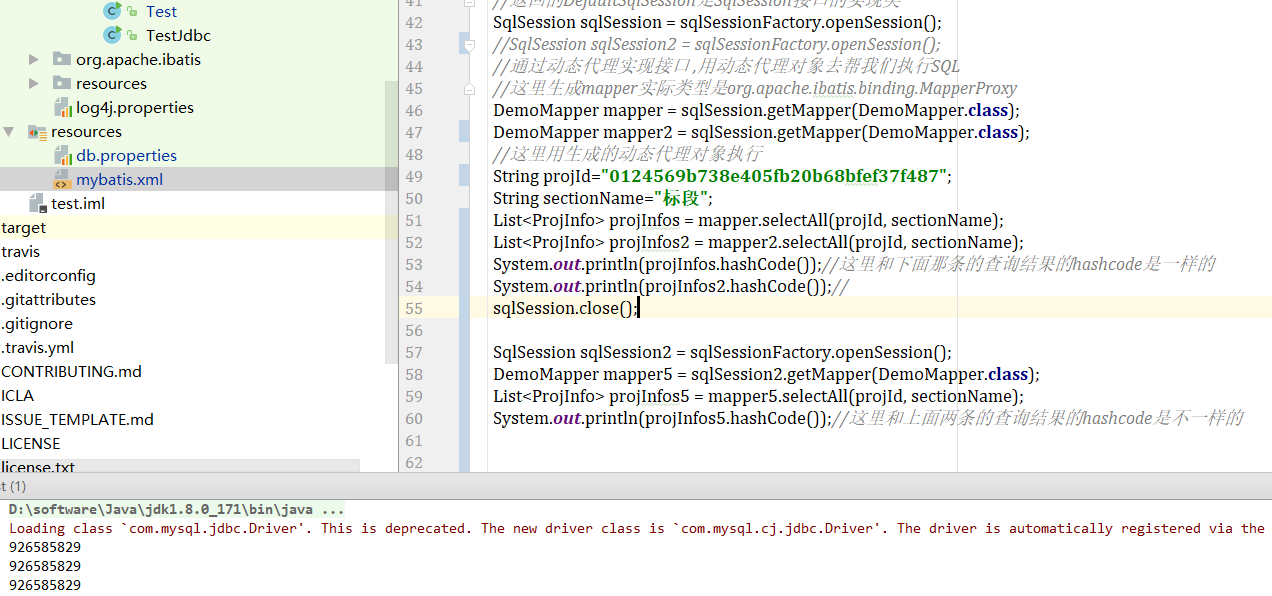
我们可以看到二级缓存也生效了.
下面来看看缓存的源码,大家猜底层是使用什么实现的,前面的流程就不一一看了,主要贴一下缓存的代码,
public <E> List<E> query(MappedStatement ms, Object parameterObject, RowBounds rowBounds, ResultHandler resultHandler) throws SQLException {

    //

    BoundSql boundSql = ms.getBoundSql(parameterObject);

    CacheKey key = createCacheKey(ms, parameterObject, rowBounds, boundSql);

    //这个跟进去看戏,应该是真正的jdbc操作了

    return query(ms, parameterObject, rowBounds, resultHandler, key, boundSql);

  }
我们可以看到,上面的生成了一个缓存的key,具体怎么实现的就先不看了,看下key这个对象有什么属性吧
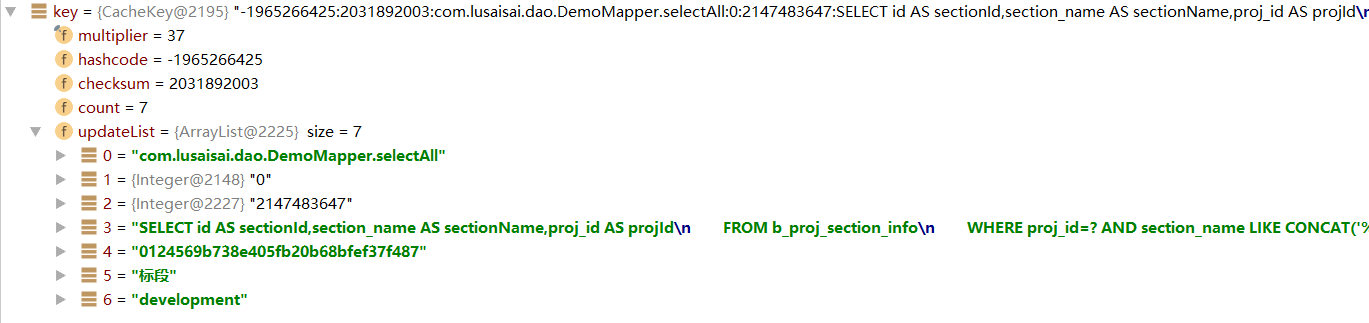
我们可以看到,key对象有这条sql语句除了结果之外的所有信息,还有hashcode等等,我们继续跟进去
public <E> List<E> query(MappedStatement ms, Object parameterObject, RowBounds rowBounds, ResultHandler resultHandler, CacheKey key, BoundSql boundSql)

      throws SQLException {

    //MappedStatement的作用域是全局共享的,这里的cache是接口,有多个实现类

    Cache cache = ms.getCache();

    if (cache != null) {

      flushCacheIfRequired(ms);

      if (ms.isUseCache() && resultHandler == null) {

        ensureNoOutParams(ms, boundSql);

        @SuppressWarnings("unchecked")

        List<E> list = (List<E>) tcm.getObject(cache, key);

        if (list == null) {

          list = delegate.query(ms, parameterObject, rowBounds, resultHandler, key, boundSql);

          tcm.putObject(cache, key, list); // issue #578 and #116

        }

        return list;

      }

    }

    //前面是缓存处理跟进去

    return delegate.query(ms, parameterObject, rowBounds, resultHandler, key, boundSql);

  }
我们看下Cache 的实现类

有很多,这里就不深究了,继续往下看,我们看下list = delegate.query(ms, parameterObject, rowBounds, resultHandler, key, boundSql)这行代码,这是处理一级缓存的方法,点进去看下
这里用到我们前面生成的key了
public <E> List<E> query(MappedStatement ms, Object parameter, RowBounds rowBounds, ResultHandler resultHandler, CacheKey key, BoundSql boundSql) throws SQLException {

    ErrorContext.instance().resource(ms.getResource()).activity("executing a query").object(ms.getId());

    if (closed) {

      throw new ExecutorException("Executor was closed.");

    }

    if (queryStack == 0 && ms.isFlushCacheRequired()) {

      clearLocalCache();

    }

    List<E> list;

    try {

      queryStack++;

      list = resultHandler == null ? (List<E>) localCache.getObject(key) : null;

      if (list != null) {

        handleLocallyCachedOutputParameters(ms, key, parameter, boundSql);

      } else {

        //进这里,继续跟

        list = queryFromDatabase(ms, parameter, rowBounds, resultHandler, key, boundSql);

      }

    } finally {

      queryStack--;

    }

    if (queryStack == 0) {

      for (DeferredLoad deferredLoad : deferredLoads) {

        deferredLoad.load();

      }

      // issue #601

      deferredLoads.clear();

      if (configuration.getLocalCacheScope() == LocalCacheScope.STATEMENT) {

        // issue #482

        clearLocalCache();

      }

    }

    return list;

  }
我们关注下list = resultHandler == null ? (List<E>) localCache.getObject(key) : null;这行代码,点进去看下
@Override

  public Object getObject(Object key) {

    return cache.get(key);

  }
我截个图,看下上图的PerpetualCache对象底层是怎么实现的
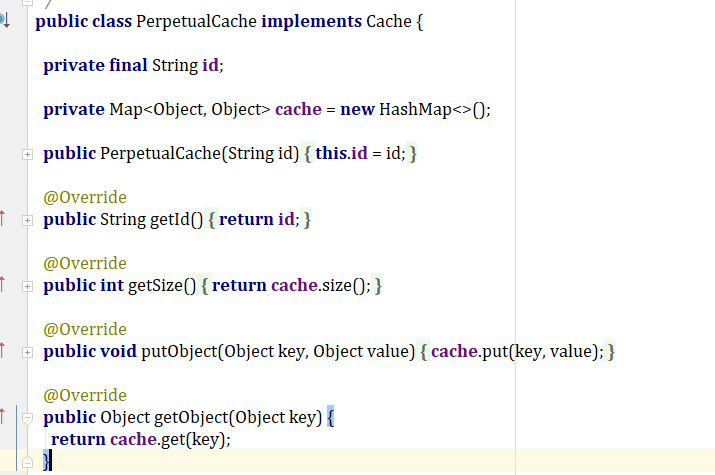
好,很明显了,这里一级缓存是用的hashmap实现的.
下面我们看下二级缓存的代码,上面的List<E> list = (List<E>) tcm.getObject(cache, key);这行代码跟进去
public Object getObject(Cache cache, CacheKey key) {

    return getTransactionalCache(cache).getObject(key);

  }
继续跟
@Override

  public Object getObject(Object key) {

    // issue #116

    Object object = delegate.getObject(key);

    if (object == null) {

      entriesMissedInCache.add(key);

    }

    // issue #146

    if (clearOnCommit) {

      return null;

    } else {

      return object;

    }

  }
截个图看下delegate对象的属性,很多层
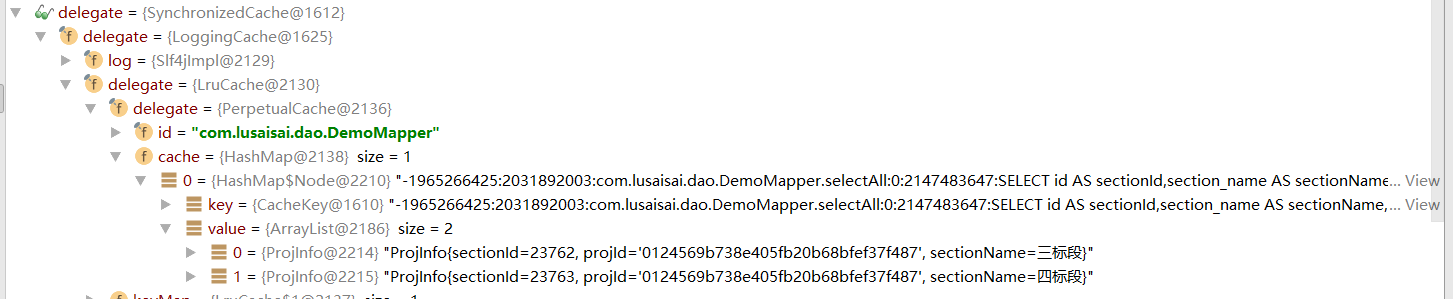
我们可以看到所有数据都在这里了.网上找的图
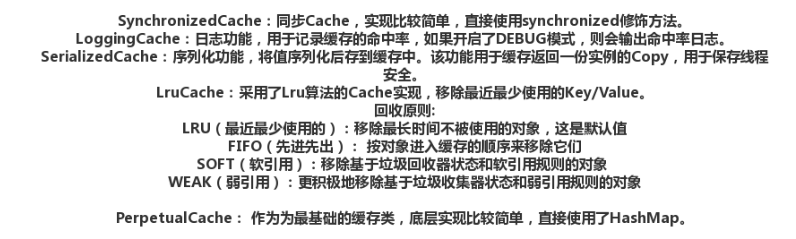
再来一段缓存的关键代码,这里就是包装了一层层对象的代码
private Cache setStandardDecorators(Cache cache) {

    try {

      MetaObject metaCache = SystemMetaObject.forObject(cache);

      if (size != null && metaCache.hasSetter("size")) {

        metaCache.setValue("size", size);

      }

      if (clearInterval != null) {

        cache = new ScheduledCache(cache);

        ((ScheduledCache) cache).setClearInterval(clearInterval);

      }

      if (readWrite) {

        cache = new SerializedCache(cache);

      }

      cache = new LoggingCache(cache);

      cache = new SynchronizedCache(cache);

      if (blocking) {

        cache = new BlockingCache(cache);

      }

      return cache;

    } catch (Exception e) {

      throw new CacheException("Error building standard cache decorators.  Cause: " + e, e);

    }

  }
好,再来张图总结一下
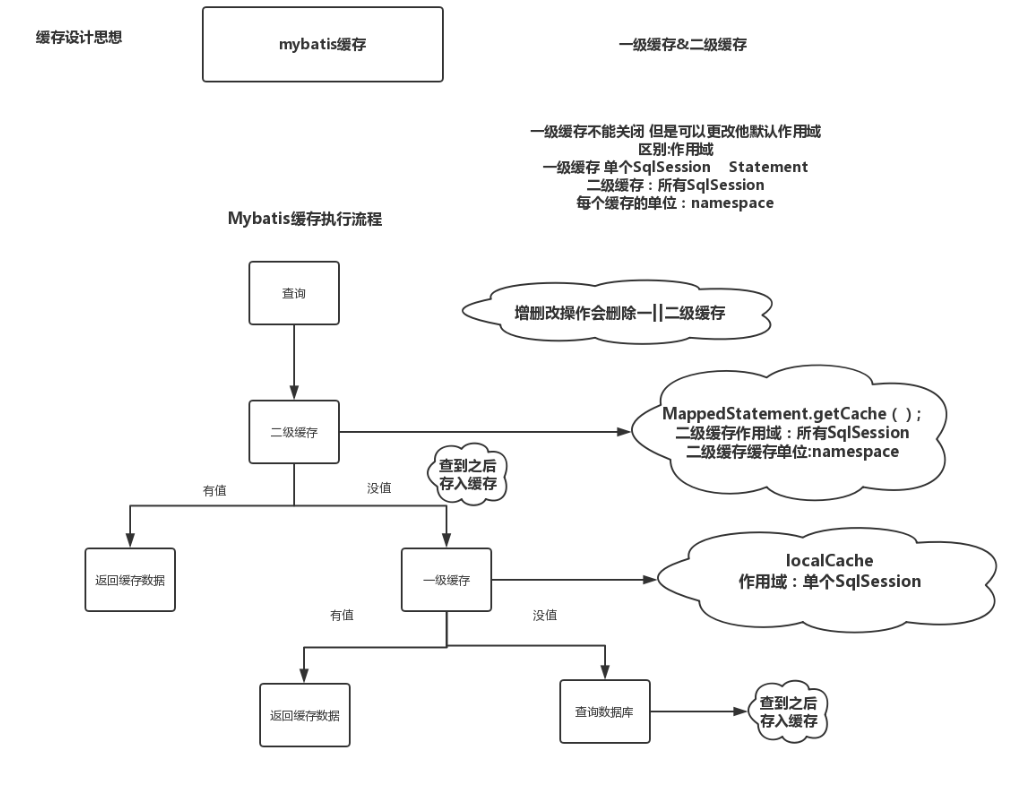
最后,如果我们和spring整合,那么此时mybatis一级缓存就会失效,因为sqlsession交给spring管理,会自动关闭session.
关于如何和spring整合就后面再来讲吧,下面一段时间,我会先研究一下spring源码,spring专题见啦
(4)一起来看下mybatis框架的缓存原理吧的更多相关文章
- MyBatis:二级缓存原理分析
MyBatis从入门到放弃七:二级缓存原理分析 前言 说起mybatis的一级缓存和二级缓存我特意问了几个身边的朋友他们平时会不会用,结果没有一个人平时业务场景中用. 好吧,那我暂且用来学习源码吧.一 ...
- mybatis两级缓存原理剖析
https://blog.csdn.net/zhurhyme/article/details/81064108 对于mybatis的缓存认识一直有一个误区,所以今天写一篇文章帮自己订正一下.mybat ...
- 手写mybatis框架-增加缓存&事务功能
前言 在学习mybatis源码之余,自己完成了一个简单的ORM框架.已完成基本SQL的执行和对象关系映射.本周在此基础上,又加入了缓存和事务功能.所有代码都没有copy,如果也对此感兴趣,请赏个Sta ...
- CodeIgniter框架的缓存原理分解
用缓存的目的:(手册上叙述如下,已经写得很清楚了) Codeigniter 支持缓存技术,以达到最快的速度. 尽管CI已经相当高效了,但是网页中的动态内容.主机的内存CPU 和数据库读取速度等因素直接 ...
- Spring Boot + Mybatis + Redis二级缓存开发指南
Spring Boot + Mybatis + Redis二级缓存开发指南 背景 Spring-Boot因其提供了各种开箱即用的插件,使得它成为了当今最为主流的Java Web开发框架之一.Mybat ...
- Mybatis拦截器实现原理深度分析
1.拦截器简介 拦截器可以说使我们平时开发经常用到的技术了,Spring AOP.Mybatis自定义插件原理都是基于拦截器实现的,而拦截器又是以动态代理为基础实现的,每个框架对拦截器的实现不完全相同 ...
- mybatis源码专题(2)--------一起来看下使用mybatis框架的insert语句的源码执行流程吧
本文是作者原创,版权归作者所有.若要转载,请注明出处.本文以简单的insert语句为例 1.mybatis的底层是jdbc操作,我们先来回顾一下insert语句的执行流程,如下 执行完后,我们看下数据 ...
- SpringBoot 下 mybatis 的缓存
背景: 说起 mybatis,作为 Java 程序员应该是无人不知,它是常用的数据库访问框架.与 Spring 和 Struts 组成了 Java Web 开发的三剑客--- SSM.当然随着 Spr ...
- 【Mybatis框架】查询缓存(一级缓存)
做Java的各位程序员们,估计SSH和SSM是我们的基础必备框架.也就是说我们都已经至少接触过了这两套常见的集成框架.当我们用SSH的时候,相信很多人都接触过hibernate的两级缓存,同样,相对应 ...
随机推荐
- lightoj 1074 - Extended Traffic(spfa+负环判断)
题目链接:http://www.lightoj.com/volume_showproblem.php?problem=1074 题意:有n个城市,每一个城市有一个拥挤度ai,从一个城市I到另一个城市J ...
- Linux音频编程(二)声卡介绍
一.声卡 1.声卡是audio interface,它含有hardware buffer,而这个hardware buffer是在声卡里面,不是内存.声卡的缓存是环状的,则ALSA中是将数据分成连续的 ...
- grep : app :Is a directory
今天在查日志的时候用grep命令,遇到这样的一个问题,grep : app :Is a directory 用的grep命令是这样的:grep -10 '2019-08-14 21:22:39.252 ...
- 02 python 必知
一.变量 1.变量的定义 将程序运算的中间结果临时存在内存里,以便后续代码调用. 2.变量的使用规范 1)变量必须要有数字,字母,下划线,任意组合. 2)变量不能数字开头. 3)不能是python中的 ...
- 使用IDEA创建maven web项目
1.打开idea-->configer-->setting-->build-->runner-->设置VM Options内添加-DarchetypeCatalog=in ...
- mysql之innodb-锁
本篇主要根据innodb存储引擎的锁进行阐述,包括分类,算法,以及锁的一些问题 一.锁的概述 为了保证最大程度的利用数据库的并发访问,又要确保每个用户能以一致的方式读取和修改数据,为此锁就派上了用场, ...
- Fortify安全漏洞一般处理方法
前段时间公司又一轮安全审查,要求对各项目进行安全扫描,排查漏洞并修复,手上有几个历史项目,要求在限定的时间内全部修复并提交安全报告,也不清楚之前是如何做的漏洞修复,这次使用工具扫描出来平均每个项目都还 ...
- PB级数据实现秒级查询ES的安装
什么是ES?ElasticSearch是一个基于Lucene的搜索服务器.它提供了一个分布式多用户能力的全文搜索引擎,基于RESTful web接口.Elasticsearch是用Java语言开发的, ...
- Kubernetes监控实践
一.Kubernetes介绍 Kubernetes(K8s)是一个开源平台,能够有效简化应用管理.应用部署和应用扩展环节的手动操作流程,让用户更加灵活地部署管理云端应用. 作为可扩展的容错平台,K8s ...
- 疑难杂症----Windows10
现在大多数个人电脑所用的操作系统都是win10,而我们使用win10时总是会碰上各种各样的问题,所以专门写一篇博客来记录我碰上的各种问题,便于以后更快的解决问题. 一.小娜搜索不到应用问题解决方案 小 ...