
ElasticSearch如何一次查询出全部数据—基于Scroll
Elasticsearch 查询结果默认只显示10条,可以通过设置from及size来达到分页的效果(详见附3),但是 from + size <= 10,000,因为index.max_result_window 默认值是10,000,而 from+ size 必须小于index.max_result_window 。因此只能用Scroll(一次取一点,分多次取)取出所有的结果
转载请注明出处:https://www.cnblogs.com/NaughtyCat/p/how-to-search-all-results-once-in-es.html
- Scroll相当于传统数据库的游标,具体代码片段如下:
		SearchResponse scrollResp = client.prepareSearch(availableIndices)

				.setTypes(type)

				.setScroll(new TimeValue(60000))

				.setQuery(boolQueryBuilder)

				.setSize(SEARCH_HITS_SIZE).get(); //max of SEARCH_HITS_SIZE hits will be returned for each scroll

		//Scroll until no hits are returned

		do {

			for (SearchHit hit : scrollResp.getHits().getHits()) {

					tmpJsonList.add( (JSONObject) JSONValue.parse(hit.getSourceAsString()));

				}

			}

			jsonList.addAll(tmpJsonList);

			tmpJsonList.clear();

			scrollResp = client.prepareSearchScroll(scrollResp.getScrollId()).setScroll(new TimeValue(60000)).execute().actionGet();

		} while (scrollResp.getHits().getHits().length != 0);
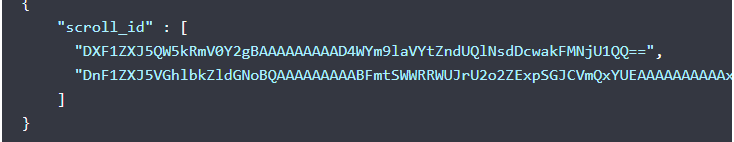
setScroll()里传入的时间,表示一次处理setSize()中size大小的数据的超时时间,即处理一个分页最长不超过的时间,上面的代码表示TimeOut = 1分钟(详情可搜索Scroll context。另外,数据量比较大,TimeOut得设长一点,笔者20亿左右的数据,至少TimeOut得设置为3min;否则会抛出异常: ElasticSearch: SearchContextMissingException[No search context found for id)
)。scrollResp.getScrollId()每次会生成一个ScrollID,如下图:
- 用from + size循环读取的代码片段如下(作者【CoderBaby】):
       int index = 0;

            {

                tmpJsonList.clear();

                srb.setFrom(Math.multiplyExact(index, SEARCH_HITS_SIZE));

                index++;

                MultiSearchResponse.Item[] items = sr.get().getResponses();

                for (MultiSearchResponse.Item item : items) {

                    SearchResponse response = item.getResponse();

                    SearchHit[] hits = response.getHits().getHits();

                    if (hits.length != 0) {

                        for (SearchHit hit : hits) {

                                tmpJsonList.add((JSONObject) JSONValue.parse(hit.getSourceAsString());

                            }

                        }

                    }

                jsonList.addAll(tmpJsonList);

                }

            } while (tmpJsonList.size() > 0);
其中:SEARCH_HITS_SIZE = 1000, srb是多条件组合查询,前置代码如下:
 queryBuilders.forEach(query -> {

        boolQueryBuilder.must(query);

            });

MultiSearchRequestBuilder sr = client.prepareMultiSearch();

            SearchRequestBuilder srb = client.prepareSearch().setTypes(type).setIndices(availableIndices).setQuery(boolQueryBuilder).setSize(SEARCH_HITS_SIZE);

            sr.add(srb);
查询条件的构造代码片段如下(用QueryBuilders根据需要选择term, range, match等):
	StringUtil.isEmpty(l7p)) {

            queryBuilders.add(QueryBuilders.termQuery(Event.FIELD_L7P, l7p));

        }

        if (!StringUtil.isEmpty(startTime) && StringUtil.isEmpty(endTime)) {

            queryBuilders.add(QueryBuilders.rangeQuery(Event.FIELD_START_TIME).from(startTime));

        }
附:
1)using scroll in java https://www.elastic.co/guide/en/elasticsearch/client/java-api/current/java-search-scrolling.html
2)scroll https://www.elastic.co/guide/en/elasticsearch/reference/5.1/search-request-scroll.html
3) from and size https://www.elastic.co/guide/en/elasticsearch/reference/current/search-request-body.html#request-body-search-from-size
*****************************************************************************************************
精力有限,想法太多,专注做好一件事就行
- 我只是一个程序猿。5年内把代码写好,技术博客字字推敲,坚持零拷贝和原创
- 写博客的意义在于打磨文笔,训练逻辑条理性,加深对知识的系统性理解;如果恰好又对别人有点帮助,那真是一件令人开心的事
*****************************************************************************************************
ElasticSearch如何一次查询出全部数据—基于Scroll的更多相关文章
- sql语句中查询出的数据添加一列,并且添加默认值
查询出数据,并且要添加一列表中都不存在的数据,且这一列的值都是相等的 select app_id,app_secret from wx_ticket group by app_id; 查询出的数据是 ...
- 匿名类型 使用泛型T linq返回dynamic类型的匿名实体 如何把匿名类型.GetType()返回的对象传进泛型里面 EF实体查询出的数据List<T>转DataTable出现【DataSet 不支持 System.Nullable<>】的问题
[100分]紧急求助:LinQ下使用IQueryable<T>如何将返回类型<T>使用匿名类型 问题描述如下:我有一个方法如下:public IQueryable Dissen ...
- jmeter将JDBC Request查询出的数据作为下一个接口的参数
现在有一个需求,从数据库tieba_info表查出rank小于某个值的username和count(*),然后把所有查出来的username和count(*)作为参数值,用于下一个接口. tieba_ ...
- Java基于POI实现excel任意多级联动下拉列表——支持从数据库查询出多级数据后直接生成【附源码】
Excel相关知识点 (1)名称管理器--Name Manager [CoderBaby]首先需要创建多个名称(包含key及value),作为下拉列表的数据源,后续通过名称引用.可通过菜单:&quo ...
- hibernate查询出的数据和数据库不一致
之前直接使用hibernate的时候就出现过已经进行物理存储后的数据,查询不出来的情况,既然是已经存储后的数据,说明事务已经提交,想必问题出在查询时,查询的缓存,没有查询数据库.时有时无就很奇怪. 现 ...
- Navicat查询出的数据有时候不能更改?
Navicate查出数据只读,一种情况是查询没带出主键(唯一索引),无法更新数据
- 在ASP.NET MVC中利用Aspose.cells 将查询出的数据导出为excel,并在浏览器中下载。
正题前的唠叨 本人是才出来工作不久的小白菜一颗,技术很一般,总是会有遇到一些很简单的问题却不知道怎么做,这些问题可能是之前解决过的.发现这个问题,想着提升一下自己的技术水平,将一些学的新的'好'东西记 ...
- mysql查询出相同数据出现的次数,统计相同值的数量
1.可以使用count SELECT count(name='A' OR NULL) FROM table 2.用sum SELECT sum(if( = 'A', 1, 0)) FROM table ...
- JMeter连接数据库(查询出的数据作为参数)
针对Mysql jdbc:mysql://ip:3306/数据库名?useUnicode=true&characterEncoding=utf8&allowMultiQueries=t ...
随机推荐
- windows 10 环境下 使用Anaconda搭建 TensorFlow 环境
##大致步骤 1 安装Anaconda 2 在Anaconda中建立虚拟TensorFlow的虚拟环境 建立虚拟环境的命令是 conda create -n tensorflow python=3. ...
- Visual Studio Online,带来四种开发模式,未来已来。
北京时间 2019 年 11 月 4 日,在 Microsoft Ignite 2019 大会上,微软正式发布了 Visual Studio Online 公开预览版! 简单来说,Visual Stu ...
- 微信小程序的canvas和遮盖布颜色设置问题
canvas绘画出并显示小程序的逻辑首先是将网络图片转化为本地图片,其次再将进行绘画.将本地图片和二维码显示在画布上,最后将整个画布截图用api显示在屏幕上.真正的画图让他飞去屏幕外. 有时候会需要用 ...
- NOIP模拟 29
T1第一眼觉得是网络流 看见4e6条边200次增广我犹豫了 O(n)都过不去的赶脚.. 可是除了网络流板子我还会什么呢 于是交了个智障的EK 还是用dijkstra跑的 居然有50分!$(RP--)$ ...
- python学习之【第九篇】:Python中的变量作用域
1.前言 Python 中,程序的变量并不是在哪个位置都可以访问的,访问权限决定于这个变量是在哪里赋值的. 2.变量作用域 变量的作用域决定了在哪一部分程序可以访问哪个特定的变量名称.Python的作 ...
- 获取Ubuntu的Docker CE
Docker文档 Docker提供了一种在容器中运行安全隔离的应用程序的方法,它与所有依赖项和库打包在一起. 获取Ubuntu的Docker CE 一.OS要求 需要以下Ubuntu版本的x86_64 ...
- Java 博客系统 Tale
Tale Tale的英文含义为故事,我相信每个坚持写Blog的人都是有故事的:中文你叫它 塌了 也无所谓 . Tale 使用了轻量级mvc框架 Blade 开发,默认主题使用了漂亮的 pinghsu, ...
- SQL Server 中 `JSON_MODIFY` 的使用
SQL Server 中 JSON_MODIFY 的使用 Intro SQL Server 从 2016 开始支持了一些 JSON操作,最近的项目里也是好多地方直接用字段直接存成了 JSON,需要了解 ...
- 数据可视化:绘图库-Matplotlib
为什么要绘图? 一个图表数据的直观分析,下面先看一组北京和上海上午十一点到十二点的气温变化数据: 数据: 这里我用一段代码生成北京和上海的一个小时内每分钟的温度如下: import random co ...
- Maven系列第6篇:生命周期和插件详解,此篇看过之后在maven的理解上可以超越同级别90%的人!
maven系列目标:从入门开始开始掌握一个高级开发所需要的maven技能. 这是maven系列第6篇. 整个maven系列的内容前后是有依赖的,如果之前没有接触过maven,建议从第一篇看起,本文尾部 ...