
spark 应用场景2-身高统计
原文引自:http://blog.csdn.net/fengzhimohan/article/details/78564610
a. 案例描述
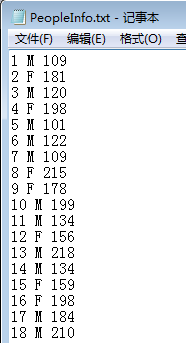
本案例假设我们需要对某个省的人口 (10万) 性别还有身高进行统计,需要计算出男女人数,男性中的最高和最低身高,以及女性中的最高和最低身高。本案例中用到的源文件有以下格式, 三列分别是 ID,性别,身高 (cm),格式如下:
b.人口数据的生成
利用Java语言随机生成一组人口数据,包括序列ID,性别M/F,身高cm,代码如下:
 import java.io.File;

 import java.io.FileWriter;

 import java.io.IOException;

 import java.util.Random;

 /**

  * Created by Administrator on 2017/11/13.

  */

 public class PeopleInfoFileGenerator {

     public static void main(String[] args){

         File file = new File("F:\\PeopleInfo.txt");

         try {

             Random random = new Random();//生成随机数

             FileWriter fileWriter = new FileWriter(file);//新建一个文件

             for (int i=1;i<=1000000;i++){   //生成10万个数字

                 int height = random.nextInt(220);

                 if (height < 50) {

                     height = height + 50;

                 }

              String  gender = getRandomGender(); //性别方法

              if (height < 100 && gender == "M") {

                  height = height + 100;

              }

               if (height < 100 && gender == "F") {

                   height = height + 40;

               }

              fileWriter.write( i + " " + getRandomGender() + " " + height); //文件格式:ID 性别 身高

              fileWriter.write(System.getProperty("line.separator"));

             }

             fileWriter.flush();

             fileWriter.close();

             System.out.println("People Information File generated successfully.");

         }catch (IOException e){

             e.printStackTrace();

         }

     }

     public static String getRandomGender(){ //构建一个随机生成性别方法

         Random random = new Random();

         int randomNum = random.nextInt(2) + 1;

         if( randomNum % 2 == 0){

             return "M";

         }else{

             return "F";

         }

     }

 }
c. 实例过程分析
对于这个案例,我们要分别统计男女的信息,那么很自然的想到首先需要对于男女信息从源文件的对应的 RDD 中进行分离,这样会产生两个新的 RDD,分别包含男女信息;其次是分别对男女信息对应的 RDD 的数据进行进一步映射,使其只包含身高数据,这样我们又得到两个 RDD,分别对应男性身高和女性身高;最后需要对这两个 RDD 进行排序,进而得到最高和最低的男性或女性身高。
第一步,先分离男女信息,使用 filter 算子过滤条件包含”M” 的行是男性,包含”F”的行是女性;第二步我们需要使用 map 算子把男女各自的身高数据从 RDD 中分离出来;第三步我们需要使用 sortBy 算子对男女身高数据进行排序。
特别注意:RDD 转化的过程中需要把身高数据转换成整数,否则 sortBy 算子会把它视为字符串,那么排序结果就会受到影响,例如 身高数据如果是:123,110,84,72,100,那么升序排序结果将会是 100,110,123,72,84,显然这是不对的。
d.求出身高统计代码实现
 import org.apache.spark.SparkConf;

 import org.apache.spark.api.java.JavaRDD;

 import org.apache.spark.api.java.JavaSparkContext;

 import org.apache.spark.api.java.function.FlatMapFunction;

 import org.apache.spark.api.java.function.Function;

 import java.util.Arrays;

 /**

  * Created by Administrator on 2017/11/17.

  */

 public class PeopleInfoCalculator {

     public static void main(String[] args){

         SparkConf sparkConf = new SparkConf().setAppName("PeopleInfoCalculator").setMaster("local[3]");

         JavaSparkContext sc = new JavaSparkContext(sparkConf);

         JavaRDD<String> dataFile = sc.textFile("F:\\PeopleInfo.txt");

         JavaRDD<String> maleFilterData = dataFile.filter(new Function<String, Boolean>() {//过滤出性别为M的数据

             @Override

             public Boolean call(String s) throws Exception {

                 return s.contains("M");

             }

         });

         JavaRDD<String> femaleFilterData = dataFile.filter(new Function<String, Boolean>() {//过滤出性别为F的数据

             @Override

             public Boolean call(String s) throws Exception {

                 return s.contains("F");

             }

         });

         JavaRDD<String> maleHeightData = maleFilterData.flatMap(new FlatMapFunction<String, String>() {//得到性别为M的身高数据

             @Override

             public Iterable<String> call(String s) throws Exception {

                 return Arrays.asList(s.split(" ")[2]);

             }

         });

         JavaRDD<String> femaleHeightData = femaleFilterData.flatMap(new FlatMapFunction<String, String>() {//得到性别为F的身高数据

             @Override

             public Iterable<String> call(String s) throws Exception {

                 return Arrays.asList(s.split(" ")[2]);

             }

         });

         JavaRDD<Integer> maleHeightDataInt = maleHeightData.map(new Function<String, Integer>() {//将字符串格式转化为整型格式

             @Override

             public Integer call(String s) throws Exception {

                 return Integer.parseInt(String.valueOf(s));

             }

         });

         JavaRDD<Integer> femaleHeightDataInt = femaleHeightData.map(new Function<String, Integer>() {//将字符串格式转化为整型格式

             @Override

             public Integer call(String s) throws Exception {

                 return Integer.parseInt(String.valueOf(s));

             }

         });

         //sortBy(<T>,ascending,numPartitions) 解释:

         //第一个参数是一个函数,该函数的也有一个带T泛型的参数,返回类型和RDD中元素的类型是一致的;

         //第二个参数是ascending,这参数决定排序后RDD中的元素是升序还是降序,默认是true,也就是升序;

         //第三个参数是numPartitions,该参数决定排序后的RDD的分区个数,默认排序后的分区个数和排序之前的个数相等,即为this.partitions.size。

         JavaRDD<Integer> maleHeightLowSort = maleHeightDataInt.sortBy(new Function<Integer,Integer>(){// true表示默认排序,为升序排序,从低到高排

             public Integer call(Integer s) throws Exception {

                 return s;

             }

         },true,3);

         JavaRDD<Integer> femaleHeightLowSort = femaleHeightDataInt.sortBy(new Function<Integer,Integer>(){// true表示默认排序,为升序排序,从低到高排

             public Integer call(Integer s) throws Exception {

                 return s;

             }

         },true,3);

         JavaRDD<Integer> maleHeightHightSort = maleHeightDataInt.sortBy(new Function<Integer,Integer>(){// false表示为降序排序,从高到低

             public Integer call(Integer s) throws Exception {

                 return s;

             }

         },false,3);

         JavaRDD<Integer> femaleHeightHightSort = femaleHeightDataInt.sortBy(new         Function<Integer,Integer>(){// true表示默认排序,为降序排序,从低到高排

             public Integer call(Integer s) throws Exception {

                 return s;

             }

         },false,3);

         Integer lowestMale = maleHeightLowSort.first(); //求出升序的第一个数,即最小值

         Integer lowestFemale = femaleHeightLowSort.first();//求出升序的第一个数,即最小值

         Integer highestMale = maleHeightHightSort.first();//求出降序的第一个数,即最大值

         Integer highestFemale = femaleHeightHightSort.first();//求出降序的第一个数,即最大值

         System.out.println("Number of Female Peole:" + femaleHeightData.count());//求出女性的总个数

         System.out.println("Number of Male Peole:" + maleHeightData.count());//求出男性的总个数

         System.out.println("Lowest Male:" + lowestMale);//求出男性最矮身高

         System.out.println("Lowest Female:" + lowestFemale);//求出女性最矮身高

         System.out.println("Highest Male:" + highestMale);//求出男性最高身高

         System.out.println("Highest Female:" + highestFemale);//求出女性最高身高

     }

 }
e.运行结果:

spark 应用场景2-身高统计的更多相关文章
- Spark学习笔记1——第一个Spark程序:单词数统计
Spark学习笔记1--第一个Spark程序:单词数统计 笔记摘抄自 [美] Holden Karau 等著的<Spark快速大数据分析> 添加依赖 通过 Maven 添加 Spark-c ...
- Spark案例练习-UV的统计
关注公众号:分享电脑学习回复"百度云盘" 可以免费获取所有学习文档的代码(不定期更新)云盘目录说明:tools目录是安装包res 目录是每一个课件对应的代码和资源等doc 目录是一 ...
- spark 应用场景1-求年龄平均值
原文引自:http://blog.csdn.net/fengzhimohan/article/details/78535143 该案例中,我们将假设我们需要统计一个 10 万人口的所有人的平均年龄,当 ...
- spark SQL学习(案例-统计每日销售)
需求:统计每日销售额 package wujiadong_sparkSQL import org.apache.spark.sql.types._ import org.apache.spark.sq ...
- spark SQL学习(案例-统计每日uv)
需求:统计每日uv package wujiadong_sparkSQL import org.apache.spark.sql.{Row, SQLContext} import org.apache ...
- Spark Streaming的样本demo统计
废话不多说,直接上代码 package com.demo; import java.util.List; import java.util.regex.Pattern; import org.apac ...
- Spark应用场景以及与hadoop的比较
一.大数据的四大特征: a.海量的数据规模(volume) b.快速的数据流转和动态的数据体系(velocity) c.多样的数据类型(variety) d.巨大的数据价值(value) 二.Spar ...
- Spark案例练习-PV的统计
关注公众号:分享电脑学习回复"百度云盘" 可以免费获取所有学习文档的代码(不定期更新) 云盘目录说明: tools目录是安装包res 目录是每一个课件对应的代码和资源等doc ...
- Spark词频前十的统计练习
注:图片如果损坏,点击文章链接:https://www.toutiao.com/i6815390070254600712/ 承接上一个文档<Spark本地环境实现wordCount单词计数> ...
随机推荐
- 前端 -- javas-基本语法/引用等
javas-基本语法/引用等 JavaScript介绍 JavaScript是运行在浏览器端的脚步语言,JavaScript主要解决的是前端与用户交互的问题,包括使用交互与数据交互. JavaScri ...
- Ubuntu安装msf
环境 root运行 ubuntu18.04 腾讯云服务器 控制面板上面所有的端口全部放行 本机自带防火墙已拆 拆墙是为了能msf接受到会话 安装 curl https://raw.githubuser ...
- NX二次开发-UFUN获取当前所在的模块UF_ask_application_module
NX9+VS2012 #include <uf.h> #include <NXOpen/UI.hxx> #include <NXOpen/MenuBar_MenuBarM ...
- Java-javaFx库运用-时钟显示
JavaFx是开发Java GUI程序的新框架.JavaFX应用可以无缝地在桌面或web浏览器中运行.具有内建的2D.3D动画支持,以及视频和音频的回放功能,可以作为一个应用独立运行或者在浏览器中运行 ...
- CSS3:CSS3 渐变(Gradients)
ylbtech-CSS3:CSS3 渐变(Gradients) 1.返回顶部 1. CSS3 渐变(Gradients) CSS3 渐变(gradients)可以让你在两个或多个指定的颜色之间显示平稳 ...
- 测试VPS
wget freevps.us/downloads/bench.sh -O - -o /dev/null|bash
- 剑指offer——09青蛙跳台阶
题目描述 一只青蛙一次可以跳上1级台阶,也可以跳上2级.求该青蛙跳上一个n级的台阶总共有多少种跳法(先后次序不同算不同的结果). 题解: 说俗一点,就是找规律: 不不,首先,我们分析一下,青蛙第一 ...
- Python匹马行天下之面向对象
概述 面向过程:根据业务逻辑从上到下写垒代码 函数式:将某功能代码封装到函数中,日后便无需重复编写,仅调用函数即可 面向对象:对函数进行分类和封装,让开发“更快更好更强...” 面向过程编程最易被初学 ...
- 【Latex】一些使用
http://www.mohu.org/info/symbols/symbols.htm GG..研究个公式就搞这么晚了..还不知道那三个报错的是怎么回事.. 意识模糊..睡了睡了. # Latex ...
- CentOS7中下载MySQL
~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~CentOS 7中,yum默认安装的是Mariadb,但我想使用MyS ...