
Lucene之分析器
什么是分析器?
分析(Analysis)在Lucene中指的是将域(Field)文本转换为最基本的索引表示单元—项(Term)的过程。
分析器(Analyzer)对分析操作进行了封装,通过执行一系列操作,将文本语汇单元化,
这些操作包括提取单词、去除标点符号、去除语汇单元上的音调符号、将大写字母转换成小写、移除常用词、将单词转换为词干(词干还原)等。
标准分析器
  @Test

    //默认分析器

    public void testTokenStream() throws IOException {

        //创建一个标准分析器对象

        Analyzer analyzer = new StandardAnalyzer();

        //获得tokenStream对象

        //第一个参数:域名,可以随便给一个

        //第二个参数:要分析的文本内容

        TokenStream tokenStream = analyzer.tokenStream("test", "The Spring Framework provides a comprehensive programming and configuration model.");

        //添加一个引用,可以获得每个关键词

        CharTermAttribute charTermAttribute = tokenStream.addAttribute(CharTermAttribute.class);

        //添加一个偏移量的引用,记录了关键词的开始位置以及结束位置

        OffsetAttribute offsetAttribute = tokenStream.addAttribute(OffsetAttribute.class);

        //将指针调整到列表的头部

        tokenStream.reset();

        //遍历关键词列表,通过incrementToken方法判断列表是否结束

        while(tokenStream.incrementToken()) {

            //关键词的起始位置

            System.out.println("start->" + offsetAttribute.startOffset());

            //取关键词

            System.out.println(charTermAttribute);

            //结束位置

            System.out.println("end->" + offsetAttribute.endOffset());

        }

        tokenStream.close();

    }
效果
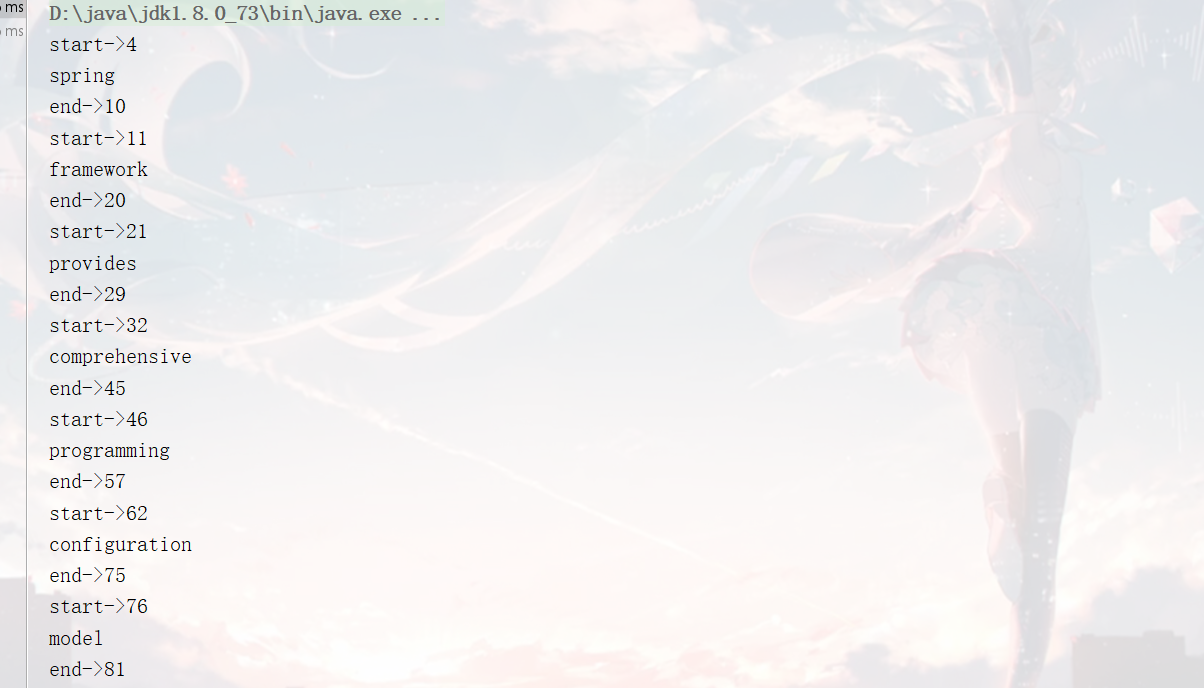
中文分析器
第三方中文分析器:IKAnalyzer
IK Analyzer是一个开源的,基于java语言开发的轻量级的中文分词工具包。从2006年12月推出1.0版开始, IKAnalyzer已经推出了4个大版本。最初,它是以开源项目Luence为应用主体的,结合词典分词和文法分析算法的中文分词组件。从3.0版本开始,IK发展为面向Java的公用分词组件,独立于Lucene项目,同时提供了对Lucene的默认优化实现。在2012版本中,IK实现了简单的分词歧义排除算法,标志着IK分词器从单纯的词典分词向模拟语义分词衍化。
导入依赖
	<!-- https://mvnrepository.com/artifact/com.jianggujin/IKAnalyzer-lucene -->

					<dependency>

						<groupId>com.jianggujin</groupId>

						<artifactId>IKAnalyzer-lucene</artifactId>

						<version>8.0.0</version>

					</dependency>
配置IKAnalyzer,导入配置文件
hotword.dic 扩展词典,可以将时尚的网络名词放入到该词典当中,这样就能根据扩展词典进行分词
stopword.dic 停用词词典,可以将无意义的词和敏感词汇放入到该词典当中,这样在分析的时候就会忽略这些内容
在自定义扩展词典和停用词词典的过程当中,千万不要使用windows记事本编辑,因为windows记事本是UTF-8+BOM编码
使用IKAnalyzer进行分词
    @Test

    //自定义分析器

    public void addDocument() throws Exception {

        //1.创建一个Analyzer对象

        Analyzer analyzer=new IKAnalyzer();

        //2.调用Analyzer对象的tokenStream方法获取TokenStream对象,此对象包含了所有的分词结果

        TokenStream tokenStream = analyzer.tokenStream("", "五道口课工场安装mysql-5.7.22-winx64后数据库服务启动报错:本地计算机上的mysql服务启动停止后,某些服务未由其他服务或程序使用时将自动停止而且mysql官网下载的压缩包解压出来没有网线上安装教... 博文 来自: 测试菜鸟在路上,呵呵");

        //3.给tokenStream对象设置一个指针,指针在哪当前就在哪一个分词上

        CharTermAttribute charTermAttribute = tokenStream.addAttribute(CharTermAttribute.class);

        //4.调用tokenStream对象的reset方法,重置指针,不调用会报错

        tokenStream.reset();

        //5.利用while循环,拿到分词列表的结果  incrementToken方法返回值如果为false代表读取完毕  true代表没有读取完毕

        while (tokenStream.incrementToken()){

            System.out.println(charTermAttribute.toString());

        }

        //6.关闭

        tokenStream.close();

    }
效果
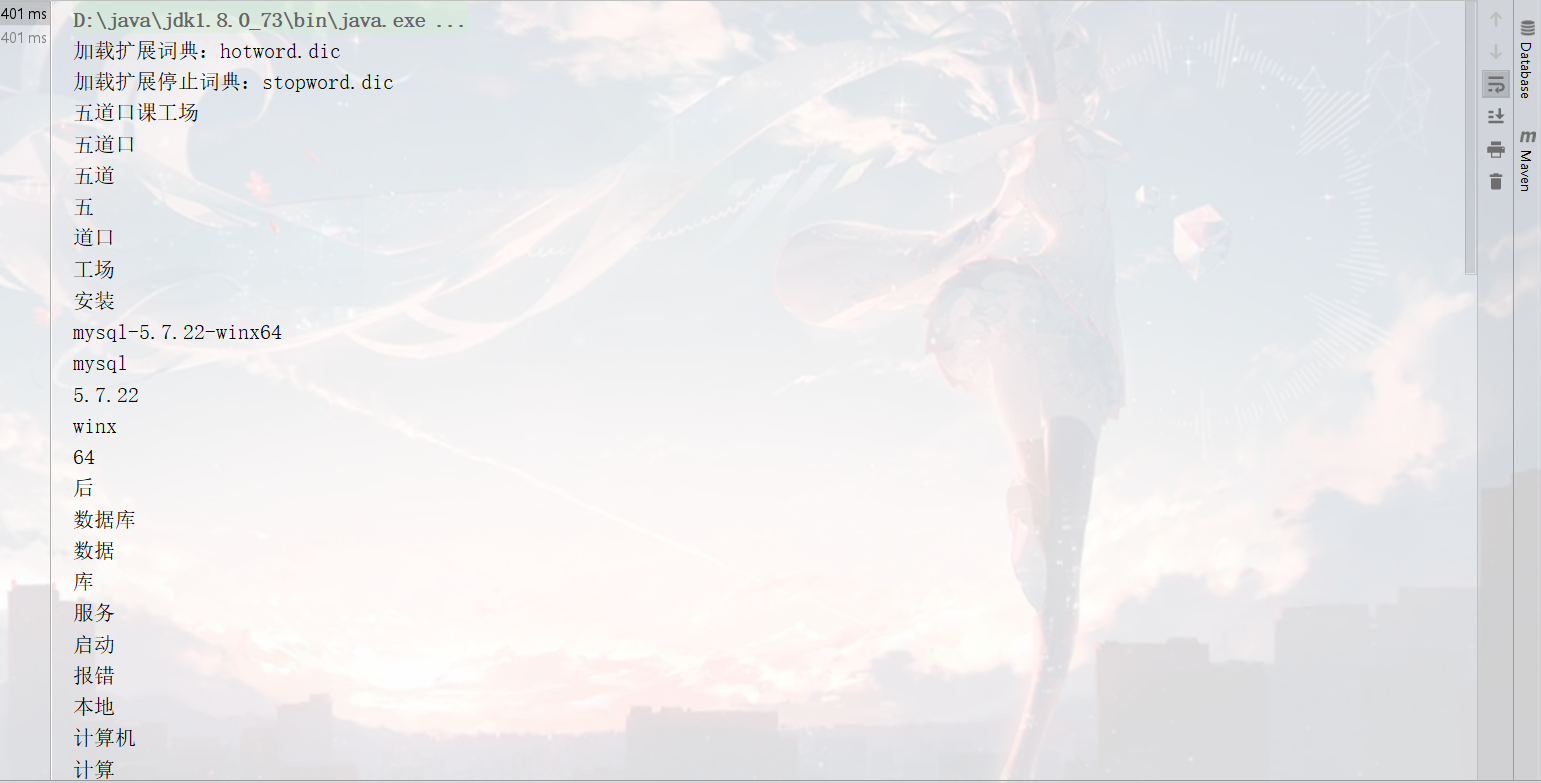
创建的时候使用IKAnalyzer
IndexWriter indexWriter=new IndexWriter(directory,new IndexWriterConfig(new IKAnalyzer()));
Lucene之分析器的更多相关文章
- Lucene系列-分析器
分析器介绍 搜索的基础是对文本信息进行分析,Lucene的分析工具在org.apache.lucene.analysis包中.分析器负责对文本进行分词.语言处理得到词条,建索引和搜索的时候都需要用到分 ...
- Lucene教程(转)
Lucene教程 1 lucene简介1.1 什么是lucene Lucene是一个全文搜索框架,而不是应用产品.因此它并不像www.baidu.com 或者google Desktop那么拿来 ...
- lucene教程简介
1 lucene简介 1.1 什么是lucene Lucene是一个全文搜索框架,而不是应用产品.因此它并不像www.baidu.com 或者google Desktop那么拿来就能用,它只是 ...
- Lucene教程--转载
Lucene教程 1 lucene简介1.1 什么是lucene Lucene是一个全文搜索框架,而不是应用产品.因此它并不像www.baidu.com 或者google Desktop那么拿来 ...
- Lucene教程具体解释
(建立索引)] )中生成的索引文件的存放地址.详细步骤简单介绍例如以下: 1.创建Directory对象,索引目录 2.创建IndexSearch对象,建立查询(參数是Directory对象) 3.创 ...
- Lucene技术杂谈
Lucene教程 1 lucene简介 1.1 什么是lucene Lucene是一个全文搜索框架,而不是应用产品.因此它并不像www.baidu.com 或者google Desktop那么 ...
- Lucene实例教程
Lucene是apache组织的一个用java实现全文搜索引擎的开源项目. 其功能非常的强大,api也很简单.总得来说用Lucene来进行建立 和搜索和操作数据库是差不多的(有点像),Document ...
- Lucene入门教程(转载)
http://blog.csdn.net/tianlincao/article/details/6867127 Lucene教程 1 lucene简介 1.1 什么是lucene Lucene ...
- Lucene&Solr框架之第一篇
2.信息检索 信息检索是计算机世界中非常重要的一种功能.信息检索不仅仅是指从数据库检索数据,还包括从文件.网页.邮件.用户手输入的内容中检索数据.通过怎样的高效方式将用户想要的信息快速提取出来,是计算 ...
随机推荐
- jvm内存模型、常见参数及调优
JVM内存结构: 主要分为:方法区.堆.虚拟机栈.本地方法栈.程序计数器,其中方法区和堆是线程共享的,其他的都是线程隔离的. 方法区: 主要存放类的信息.静态变量.常量.编译后的方法代码,永久代Per ...
- keras冒bug
使用keras做vgg16的迁移学习实验,在实现的过程中,冒各种奇怪的bug,甚至剪贴复制还是出问题. 解决方案: 当使用组合keras和tensorflow.keras时.由于版本不一致问题导致很多 ...
- SelectiveSearchCodeIJCV遇到First two input arguments should have the same 2D dimension
在windows 10+visual studio环境下运行SelectiveSearchCodeIJCV中的demo.m难免会出现下列错误 ----------------------- if(~e ...
- 解决SpringMvc后台接收json数据中文乱码问题
原因分析 使用ajax从前台页面传输数据到后台controller控制器的时候,出现中文乱码 其实乱码问题出现的原因,就是由于默认的tomcat配置,接收请求是以ISO-8859-1来转码,导致中文出 ...
- Maven: 每次更新Maven Project ,JAVA 版本都变为1.5
由于Maven默认编译环境是JAVA 1.5 ,所以我们需要在pom.xml指定编译插件版本号,这样就可以保证更新Maven project版本不变. <!-- java编译插件 --> ...
- Unreal Engine 4 蓝图完全学习教程(四)—— 变量与计算
Ⅰ.值的基础类型 ①文本.字符串(Text.String):文本类型的值. ②整型.浮点型(Int.Float):数字类型的值. ③布尔型(Bool):表示“真或假”二者选其一的状态. Ⅱ.加法运算 ...
- 如何在OpenStack中对云主机类型进行重新配置
目标:很多用户在OpenStack启动一个虚拟机,选择了一个云主机配置类型,例如2CPU 4GB内存,使用了一段时间,感觉这个配置并不能满足需求,所以希望能够提高配置,那么OpeNStack的管理界面 ...
- mycat - 数据库中间件 学习记录4
mycat的配置 cacheservice.properties:路由缓存相关配置文件 index_to_charset.properties:字符集映射关系 rule.xml:分片规则 schema ...
- Codeforces gym101755H Safe Path(bfs)
题意: 给以一个网格图,有起点终点和一些怪兽,可以上下左右走,不能走到距离怪兽曼哈顿距离为d以内的地方,问到终点最短路径 n*m<=2e5,d<=2e5 思路: 因为n*m的范围,不能直接 ...
- Go语言实现:【剑指offer】调整数组顺序使奇数位于偶数前面
该题目来源于牛客网<剑指offer>专题. 输入一个整数数组,实现一个函数来调整该数组中数字的顺序,使得所有的奇数位于数组的前半部分,所有的偶数位于数组的后半部分,并保证奇数和奇数,偶数和 ...