
【离线数仓】Day04-即席查询(Ad Hoc):Presto链接不同数据源查询、Druid建多维表、Kylin使用cube快速查询


一、Presto
1、简介
概念:大数据量、秒级、分布式SQL查询engine【解析SQL但不是数据库】
架构

不同worker对应不同的数据源(各数据源有对应的connector连接适配器)
优缺点
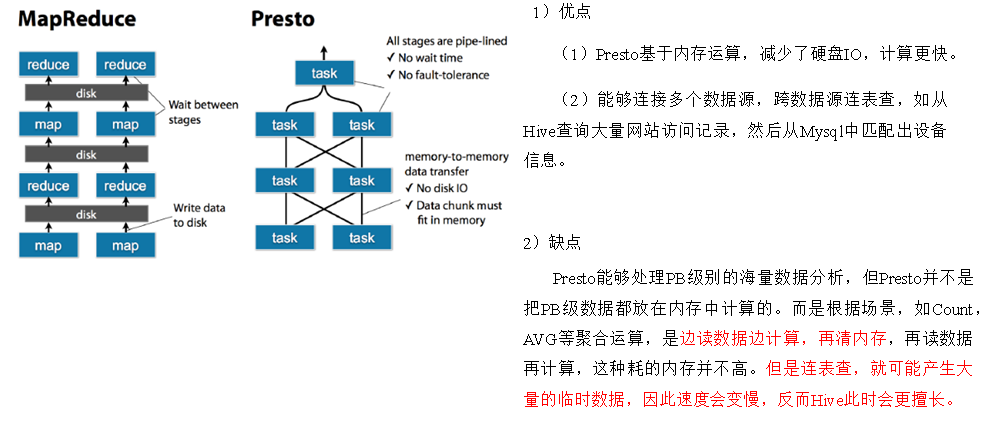
缺点:读数据连查表会产生大量临时数据
与impala比较
Impala性能稍领先于Presto,但是Presto在数据源支持上非常丰富,如redis
2、安装
server安装
配置一个Hive的catalog
在hadoop102上配置成coordinator,在hadoop103、hadoop104上配置为worker
client安装:[atguigu@hadoop102 presto]$ ./prestocli --server hadoop102:8881 --catalog hive --schema default
可视化client安装:
[atguigu@hadoop102 yanagishima-18.0]$
nohup bin/yanagishima-start.sh >y.log 2>&1 &
3、Presto优化之数据存储
合理设置分区
使用列式存储:相对于Parquet,Presto对ORC支持更好
使用压缩:采用Snappy压缩
4、Presto优化之查询SQL
选择使用的字段
过滤条件加分区字段:where语句中优先使用分区字段进行过滤
Group By优化:合理安排Group by语句中字段顺序,按照每个字段distinct数据多少进行降序排列
Order By时使用Limit:查询Top N或者Bottom N
使用Join语句时将大表放在左边:join左边的表分割到多个worker,然后将join右边的表数据整个复制一份
5、其他注意事项
字段名反引用:MySQL对字段加反引号`、Presto对字段加双引号分割,以避免和关键字冲突
时间函数:SELECT t FROM a WHERE t > timestamp '2017-01-01 00:00:00';
不支持INSERT OVERWRITE语法:先delete,然后insert into
PARQUET格式:支持Parquet格式,支持查询,但不支持insert
二、Druid
1、简介
概念:快速、列式、分布式、支持实时分析的数据存储系统,性能比OLAP高(PB数据、毫秒查询、实时处理)
与阿里的Druid连接池无关
特点
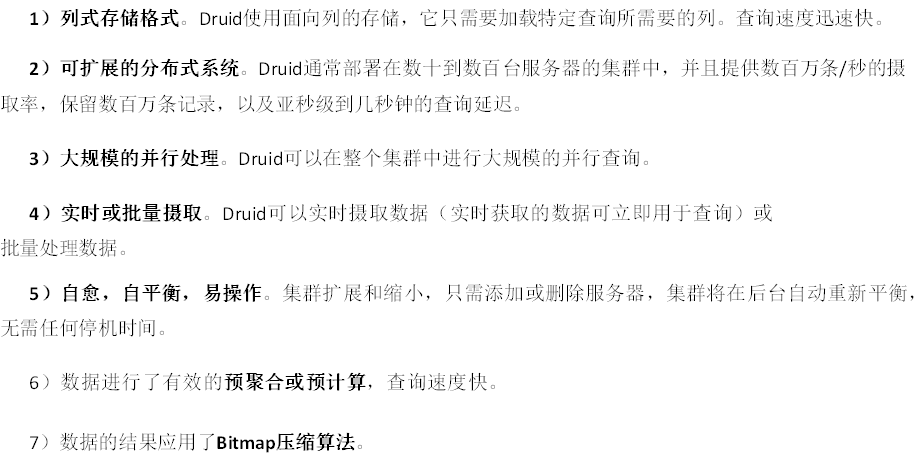
应用场景(单表、不更新),按照时间分片


2、框架原理

3、数据结构
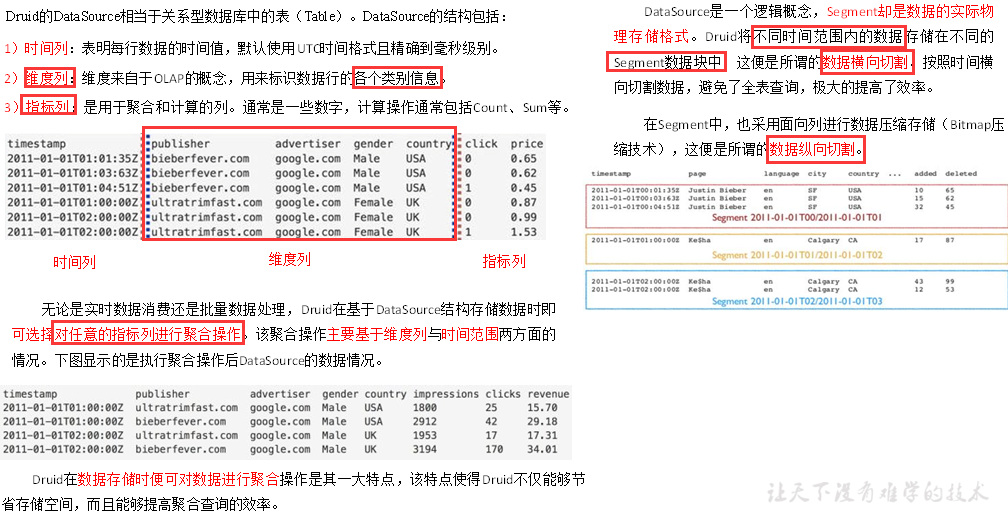
4、Druid安装(单机版)
改配置(不用内置zk)
启动:[atguigu@hadoop102 imply]$ bin/supervise -c conf/supervise/quickstart.conf
启动采集Flume和Kafka
web页面
启动日志生成程序,登录页面加载数据,创建数据库表配置及时间字段
使用SQL查询
三、Kylin
1、Kylin简介
定义
分布式分析引擎,快速查询巨大的Hive表
架构
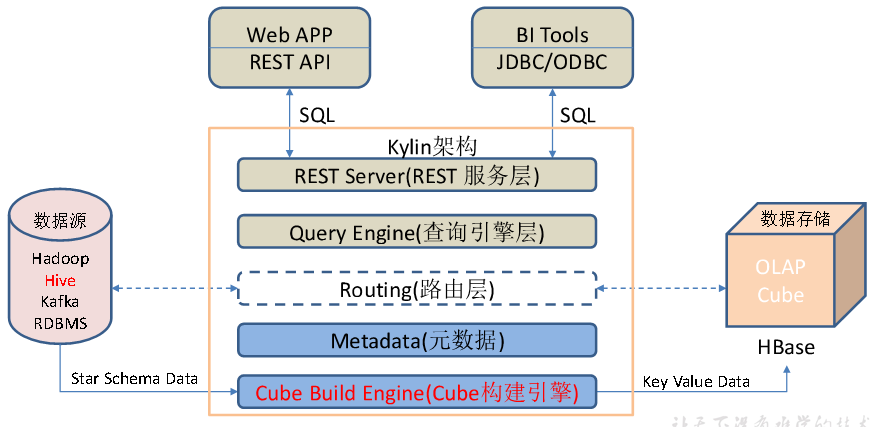
Kylin的元数据存储在hbase中
任务引擎对Kylin当中的全部任务加以管理与协调
特点:支持SQL接口、支持超大规模数据集、亚秒级响应、可伸缩性、高吞吐率、BI工具集成等
2、安装
依赖环境:先部署好Hadoop、Hive、Zookeeper、HBase
启动:bin/kylin.sh start
http://hadoop102:7070/kylin查看Web页面
3、使用:使用Kylin进行OLAP分析
建工程
添加数据源(导入hive表)
创建model
选择维度表,并指定事实表和维度表的关联条件
构建cube,添加维度或者度量字段
选择要构建的时间区间
实现每日自动构建cube-编写脚本
4、cube构建原理

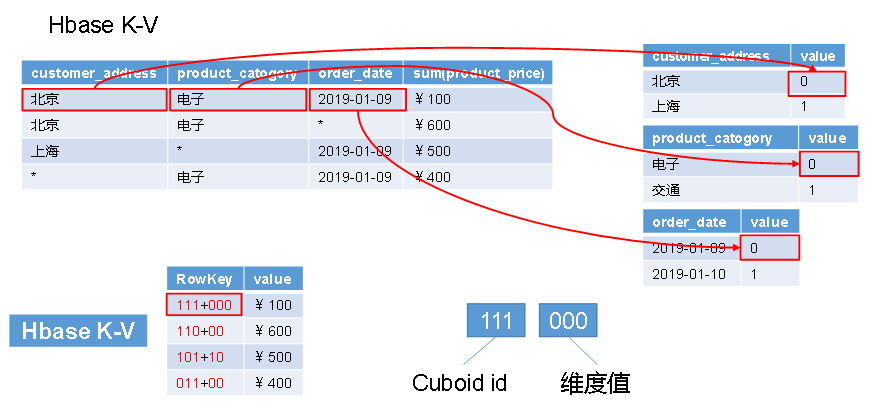
构建算法:逐层构建、快速构建
5、cube构建优化
使用衍生维度-中间表实现主到非主的映射
使用聚合组:强制维度、层级维度、联合维度
Row Key优化:用作where过滤的维度放在前边、基数大的维度放在基数小的维度前边
并发粒度优化
6、Kylin Bi工具集成
与Kylin结合使用的可视化工具很多,例如:
ODBC:与Tableau、Excel、PowerBI等工具集成
JDBC:与Saiku、BIRT等Java工具集成
RestAPI:与JavaScript、Web网页集成
Kylin开发团队还贡献了Zepplin的插件,也可以使用Zepplin来访问Kylin服务。
JDBC
Zepplin:[atguigu@hadoop102 zeppelin]$ bin/zeppelin-daemon.sh start
修改配置
添加Note并编写SQL语句查询

【离线数仓】Day04-即席查询(Ad Hoc):Presto链接不同数据源查询、Druid建多维表、Kylin使用cube快速查询的更多相关文章
- 技术专家说 | 如何基于 Spark 和 Z-Order 实现企业级离线数仓降本提效?
[点击了解更多大数据知识] 市场的变幻,政策的完善,技术的革新--种种因素让我们面对太多的挑战,这仍需我们不断探索.克服. 今年,网易数帆将持续推出新栏目「金融专家说」「技术专家说」「产品专家说」等, ...
- 即席查询(Ad Hoc)如何做到又快又稳?
数字化与数字生态建设,是当前所有企业成长发展的必经之路.随着"加强新型基础设施建设"第一次被写入政府工作报告,5G.人工智能.工业互联网.智慧城市等新型基建彻底激发了数字的价值. ...
- 传统 BI 如何转大数据数仓
前几天建了一个数据仓库方向的小群,收集了大家的一些问题,其中有个问题,一哥很想去谈一谈--现在做传统数仓,如何快速转到大数据数据呢?其实一哥知道的很多同事都是从传统数据仓库转到大数据的,今天就结合身边 ...
- 看SparkSql如何支撑企业数仓
企业级数仓架构设计与选型的时候需要从开发的便利性.生态.解耦程度.性能. 安全这几个纬度思考.本文作者:惊帆 来自于数据平台 EMR 团队 前言 Apache Hive 经过多年的发展,目前基本已经成 ...
- Optimize For Ad Hoc Workloads
--临时工作负载优化 即席查询:也就是查询完没放到Cache当中,每次查询都要重新经过编译,并发高的时候很耗性能: 参数化查询: 一方面解决了重编译问题,但随着数据库数据数据的变更,统计信息的更新 ...
- 数仓1.1 分层| ODS& DWD层
数仓分层 ODS:Operation Data Store原始数据 DWD(数据清洗/DWI) data warehouse detail数据明细详情,去除空值,脏数据,超过极限范围的明细解析具体表 ...
- 阿里下一代云分析型数据库AnalyticDB入选Forrester云化数仓象限
前言 近期, 全球权威IT咨询机构Forrester发布"The Forrester Wave: CloudData Warehouse Q4 2018"研究报告,阿里巴巴分析型数 ...
- 阿里巴巴下一代云分析型数据库AnalyticDB入选Forrester Wave™ 云数仓评估报告 解读
前言近期, 全球权威IT咨询机构Forrester发布"The Forrester WaveTM: CloudData Warehouse Q4 2018"研究报告,阿里巴巴分析型 ...
- 基于Hive进行数仓建设的资源元数据信息统计:Spark篇
在数据仓库建设中,元数据管理是非常重要的环节之一.根据Kimball的数据仓库理论,可以将元数据分为这三类: 技术元数据,如表的存储结构结构.文件的路径 业务元数据,如血缘关系.业务的归属 过程元数据 ...
- ETL数仓测试
前言 datalake架构 离线数据 ODS -> DW -> DM https://www.jianshu.com/p/72e395d8cb33 https://www.cnblogs. ...
随机推荐
- 如何使用netlify部署vue应用程序
什么是Netlify? Netlify是一个现代网站自动化系统,其JAM架构代表了现代网站的发展趋势.所谓JAM,就是指基于客户端JavaScript.可重用API和预构建Markup标记语言的三者结 ...
- Vue3 JS 与 SCSS 变量相互使用
在开发中会遇到如下需求: JS 中使用 SCSS 变量.如在 scss 中定义了一个颜色,el-menu 组件使用该颜色作为背景色,此时需要获取 scss 变量,通过 background-color ...
- 驱动开发:内核特征码扫描PE代码段
在笔者上一篇文章<驱动开发:内核特征码搜索函数封装>中为了定位特征的方便我们封装实现了一个可以传入数组实现的SearchSpecialCode定位函数,该定位函数其实还不能算的上简单,本章 ...
- 3.MongoDB系列之查询
1. find简介 // 查询所有文档 db.users.find({}) // 查询指定条件文档 db.users.find({'name': 'shenjian'}) // 查询指定字段,1查询键 ...
- 2022年最新最详细的tomcat安装教程和常见问的解决
文章目录 1.官网直接下载 1.1.jdk的版本和tomcat版本应该相对应或者兼容 1.2. 在官网找对应的tomcat版本进行下载 1.3 .根据电脑版本下载64-bit windows zip( ...
- springboot+mybatis+shiro项目中使用shiro实现登录用户的权限验证。权限表、角色表、用户表。从不同的表中收集用户的权限、
要实现的目的:根据登录用户.查询出当前用户具有的所有权限.然后登录系统后.根据查询到的权限信息进行不同的操作. 以下的代码是在搭好的框架之下进行的编码. 文章目录 核心实现部分. 第一种是将用户表和角 ...
- 自己动手写线程池——向JDK线程池进发
自己动手写线程池--向JDK线程池进发 前言 在前面的文章自己动手写乞丐版线程池中,我们写了一个非常简单的线程池实现,这个只是一个非常简单的实现,在本篇文章当中我们将要实现一个和JDK内部实现的线程池 ...
- 是什么让.NET7的Min和Max方法性能暴增了45倍?
简介 在之前的一篇文章.NET性能系列文章一:.NET7的性能改进中我们聊到Linq中的Min()和Max()方法.NET7比.NET6有高达45倍的性能提升,当时Benchmark代码和结果如下所示 ...
- 【k8s】k8s pv、pvc无法删除问题。
一般删除步骤为:先删除pod再删除pvc最后删除pv 遇到的问题 但是遇到pv使用处于"Terminating"状态,而且删不掉.如下图: 解决办法 直接删除k8s中的记录: ku ...
- 来啦来啦|开源 * 安全 * 赋能 - .NET Conf China 2022
大会介绍 .NET Conf China 2022 是面向开发人员的社区峰会,延续 .NET Conf 2022 的活动,庆祝 .NET 7 的发布和回顾过去一年来 .NET 在中国的发展成果,它是由 ...