
毕设一:python 爬取苏宁的商品评论
毕设需要大量的商品评论,网上找的数据比较旧了,自己动手
代理池用的proxypool,github:https://github.com/jhao104/proxy_pool
ua:fake_useragent
 # 评价较多的店铺(苏宁推荐)

 https://tuijian.suning.com/recommend-portal/recommendv2/biz.jsonp?parameter=%E5%8D%8E%E4%B8%BA&sceneIds=2-1&count=10

 # 评价

 https://review.suning.com/ajax/cluster_review_lists/general-30259269-000000010748901691-0000000000-total-1-default-10-----reviewList.htm?callback=reviewList

 # clusterid

 # 在查看全部评论的href中,实际测试发现是执行js加上的,两种方案

 # 1.去匹配js中的clusterId

 # 2.或者用selenium/phantomjs去请求执行js之后的页面然后解析html获得href
代码:
 # -*- coding: utf-8 -*-

 # @author: Tele

 # @Time  : 2019/04/15 下午 8:20

 import time

 import requests

 import os

 import json

 import re

 from fake_useragent import UserAgent

 class SNSplider:

     flag = True

     regex_cluser_id = re.compile("\"clusterId\":\"(.{8})\"")

     regex_comment = re.compile("reviewList\((.*)\)")

     @staticmethod

     def get_proxy():

         return requests.get("http://127.0.0.1:5010/get/").content.decode()

     @staticmethod

     def get_ua():

         ua = UserAgent()

         return ua.random

     def __init__(self, kw_list):

         self.kw_list = kw_list

         # 评论url 参数顺序:cluser_id,sugGoodsCode,页码

         self.url_temp = "https://review.suning.com/ajax/cluster_review_lists/general-{}-{}-0000000000-total-{}-default-10-----reviewList.htm"

         self.headers = {

             "User-Agent": "Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.106 Safari/537.36",

         }

         self.proxies = {

             "http": None

         }

         self.parent_dir = None

         self.file_dir = None

     # ua,proxy

     def check(self):

         self.headers["User-Agent"] = SNSplider.get_ua()

         proxy = "http://" + SNSplider.get_proxy()

         self.proxies["http"] = proxy

         print("ua:", self.headers["User-Agent"])

         print("proxy:", self.proxies["http"])

     # 评论

     def parse_url(self, cluster_id, sugGoodsCode, page):

         url = self.url_temp.format(cluster_id, sugGoodsCode, page)

         response = requests.get(url, headers=self.headers, proxies=self.proxies, verify=False)

         if response.status_code == 200:

             print(url)

             if len(response.content) < 0:

                 return

             data = json.loads(SNSplider.regex_comment.findall(response.content.decode())[0])

             if "commodityReviews" in data:

                 # 评论

                 comment_list = data["commodityReviews"]

                 if len(comment_list) > 0:

                     item_list = list()

                     for comment in comment_list:

                         item = dict()

                         try:

                             # 商品名

                             item["referenceName"] = comment["commodityInfo"]["commodityName"]

                         except:

                             item["referenceName"] = None

                         # 评论时间

                         item["creationTime"] = comment["publishTime"]

                         # 内容

                         item["content"] = comment["content"]

                         # label

                         item["label"] = comment["labelNames"]

                         item_list.append(item)

                     # 保存

                     with open(self.file_dir, "a", encoding="utf-8") as file:

                         file.write(json.dumps(item_list, ensure_ascii=False, indent=2))

                         file.write("\n")

                     time.sleep(5)

             else:

                 SNSplider.flag = False

         else:

             print("评论页出错")

     # 提取商品信息

     def get_product_info(self):

         url_temp = "https://tuijian.suning.com/recommend-portal/recommendv2/biz.jsonp?parameter={}&sceneIds=2-1&count=10"

         result_list = list()

         for kw in self.kw_list:

             url = url_temp.format(kw)

             response = requests.get(url, headers=self.headers, proxies=self.proxies, verify=False)

             if response.status_code == 200:

                 kw_dict = dict()

                 id_list = list()

                 data = json.loads(response.content.decode())

                 skus_list = data["sugGoods"][0]["skus"]

                 if len(skus_list) > 0:

                     for skus in skus_list:

                         item = dict()

                         sugGoodsCode = skus["sugGoodsCode"]

                         # 请求cluserId

                         item["sugGoodsCode"] = sugGoodsCode

                         item["cluster_id"] = self.get_cluster_id(sugGoodsCode)

                         id_list.append(item)

                 kw_dict["title"] = kw

                 kw_dict["id_list"] = id_list

                 result_list.append(kw_dict)

             else:

                 pass

         return result_list

     # cluserid

     def get_cluster_id(self, sugGoodsCode):

         self.check()

         url = "https://product.suning.com/0000000000/{}.html".format(sugGoodsCode[6::])

         response = requests.get(url, headers=self.headers, proxies=self.proxies, verify=False)

         if response.status_code == 200:

             cluser_id = None

             try:

                 cluser_id = SNSplider.regex_cluser_id.findall(response.content.decode())[0]

             except:

                 pass

             return cluser_id

         else:

             print("请求cluster id出错")

     def get_comment(self, item_list):

         if len(item_list) > 0:

             for item in item_list:

                 id_list = item["id_list"]

                 item_title = item["title"]

                 if len(id_list) > 0:

                     self.parent_dir = "f:/sn_comment/" + item_title + time.strftime("-%Y-%m-%d-%H-%M-%S",

                                                                                     time.localtime(time.time()))

                     if not os.path.exists(self.parent_dir):

                         os.makedirs(self.parent_dir)

                     for product_code in id_list:

                         # 检查proxy,ua

                         sugGoodsCode = product_code["sugGoodsCode"]

                         cluster_id = product_code["cluster_id"]

                         if not cluster_id:

                             continue

                         page = 1

                         # 检查目录

                         self.file_dir = self.parent_dir + "/" + sugGoodsCode[6::] + "_ratecontent.txt"

                         self.check()

                         while SNSplider.flag:

                             self.parse_url(cluster_id, sugGoodsCode, page)

                             page += 1

                         SNSplider.flag = True

                 else:

                     print("---error,empty id list---")

         else:

             print("---error,empty item list---")

     def run(self):

         self.check()

         item_list = self.get_product_info()

         print(item_list)

         self.get_comment(item_list)

 def main():

     # , "华为mate20pro", "vivoz3", "oppok1", "荣耀8x", "小米9", "小米mix3", "三星s9", "iphonexr", "iphonexs"

     # "华为p30pro", "华为mate20pro", "vivoz3""oppok1""荣耀8x", "小米9"

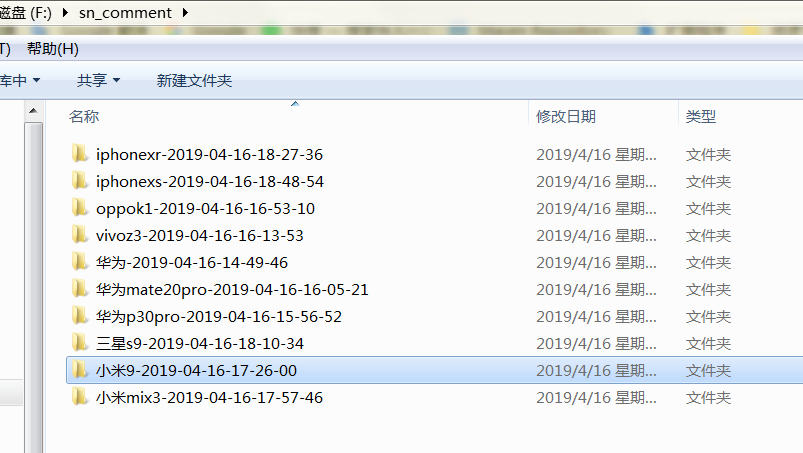
     kw_list = ["小米mix3", "三星s9", "iphonexr", "iphonexs"]

     splider = SNSplider(kw_list)

     splider.run()

 if __name__ == '__main__':

     main()
毕设一:python 爬取苏宁的商品评论的更多相关文章
- 毕设之Python爬取天气数据及可视化分析
写在前面的一些P话:(https://jq.qq.com/?_wv=1027&k=RFkfeU8j) 天气预报我们每天都会关注,我们可以根据未来的天气增减衣物.安排出行,每天的气温.风速风向. ...
- Python爬取淘宝店铺和评论
1 安装开发需要的一些库 (1) 安装mysql 的驱动:在Windows上按win+r输入cmd打开命令行,输入命令pip install pymysql,回车即可. (2) 安装自动化测试的驱动s ...
- python爬取网易云音乐歌曲评论信息
网易云音乐是广大网友喜闻乐见的音乐平台,区别于别的音乐平台的最大特点,除了“它比我还懂我的音乐喜好”.“小清新的界面设计”就是它独有的评论区了——————各种故事汇,各种金句频出.我们可以透过歌曲的评 ...
- 用Python爬取了三大相亲软件评论区,结果...
小三:怎么了小二?一副愁眉苦脸的样子. 小二:唉!这不是快过年了吗,家里又催相亲了 ... 小三:现在不是流行网恋吗,你可以试试相亲软件呀. 小二:这玩意靠谱吗? 小三:我也没用过,你自己看看软件评论 ...
- 毕设二:python 爬取京东的商品评论
# -*- coding: utf-8 -*- # @author: Tele # @Time : 2019/04/14 下午 3:48 # 多线程版 import time import reque ...
- 【Python爬虫案例学习】Python爬取淘宝店铺和评论
安装开发需要的一些库 (1) 安装mysql 的驱动:在Windows上按win+r输入cmd打开命令行,输入命令pip install pymysql,回车即可. (2) 安装自动化测试的驱动sel ...
- Python爬取网易云热歌榜所有音乐及其热评
获取特定歌曲热评: 首先,我们打开网易云网页版,击排行榜,然后点击左侧云音乐热歌榜,如图: 关于如何抓取指定的歌曲的热评,参考这篇文章,很详细,对小白很友好: 手把手教你用Python爬取网易云40万 ...
- Python 爬取所有51VOA网站的Learn a words文本及mp3音频
Python 爬取所有51VOA网站的Learn a words文本及mp3音频 #!/usr/bin/env python # -*- coding: utf-8 -*- #Python 爬取所有5 ...
- python爬取网站数据
开学前接了一个任务,内容是从网上爬取特定属性的数据.正好之前学了python,练练手. 编码问题 因为涉及到中文,所以必然地涉及到了编码的问题,这一次借这个机会算是彻底搞清楚了. 问题要从文字的编码讲 ...
随机推荐
- 学习笔记(三):jQuery之DOM
1.jQuery属性. 获取元素属性的语法: attr(name) 例子:$("#img1").attr("src"); 设 ...
- redhat6.5安装10201解决办法
rpm --import /etc/pki/rpm-gpg/RPM*yum install -y --skip-broken compat-libstdc++* elfutils-libelf* g ...
- C# C++ 字符串传递
C# C++ 字符串传递 标签: c#c++bytestring测试c 2012-06-14 17:425707人阅读评论(3)收藏举报 分类: C#(11) 作者同类文章X C++(112) 作 ...
- SSH进阶(2)——用Struts拦截器实现登陆限制
拦截器从字面意思来看就是限制.限制用户訪问某些网页.在Action提出请求之前用拦截器来做权限设置,让符合的用户跳入对应的界面中.近期做的一个商城项目中就用到了自己定义的拦截器,实现了一个简单的ses ...
- 中英文对照 —— 标点符号(punctuation)
有限的几个: What Are the Fourteen Punctuation Marks in English Grammar? period:句号:comma:逗号:冒号:colon:分号:se ...
- Codeforces Beta Round #24 D. Broken robot (打表找规律)
题目链接: 点击我打开链接 题目大意: 给你 \(n,j\),再给出 \(m[0]\) 的坐标和\(a[0]-a[n-1]\) 的坐标. 让你输出 \(m[j]\) 的坐标,其中 \(m[i]\) 和 ...
- JS实现动画的四条优化方法
JS实现动画的四条优化方法 1)如果使用的是setTimeout实现的轮询动画,在每一次执行方法之前需要把前面的设置的定时器清除掉 2)为了防止全局变量的污染,我们把定时器的返回值赋值给当前操作元素的 ...
- python课程:python3函数
摘自廖雪峰的网站:https://www.liaoxuefeng.com/wiki/0014316089557264a6b348958f449949df42a6d3a2e542c000/0014316 ...
- 【b091&&z11】潜伏者
Time Limit: 1 second Memory Limit: 128 MB [问题描述] R国和S国正陷入战火之中,双方都互派间谍,潜入对方内部,伺机行动. 历尽艰险后,潜伏于S国的R国间谍小 ...
- Oracle性能分析12:对象统计信息
对象统计信息描写叙述数据是如何在数据库中存储的,查询优化器使用这些统计信息来做出正确的决定.Oracle中有三种类型的对象统计信息:表统计.列统计和索引统计.而在每种类型中,有细分为:表或索引级别的统 ...