
xgboost-python参数深入理解
由于在工作中应用到xgboost做特征训练预测,因此需要深入理解xgboost训练过程中的参数的意思和影响。
通过search,https://www.analyticsvidhya.com/blog/2016/03/complete-guide-parameter-tuning-xgboost-with-codes-python/中有很详细的解释。
结合自身调参的运用,主要记录内容如下:
1、简介xgboost
2、参数理解
3、参数调优
xgboost参数
xgboost的参数可以分为三种类型:通用参数、booster参数以及学习目标参数
- General parameters:参数控制在提升(boosting)过程中使用哪种booster,常用的booster有树模型(tree)和线性模型(linear model)。
- Booster parameters:这取决于使用哪种booster。
- Learning Task parameters:控制学习的场景,例如在回归问题中会使用不同的参数控制排序。
- 除了以上参数还可能有其它参数,在命令行中使用
General Parameters
- booster [default=gbtree]
- 有两中模型可以选择gbtree和gblinear。gbtree使用基于树的模型进行提升计算,gblinear使用线性模型进行提升计算。
缺省值为gbtree
- 有两中模型可以选择gbtree和gblinear。gbtree使用基于树的模型进行提升计算,gblinear使用线性模型进行提升计算。
- silent [default=0]
- 取0时表示打印出运行时信息,取1时表示以缄默方式运行,不打印运行时信息。
缺省值为0 - 建议取0,过程中的输出数据有助于理解模型以及调参。另外实际上我设置其为1也通常无法缄默运行。。
- 取0时表示打印出运行时信息,取1时表示以缄默方式运行,不打印运行时信息。
- nthread [default to maximum number of threads available if not set]
- XGBoost运行时的线程数。
缺省值是当前系统可以获得的最大线程数 - 如果你希望以最大速度运行,建议不设置这个参数,模型将自动获得最大线程
- XGBoost运行时的线程数。
- num_pbuffer [set automatically by xgboost, no need to be set by user]
- size of prediction buffer, normally set to number of training instances. The buffers are used to save the prediction results of last boosting step.
- num_feature [set automatically by xgboost, no need to be set by user]
- boosting过程中用到的特征维数,设置为特征个数。
XGBoost会自动设置,不需要手工设置
- boosting过程中用到的特征维数,设置为特征个数。
booster parameters
From xgboost-unity, the bst: prefix is no longer needed for booster parameters. Parameter with or without bst: prefix will be equivalent(i.e. both bst:eta and eta will be valid parameter setting) .\
Parameter for Tree Booster
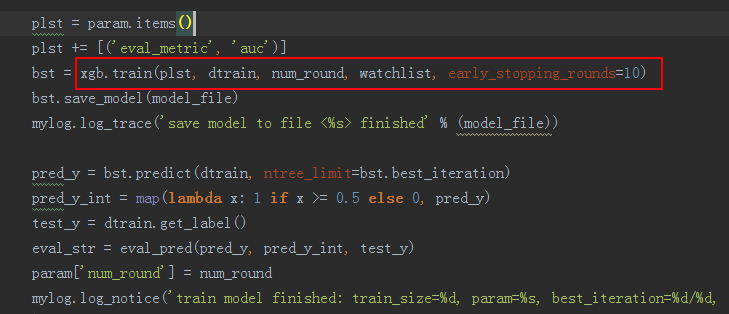
train_param : {'num_round': 600, 'colsample_bytree': 0.5, 'subsample': 1, 'eta': 0.1, 'objective': 'binary:logistic', 'max_depth': 3, 'eval_metric': 'auc'}
- eta [default=0.3]
- 为了防止过拟合,更新过程中用到的收缩步长。在每次提升计算之后,算法会直接获得新特征的权重。 eta通过缩减特征的权重使提升计算过程更加保守。
缺省值为0.3 - 取值范围为:[0,1]
- 通常最后设置eta为0.01~0.2
- 为了防止过拟合,更新过程中用到的收缩步长。在每次提升计算之后,算法会直接获得新特征的权重。 eta通过缩减特征的权重使提升计算过程更加保守。
- gamma [default=0]
- minimum loss reduction required to make a further partition on a leaf node of the tree. the larger, the more conservative the algorithm will be.
- range: [0,∞]
- 模型在默认情况下,对于一个节点的划分只有在其loss function 得到结果大于0的情况下才进行,而gamma 给定了所需的最低loss function的值
- gamma值是的算法更conservation,且其值依赖于loss function ,在模型中应该进行调参。
- max_depth [default=6]
- 数的最大深度。
缺省值为6 - 取值范围为:[1,∞]
- 指树的最大深度
- 树的深度越大,则对数据的拟合程度越高(过拟合程度也越高)。
- 建议通过交叉验证(xgb.cv ) 进行调参
- 通常取值:3-10
- 数的最大深度。
- min_child_weight [default=1]
- 孩子节点中最小的样本权重和。如果一个叶子节点的样本权重和小于min_child_weight则拆分过程结束。在现行回归模型中,这个参数是指建立每个模型所需要的最小样本数。该成熟越大算法越conservative。即调大这个参数能够控制过拟合。
- 取值范围为: [0,∞]
- max_delta_step [default=0]
- Maximum delta step we allow each tree’s weight estimation to be. If the value is set to 0, it means there is no constraint. If it is set to a positive value, it can help making the update step more conservative. Usually this parameter is not needed, but it might help in logistic regression when class is extremely imbalanced. Set it to value of 1-10 might help control the update
- 取值范围为:[0,∞]
- 如果取值为0,那么意味着无限制。如果取为正数,则其使得xgboost更新过程更加缓慢保守。
- 通常不需要设置这个值,但在使用logistics 回归时,若类别极度不平衡,则调整该参数可能有效果
- subsample [default=1]
- 用于训练模型的子样本占整个样本集合的比例。如果设置为0.5则意味着XGBoost将随机的冲整个样本集合中随机的抽取出50%的子样本建立树模型,这能够防止过拟合。
- 取值范围为:(0,1]
- colsample_bytree [default=1]
- 在建立树时对特征随机采样的比例。
缺省值为1 - 取值范围:(0,1]
- 在建立树时对特征随机采样的比例。
- colsample_bylevel[default=1]
- 决定每次节点划分时子样例的比例
- 通常不使用,因为subsample和colsample_bytree已经可以起到相同的作用了
- scale_pos_weight[default=0]
- A value greater than 0 can be used in case of high class imbalance as it helps in faster convergence.
- 大于0的取值可以处理类别不平衡的情况。帮助模型更快收敛
Parameter for Linear Booster
- lambda [default=0]
- L2 正则的惩罚系数
- 用于处理XGBoost的正则化部分。通常不使用,但可以用来降低过拟合
- alpha [default=0]
- L1 正则的惩罚系数
- 当数据维度极高时可以使用,使得算法运行更快。
- lambda_bias
- 在偏置上的L2正则。
缺省值为0(在L1上没有偏置项的正则,因为L1时偏置不重要)
- 在偏置上的L2正则。
Task Parameters
- objective [ default=reg:linear ]
- 定义学习任务及相应的学习目标,可选的目标函数如下:
- “reg:linear” –线性回归。
- “reg:logistic” –逻辑回归。
- “binary:logistic” –二分类的逻辑回归问题,输出为概率。
- “binary:logitraw” –二分类的逻辑回归问题,输出的结果为wTx。
- “count:poisson” –计数问题的poisson回归,输出结果为poisson分布。
- 在poisson回归中,max_delta_step的缺省值为0.7。(used to safeguard optimization)
- “multi:softmax” –让XGBoost采用softmax目标函数处理多分类问题,同时需要设置参数num_class(类别个数)
- “multi:softprob” –和softmax一样,但是输出的是ndata * nclass的向量,可以将该向量reshape成ndata行nclass列的矩阵。没行数据表示样本所属于每个类别的概率。
- “rank:pairwise” –set XGBoost to do ranking task by minimizing the pairwise loss
- base_score [ default=0.5 ]
- the initial prediction score of all instances, global bias
- eval_metric [ default according to objective ]
- 校验数据所需要的评价指标,不同的目标函数将会有缺省的评价指标(rmse for regression, and error for classification, mean average precision for ranking)
- 用户可以添加多种评价指标,对于Python用户要以list传递参数对给程序,而不是map参数list参数不会覆盖’eval_metric’
- The choices are listed below:
- “rmse”: root mean square error
- “logloss”: negative log-likelihood
- “error”: Binary classification error rate. It is calculated as #(wrong cases)/#(all cases). For the predictions, the evaluation will regard the instances with prediction value larger than 0.5 as positive instances, and the others as negative instances.
- “merror”: Multiclass classification error rate. It is calculated as #(wrong cases)/#(all cases).
- “mlogloss”: Multiclass logloss
- “auc”: Area under the curve for ranking evaluation.
- “ndcg”:Normalized Discounted Cumulative Gain
- “map”:Mean average precision
- “ndcg@n”,”map@n”: n can be assigned as an integer to cut off the top positions in the lists for evaluation.
- “ndcg-“,”map-“,”ndcg@n-“,”map@n-“: In XGBoost, NDCG and MAP will evaluate the score of a list without any positive samples as 1. By adding “-” in the evaluation metric XGBoost will evaluate these score as 0 to be consistent under some conditions.
training repeatively
- seed [ default=0 ]
- 随机数的种子。
缺省值为0 - 可以用于产生可重复的结果(每次取一样的seed即可得到相同的随机划分)
- 随机数的种子。
Console Parameters
The following parameters are only used in the console version of xgboost
* use_buffer [ default=1 ]
- 是否为输入创建二进制的缓存文件,缓存文件可以加速计算。缺省值为1
* num_round
- boosting迭代计算次数。
* data
- 输入数据的路径
* test:data
- 测试数据的路径
* save_period [default=0]
- 表示保存第i*save_period次迭代的模型。例如save_period=10表示每隔10迭代计算XGBoost将会保存中间结果,设置为0表示每次计算的模型都要保持。
* task [default=train] options: train, pred, eval, dump
- train:训练明显
- pred:对测试数据进行预测
- eval:通过eval[name]=filenam定义评价指标
- dump:将学习模型保存成文本格式
* model_in [default=NULL]
- 指向模型的路径在test, eval, dump都会用到,如果在training中定义XGBoost将会接着输入模型继续训练
* model_out [default=NULL]
- 训练完成后模型的保持路径,如果没有定义则会输出类似0003.model这样的结果,0003是第三次训练的模型结果。
* model_dir [default=models]
- 输出模型所保存的路径。
* fmap
- feature map, used for dump model
* name_dump [default=dump.txt]
- name of model dump file
* name_pred [default=pred.txt]
- 预测结果文件
* pred_margin [default=0]
- 输出预测的边界,而不是转换后的概率
如果比较习惯scikit-learn的参数形式,xgboost的Python 版本也提供了sklearn形式的接口 xgbclassifier。它使用sklearn形式的参数命名方式,对应关系如下:
eta –> learning_rate
lambda –> reg_lambda
alpha –> reg_alpha
xgboost-python参数深入理解的更多相关文章
- python 参数类型理解
简介 大家都知道,在java中,函数或者方法的参数在调用时必须对其进行传参操作,也就是所谓的必选参数,也可以称为位置参数,除此之外,python还拥有其他语言不具有的一些参数类型,以下将进行一一介绍. ...
- XGBoost中参数调整的完整指南(包含Python中的代码)
(搬运)XGBoost中参数调整的完整指南(包含Python中的代码) AARSHAY JAIN, 2016年3月1日 介绍 如果事情不适合预测建模,请使用XGboost.XGBoost算法已 ...
- python 参数定义库argparse
python 参数定义库argparse 这一块的官方文档在这里 注意到这个库是因为argparse在IDE中和在ipython notebook中使用是有差异的,习惯了再IDE里面用,转到ipyth ...
- python之总体理解
作为脚本,python具备了弱类型语言的灵活性,便捷性.这在日常的开发使用中能够大幅度的减轻开发人员的编码负担,开发者也能够将精力集中在程序的逻辑管理和总体构架设计上.一般而言,随着经验的积累,开发人 ...
- Python参数笔记
Python参数 1. 普通参数 必须要传入和定义时个数相同的参数 def miao(acfun, bilibili): print(acfun, bilibili) miao(11, 22) > ...
- mtime参数的理解
mtime参数的理解应该如下:-mtime n 按照文件的更改时间来找文件,n为整数.n表示文件更改时间距离为n天, -n表示文件更改时间距离在n天以内,+n表示文件更改时间距离在n天以前.例如:-m ...
- Python的多线程理解,转自虫师https://www.cnblogs.com/fnng/p/3670789.html
多线程和多进程是什么自行google补脑 对于python 多线程的理解,我花了很长时间,搜索的大部份文章都不够通俗易懂.所以,这里力图用简单的例子,让你对多线程有个初步的认识. 单线程 在好些年前的 ...
- Python参数基础
Python参数基础 位置参数 通过位置进行匹配,把参数值传递给函数头部的参数名称,顺序从左到右 关键字参数 调用的时候使用参数的变量名,采用name=value的形式 默认参数 为没有传 ...
- ArcEngine中IFeatureClass.Search(filter, Recycling)方法中Recycling参数的理解
转自 ArcEngine中IFeatureClass.Search(filter, Recycling)方法中Recycling参数的理解 ArcGIS Engine中总调用IFeatureCla ...
随机推荐
- web前端 兼容性问题
1:position属性使用过多或使用位置不恰当引起滚动时页面错乱 浏览器环境:ie7 position:relative; 网页上最直接表现就是极具破坏性的滚动错位,问题产生来自ie7自身渲染解析出 ...
- redis的删除库应用(linux)
1.首先从linux进入redis的安装目录下 2.用redis-cli在Shell命令行下启动Redis客户端工具. 3.select 库名 进入到库下 4.flushdb 刷新当前库 redis的 ...
- JAVA函数的重载
一.什么是重载(overlording) 在JAVA中,可以在同一个类中存在多个函数,函数名称相同但参数列表不同.这就是函数的重载(overlording).这是类的多太性表现之一. 二.重载的特征: ...
- .Net程序员学用Oracle系列(16):访问数据库(ODP.NET)
1..Net for Oracle 常见数据库驱动 1.1.微软提供的驱动 1.2.甲骨文提供的驱动 1.3.其它厂商提供的驱动 2.ODP.NET 常见问题分析 2.1.参数化问题 2.2.方法调用 ...
- PAT乙级 1065. 单身狗(25) by Python
1065. 单身狗(25) 时间限制 300 ms 内存限制 65536 kB 代码长度限制 8000 B 判题程序 Standard 作者 CHEN, Yue "单身狗"是中文对 ...
- 负笈前行--DPDK代码风格
每个公司都会有自己代码风格或者编程规范,都旨在防范编程语言的一些陷阱或者提高代码效率,还有就是保持一致编码风格来提高代码可读性,方便code review: 或者说代码的一种美学,比如python也就 ...
- java读取Excel文档插入mysql
/** * 读取excel插入myslq */package com.excel; import java.io.BufferedInputStream;import java.io.File;imp ...
- java程序员--小心你代码中的内存泄漏
当你从c&c++转到一门具有垃圾回收功能的语言时,程序员的工作就会变得更加容易,因为你用完对象,他们会被自动回收,但是,java程序员真的不需要考虑内存泄露吗? 其实不然 1.举个例子-看你能 ...
- 一张图理解RACSignal的Subscription过程
通过下面一张图理解RACSignal的调用过程: 创建signale RACSignal通过子类[RACDynamicSignal createSignal:]方法获得Signal,并将disSubs ...
- 从CMOS到触发器(二)
PS:可以转载,转载请标明出处:http://www.cnblogs.com/IClearner/ 前面说了CMOS器件,现在就接着来聊聊锁存器跟触发器吧,下面是这次博文要介绍的主要内容: ·双稳态器 ...