
Matplotlib学习---用wordcloud画词云(Word Cloud)
画词云首先需要安装wordcloud(生成词云)和jieba(中文分词)。
先来说说wordcloud的安装吧,真是一波三折。首先用pip install wordcloud出现错误,说需要安装Visual C++ 14.0。折腾半天安装好Visual C++后,还是不行,按网上指点,下载第三方包安装(https://www.lfd.uci.edu/~gohlke/pythonlibs/#wordcloud)。安装是成功了,可是在anaconda里导入的时候又出现了问题,说是"no module named wordcloud"。随后又折腾了各种方案,比如网上有人说重新安装pillow包,等等,均不可行。突发奇想,打开Pycharm试了试,导入成功了。这说明wordcloud包其实已经安装好了,只是anaconda不识别。最后,终于找到解决方案:在anaconda prompt里输入命令:conda install -c conda-forge wordcloud,即可安装成功(https://anaconda.org/conda-forge/wordcloud)。
再来看一下wordcloud的基本原理(摘自:http://www.bubuko.com/infodetail-2695943.html):
总的来说,wordcloud做的是三件事:
(1) 文本预处理
(2) 词频统计
(3) 将高频词以图片形式进行彩色渲染
下面用vanity fair这本小说来试一下画词云图。(wordcloud的一些参数介绍可参见:https://www.cnblogs.com/delav/articles/7837975.html)
from wordcloud import WordCloud, STOPWORDS

from matplotlib import pyplot as plt

fig,ax=plt.subplots()

with open(r'...\vanity fair.txt') as f:

    text=f.read()

mycloudword=WordCloud(width=800,

                      height=600,

                      scale=1,

                      margin=2,

                      background_color='white',

                      max_words=200,

                      min_font_size=40,

                      max_font_size=140,

                      stopwords=STOPWORDS,

                      random_state=50).generate(text)

ax.imshow(mycloudword)

ax.axis("off")

plt.show()

mycloudword.to_file(r"...\vanityfair.png")
输出:

注:设置不同的random_state值会让字的分布不一样。
上面演示的是用英文做的词云,那么如果我们要用中文生成词云呢?这时候就要用到jieba了。
英文语料可以直接输入到wordcloud中,但是对于中文语料,仅仅用wordcloud不能直接生成中文词云图。这是因为英文单词以空格分隔,而中文的词与词之间一般没有字符分隔。因此,应用到中文语料上的时候,注意要先分好词,再用空格分隔连接成字符串,最后输入到wordcloud。
另外需要注意的是:需要下载中文字体到相应的文件夹,设置该字体路径为font_path。否则,如果设置的是英文字体,那么中文将显示为方框。
让我们用翻译版的名利场小说来做演示:
from wordcloud import WordCloud, STOPWORDS

import jieba

from matplotlib import pyplot as plt

fig,ax=plt.subplots()

with open(r'...\名利场.txt','rb') as f:

    text=f.read()

wsplit=jieba.cut(text)

words="".join(wsplit)

mycloudword=WordCloud(font_path=r'C:\Windows\Fonts\msyh.ttf',

                      width=800,

                      height=600,

                      scale=1,

                      margin=2,

                      background_color='white',

                      max_words=200,

                      min_font_size=40,

                      max_font_size=140,

                      stopwords=STOPWORDS,

                      random_state=50).generate(words)

ax.imshow(mycloudword)

ax.axis("off")

plt.show()

mycloudword.to_file(r"...\vanityfair1.png")
输出:
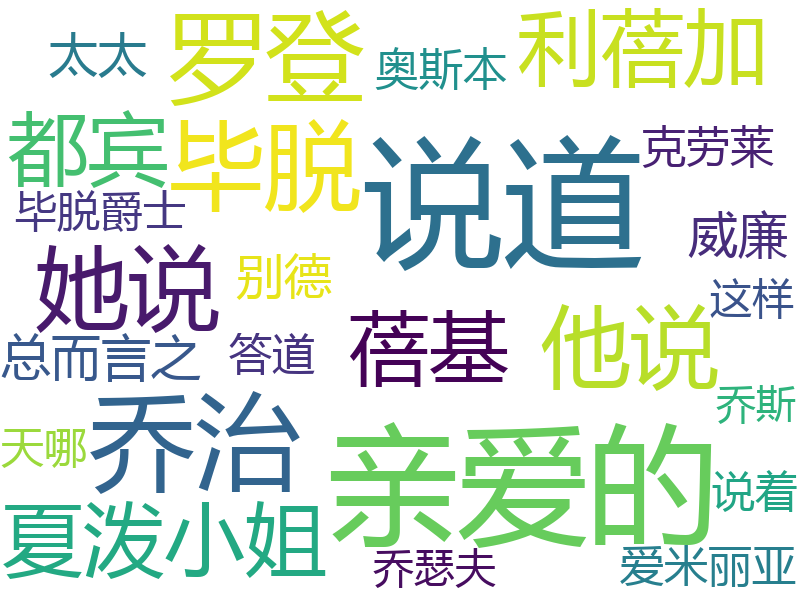
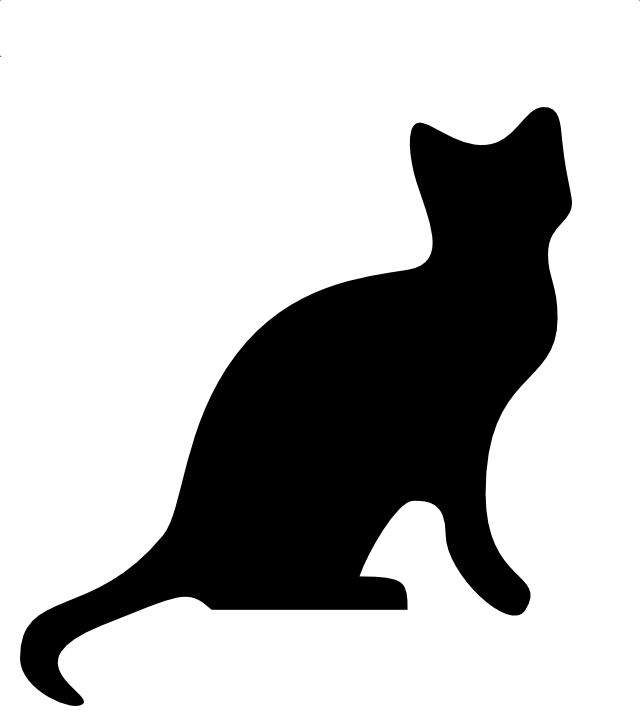
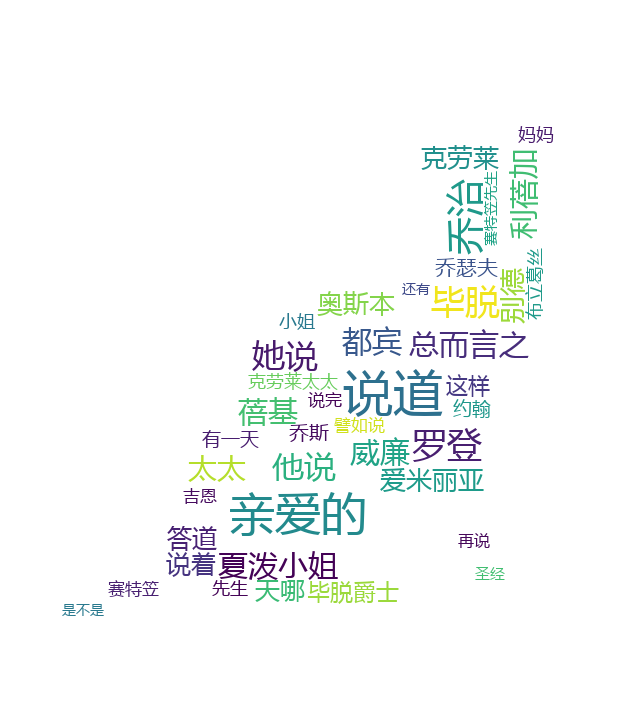
接下来,我们把词云做成我们想要的形状。用pillow读取某张图片,转换成numpy array格式,并将其设置为mask(遮罩)。除图片全白的部分将不会被绘制,其余部分会用于绘制词云。
from wordcloud import WordCloud, STOPWORDS

import jieba

from PIL import Image

import numpy as np

from matplotlib import pyplot as plt

fig,ax=plt.subplots()

with open(r'...\名利场.txt','rb') as f:

    text=f.read()

wsplit=jieba.cut(text)

words="".join(wsplit)

shape=np.array(Image.open(r'C:\Users\ccav\timg.jpg'))

mycloudword=WordCloud(font_path=r'C:\Windows\Fonts\msyh.ttf',

                      scale=1,

                      margin=2,

                      background_color='white',

                      mask=shape,

                      max_words=200,

                      min_font_size=14,

                      max_font_size=50,

                      stopwords=STOPWORDS,

                      random_state=50).generate(words)

ax.imshow(mycloudword)

ax.axis("off")

plt.show()

mycloudword.to_file(r"...\vanityfair2.png")
原图:
输出的词云:
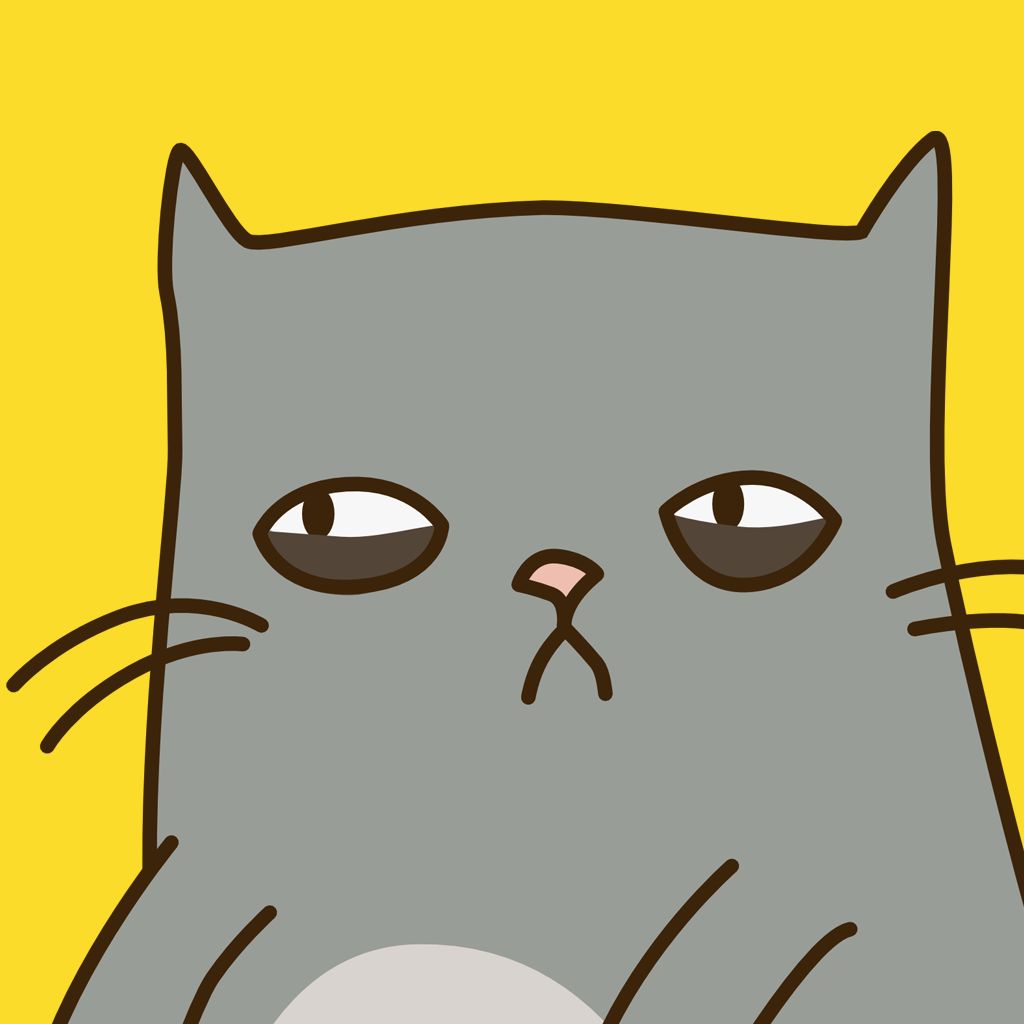
此外,还可以让词按某个图片的颜色进行显示。用recolor([random_state, color_func, colormap])对现有输出重新着色。(重新上色比重新生成整个词云要快很多)
添加以下这几句即可:
from wordcloud import ImageColorGenerator

color=ImageColorGenerator(np.array(Image.open(r'...\timg2.jpg')))

mycloudword.recolor(color_func=color)
原图:
输出:

Matplotlib学习---用wordcloud画词云(Word Cloud)的更多相关文章
- 推荐一个免费的生成词云(word cloud)的在线工具
"词云"这个概念由美国西北大学新闻学副教授.新媒体专业主任里奇·戈登(Rich Gordon)提出. "词云"就是对网络文本中出现频率较高的"关键词& ...
- 用Python和WordCloud绘制词云(内附让字体清晰的秘笈)
环境及模块: Win7 64位 Python 3.6.4 WordCloud 1.5.0 Pillow 5.0.0 Jieba 0.39 目标: 绘制安徽省2018年某些科技项目的词云,直观展示热点. ...
- jieba (中文词频统计) 、collections (字频统计)、WordCloud (词云)
py库: jieba (中文词频统计) .collections (字频统计).WordCloud (词云) 先来个最简单的: # 查找列表中出现次数最多的值 ls = [1, 2, 3, 4, 5, ...
- 更新几篇之前写在公众号上的文章:线性可分时SVM理论推导;关联分析做捆绑销售和推荐;分词、去停用词和画词云
适合阅读人群:有一定的数学基础. 这几篇文章是16年写的,之前发布在个人公众号上,公众号现已弃用.回过头来再看这几篇文章,发现写的过于稚嫩,思考也不全面,这说明我又进步了,但还是作为学习笔记记在这里了 ...
- R系列:分词、去停用词、画词云(词云形状可自定义)
附注:不要问我为什么写这么快,是16年写的. R的优点:免费.界面友好(个人认为没有matlab友好,matlab在我心中就是统计软件中极简主义的代表).小(压缩包就几十M,MATLAB.R2009b ...
- Python第三方库wordcloud(词云)快速入门与进阶
前言: 笔主开发环境:Python3+Windows 推荐初学者使用Anaconda来搭建Python环境,这样很方便而且能提高学习速度与效率. 简介: wordcloud是Python中的一个小巧的 ...
- python使用matplotlib画图,jieba分词、词云、selenuium、图片、音频、视频、文字识别、人脸识别
一.使用matplotlib画图 关注公众号"轻松学编程"了解更多. 使用matplotlib画柱形图 import matplotlib from matplotlib impo ...
- py库: jieba (中文词频统计) 、collections (字频统计)、WordCloud (词云)
先来个最简单的: # 查找列表中出现次数最多的值 ls = [1, 2, 3, 4, 5, 6, 1, 2, 1, 2, 1, 1] ls = ["呵呵", "呵呵&qu ...
- python WordCloud 实现词云
简单示例 from matplotlib import pyplot as plt from wordcloud import WordCloud filename = "text.txt& ...
随机推荐
- 常用yum操作命令
1.yum repolist 获取当前系统有效的repolist,如下图 2.yum list,列出所有可安装的软件包 获取当前有效repolist中所能安装的所有rpm包列表,(很长,慎重),可以结 ...
- Python学习第三篇——访问列表部分元素
dongman =["huoying","sishen","si wang bi ji","pan ni de lu lu xiu ...
- iOS NSDictionary JSON 相互转换
/*! * @brief 把格式化的JSON格式的字符串转换成字典 * @param jsonString JSON格式的字符串 * @return 返回字典 */ + (NSDictionary * ...
- p86商空间也是Banach空间
1.为什么要引入Zk? 2.为什么这个等式成立,和为什么要引入uk? 3.为什么为什么等于0? 属于M,则商空间是0元,p128最上面的第二个笔记
- mysql备份(导出)数据库,并恢复数据
导出某个数据库数据到文件中 假设要导出test这个数据库,那么可以在Linux命令行(不是在mysql中) [root@ubuntu /data]# mysqldump -uroot -p test ...
- 【学习总结】C-翁恺老师-入门-第0周<程序设计与C>
[学习总结]C-翁恺老师-入门-总 1-首先按视频说的下载编辑器 <DevC++> 并一路默认设置: 安装包下载链接 (我有vc6.0不过预感告诉我老师要用类似CS50里那种命令行编辑器? ...
- 数据处理 array json 格式 转换成 数组形式
处理这种数据应该使用的方式是 this.cities= res.data.data.cities.sort((a,b)=>{ //排序 进行字母排序 return a.pinyin[0].cha ...
- Java 找不到或者无法加载主类
1 测试Test 类的时候突然遇到一个很奇怪的问题,网上搜了很多资料才找到解决办法,大多数情况是因为类加了包名编译,执行的时候没有到包下去执行.与我遇到的情况不一样. 问题:写了一个测试类Test,在 ...
- 剑指offer(17)层次遍历树
题目: 从上往下打印出二叉树的每个节点,同层节点从左至右打印. public class Solution { ArrayList<Integer> list = new ArrayLis ...
- Vue 中提示报错 handlers[i].call is not a function解决方法
Vue 中提示警告 TypeError: handlers[i].call is not a function at callHook (vue.esm.js?a026:2921) at Object ...