
爬虫基础02-day24
写在前面
干就完了
 s16/17爬虫2

 内容回顾:

     1. Http协议

         Http协议:GET / http1.1/r/n...../r/r/r/na=1

          TCP协议:sendall("GET / http1.1/r/n...../r/r/r/na=1")

     2. 请求体

          GET: GET / http1.1/r/n...../r/r/r/n

         POST:

               POST / http1.1/r/n...../r/r/r/na=1&b=2

               POST / http1.1/r/n...../r/r/r/{"k1":123}

               PS: 依据Content-Type请求头

     3. requests模块

         - method

         - url

         - params

         - data

         - json

         - headers

         - cookies

         - proxies

     4. BeautifulSoup4模块

         HTML

         XML

     5. Web微信

         - 轮训

         - 长轮训

 今日内容概要:

     1. Web微信

     2. 高性能相关

     3. Scrapy

 内容详细:

     1. Web微信

         - 防盗链

             - headers

             - cookies

         - 检测请求

             - url

         - Session中:

             - qcode

             - ctime

             - login_cookie_dict

             - ticket_dict_cookie

             - ticket_dict

             - init_cookie_dict

         - 收发消息

     2. 高性能相关

         基本原理:

             IO多路复用:select,用于检测socket对象是否发生变化(是否连接成功,是否有数据到来)

                 Socket:socket客户端

             import socket

             import select

             class Request(object):

                 def __init__(self,sock,func,url):

                     self.sock = sock

                     self.func = func

                     self.url = url

                 def fileno(self):

                     return self.sock.fileno()

             def async_request(url_list):

                 input_list = []

                 conn_list = []

                 for url in url_list:

                     client = socket.socket()

                     client.setblocking(False)

                     # 创建连接,不阻塞

                     try:

                         client.connect((url[0],80,)) # 100个向百度发送的请求

                     except BlockingIOError as e:

                         pass

                     obj = Request(client,url[1],url[0])

                     input_list.append(obj)

                     conn_list.append(obj)

                 while True:

                     # 监听socket是否已经发生变化 [request_obj,request_obj....request_obj]

                     # 如果有请求连接成功:wlist = [request_obj,request_obj]

                     # 如果有响应的数据:  rlist = [request_obj,request_obj....client100]

                     rlist,wlist,elist = select.select(input_list,conn_list,[],0.05)

                     for request_obj in wlist:

                         # print('连接成功')

                         # # # # 发送Http请求

                         # print('发送请求')

                         request_obj.sock.sendall("GET / HTTP/1.0\r\nhost:{0}\r\n\r\n".format(request_obj.url).encode('utf-8'))

                         conn_list.remove(request_obj)

                     for request_obj in rlist:

                         data = request_obj.sock.recv(8096)

                         request_obj.func(data)

                         request_obj.sock.close()

                         input_list.remove(request_obj)

                     if not input_list:

                         break

         使用一个线程完成并发操作,如何并发?

         当第一个任务到来时,先发送连接请求,此时会发生IO等待,但是我不等待,我继续发送第二个任务的连接请求....

         IO多路复用监听socket变化

         先连接成功:

             发送请求信息: GET / http/1.0\r\nhost....

             遇到IO等待,不等待,继续检测是否有人连接成功:

             发送请求信息: GET / http/1.0\r\nhost....

             遇到IO等待,不等待,继续检测是否有人连接成功:

             发送请求信息: GET / http/1.0\r\nhost....

         有结果返回:

             读取返回内容,执行回调函数

             读取返回内容,执行回调函数

             读取返回内容,执行回调函数

             读取返回内容,执行回调函数

             读取返回内容,执行回调函数

             读取返回内容,执行回调函数

             读取返回内容,执行回调函数

         问题:什么是协程?

               单纯的执行一端代码后,调到另外一端代码执行,再继续跳...

         异步IO:

              - 【基于协程】可以用 协程+非阻塞socket+select实现,gevent

              - 【基于事件循环】完全通用socket+select实现,Twsited

         1. 如何提高爬虫并发?

             利用异步IO模块,如:asyncio,twisted,gevent

             本质:

                 - 【基于协程】可以用 协程+非阻塞socket+select实现,gevent

                 - 【基于事件循环】完全通用socket+select实现,Twsited,tornado

         2. 异步非阻塞

               异步:回调   select

             非阻塞:不等待 setblocking(False)

         3. 什么是协程?

             pip3 install gevent

             from greenlet import greenlet

             def test1():

                 print(12)

                 gr2.switch()

                 print(34)

                 gr2.switch()

             def test2():

                 print(56)

                 gr1.switch()

                 print(78)

             gr1 = greenlet(test1)

             gr2 = greenlet(test2)

             gr1.switch()

     3. 爬虫

         - request+bs4+twisted或gevent或asyncio

         - scrapy框架

             - twisted

             - 自己html解析

             - 限速

             - 去重

             - 递归,找4层

             - 代理

             - https

             - 中间件

             ....

         - 安装scrapy

             依赖Twisted

         - 开始写爬虫

             执行命令:

                  scrapy startproject sp1

                  sp1

                     - sp1

                         - spiders      爬虫

                             - xx.py

                             - chouti.py

                         - middlewares  中间件

                         - pipelines    持久化

                         - items        规则化

                         - settings     配置

                     - scrapy.cfg

                 cd sp1

                 scrapy genspider xx xx.com

                 scrapy genspider chouti chouti.com

         - scrapy crawl chouti

             name

             allow_domains

             start_urls

             parse(self,response)

                 yield Item

                 yield Request(url,callback)

 本周任务:

     1. Web微信

     2. 高性能示例保存

     3.

         - 煎蛋

         - 拉钩

         - 知乎

         - 抽屉
武Sir - 笔记
before

	Web微信

	高性能

	scrapy

requests.post(data=xxx)   ->   Form Data

requests.post(json=xxx)   ->   Request Payload

HttpResponse()  参数可以是字符串也可以是字节

response.text         字符串

response.content 	  字节

# 获取最近联系人然后进行初始化

# 获取头像

# 拿联系人列表

response = requests.get(url,cookies=xxx)

response.encoding = 'utf-8'

print(json.loads(response.text))

Web微信总结

	- 头像防盗链

		- headers

		- cookies

	- 检测请求:

		- tip | pass_ticket | ...

		- redirect_url和真实请求的url是否一致

	- session 保存关键点的cookies和关键变量值

		- qrcode 和 ctime

		- login_cookie_dict

		- ticket_dict_cookie

		- ticket_dict

		- init_cookie_dict

		- init_dict

		- all_cookies = {}

		- all_cookies.update(...)

json序列化的时候是可以加参数的:

data = {

	'name':'alex',

	'msg':'中文asa'

}

import json

print(json.dumps(data))

按Unicode显示

print(json.dumps(data,ensure_ascii=False))

按中文显示

json.dumps() 之后是字符串

requests.post() 默认是按照 latin-1 编码,不支持中文

所以改成直接发bytes:

requests.post(data=json.dumps(data,ensure_ascii=False).encode('utf-8'))

发送消息需带上cookies

发送消息

检测是否有新消息到来

接收消息

#########################

高性能相关

100张图片,下载

使用一个线程完成并发操作

是配合IO多路复用完成的

爬虫:

	- 简单的爬虫

		- requests+bs4+twsited+asyncio

	- scrapy框架

		- 下载页面:twsited

		- 解析页面:自己的HTML解析

		- 可限速

		- 去重

		- 递归 一层一层的爬,成倍速的增长,还可以限制层数

		- 代理

		- https

		- 中间件

		...

scrapy

	- scrapy startproject sp1

	- cd sp1

	- scrapy genspider baidu baidu.com

	- scrapy genspider chouti chouti.com

	- scrapy crawl chouti --nolog

	- name

	- allow_dimains

	- start_urls

	- parse(self,response)

		- yield Item   持久化

		- yield Request(url,callback)  把url放到调度器队列里

本周作业:

1.Web微信

	自己去写,写完跟老师的对比

2.高性能总结文档(源码示例+文字理解)

3.任意找一个网站,用Scrapy去爬

	- 煎蛋

	- 拉钩

	- 知乎

	- 抽屉

	- ...

不遵循爬虫规范:

ROBOTSTXT_OBEY = False

可能会失败:没有带请求头

起始url如何携带指定请求头?

自定义start_requests(self)
一、Web微信
获取最近联系人列表并初始化:
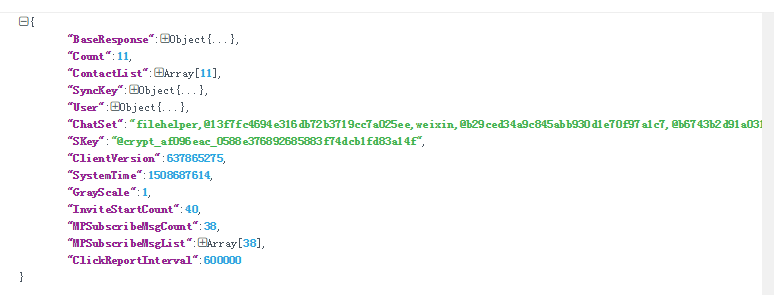
获取联系人列表:
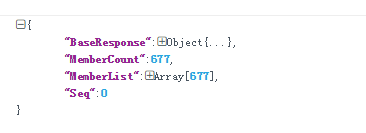
代码实现见另一片博客:Web微信
二、高性能编程示例
参考:http://www.cnblogs.com/wupeiqi/articles/6229292.html
代码示例见另一篇那博客:Python高性能编程
三、Scrapy框架初探
参考:http://www.cnblogs.com/wupeiqi/articles/5354900.html
代码示例参见博客:Scrapy基础01 Scrapy基础02
爬虫基础02-day24的更多相关文章
- 【网络爬虫入门02】HTTP客户端库Requests的基本原理与基础应用
[网络爬虫入门02]HTTP客户端库Requests的基本原理与基础应用 广东职业技术学院 欧浩源 1.引言 实现网络爬虫的第一步就是要建立网络连接并向服务器或网页等网络资源发起请求.urllib是 ...
- javascript基础02
javascript基础02 1.数据类型 数据类型的描述在上篇的扩展中有写到链接 由于ECMAScript数据类型具有动态性,因此的确没有再定义其他数据类型的必要.这句话很重要. 如果以后再数据类型 ...
- javaSE基础02
javaSE基础02 一.javac命令和java命令做什么事情? javac:负责编译,当执行javac时,会启动java的编译程序,对指定扩展名的.java文件进行编译,生成了jvm可以识别的字节 ...
- java基础学习05(面向对象基础02)
面向对象基础02 实现的目标 1.String类的使用2.掌握this关键字的使用3.掌握static关键字的使用4.了解内部类 String类 实例化String对象一个字符串就是一个String类 ...
- Python爬虫基础
前言 Python非常适合用来开发网页爬虫,理由如下: 1.抓取网页本身的接口 相比与其他静态编程语言,如java,c#,c++,python抓取网页文档的接口更简洁:相比其他动态脚本语言,如perl ...
- python 3.x 爬虫基础---Urllib详解
python 3.x 爬虫基础 python 3.x 爬虫基础---http headers详解 python 3.x 爬虫基础---Urllib详解 前言 爬虫也了解了一段时间了希望在半个月的时间内 ...
- python 3.x 爬虫基础---常用第三方库(requests,BeautifulSoup4,selenium,lxml )
python 3.x 爬虫基础 python 3.x 爬虫基础---http headers详解 python 3.x 爬虫基础---Urllib详解 python 3.x 爬虫基础---常用第三方库 ...
- java网络爬虫基础学习(三)
尝试直接请求URL获取资源 豆瓣电影 https://movie.douban.com/explore#!type=movie&tag=%E7%83%AD%E9%97%A8&sort= ...
- java网络爬虫基础学习(一)
刚开始接触java爬虫,在这里是搜索网上做一些理论知识的总结 主要参考文章:gitchat 的java 网络爬虫基础入门,好像要付费,也不贵,感觉内容对新手很友好. 一.爬虫介绍 网络爬虫是一个自动提 ...
随机推荐
- Android GPS定位测试(附效果图)
今天因为工作需要,把以前编写的一个GPS测试程序拿出来重新修改了一下.这个程序说起来有些历史了,是我11年编写的,那时候学了Android开发没多久,算是一个实验性的作品.现在工作需要,重新拿出来修整 ...
- 【COGS2652】秘术「天文密葬法」(长链剖分,分数规划)
[COGS2652]秘术「天文密葬法」(长链剖分,分数规划) 题面 Cogs 上面废话真多,建议直接拉到最下面看一句话题意吧: 给个树,第i个点有两个权值ai和bi,现在求一条长度为m的路径,使得Σa ...
- CPU监控 解题报告
CPU监控 这种题就需要小黄鸭调试法,不行就重构,动态gdb可能会死人,一堆tag的... 维护历史最值的一个核心是历史最值tag,它的意义是从上一次这个点下放tag之后到当前时刻的这个点的tag达到 ...
- Billiard CFR484 div2 (数论)
就是一个点从开始的点在一个矩形内往某个方向一直运动,如果碰到了矩形的边,那么就反弹,我们可以把这个矩形拓展开,那么就是问题变成了我有没有一个点,这个点的坐标(Tx, Ty)满足n|Tx,m|Ty 那么 ...
- CodeForces - 95B(DFS)
题目链接:http://codeforces.com/problemset/problem/95/B 题目大意:给你一个正整数n (1 ≤ n ≤ 10100000),求不大小于它的超级幸运数字(超级 ...
- Ubuntu Server 18.04 网络设置不生效的解决
在Ubuntu18.04中,传统的配置/etc/network/interfaces已无用https://www.cnblogs.com/dunitian/p/6658578.html 新方法:修改 ...
- python 验证码识别
一.python识别简单验证码: 代码: ''' func:实现简单验证码获取 ''' import pytesseract from PIL import Image #首先通过Image打开一个图 ...
- yd的汇总
因为是我这只蒟蒻个人的汇总嘛,可能有些奇♂怪的东西或者不规范的语言出现啦,见谅见谅 搬了一些到知识汇总里,删了一些过时和无用的,少了好多=.= 1.STL_queue 经实践验证,!qs.empty( ...
- c# WebApi之解决跨域问题:Cors
什么是跨域问题 出于安全考虑,浏览器会限制脚本中发起的跨站请求,浏览器要求JavaScript或Cookie只能访问同域下的内容.由于这个原因,我们不同站点之间的数据访问会被拒绝. Cors解决跨域问 ...
- java 集合的总结
集合大致可以分为两类: 一类继承Collection接口,存储的是多个孤立的元素,包括List和set: List包括ArrayList类和LinkedList类,ArrayList数组的顺序存储,而 ...