
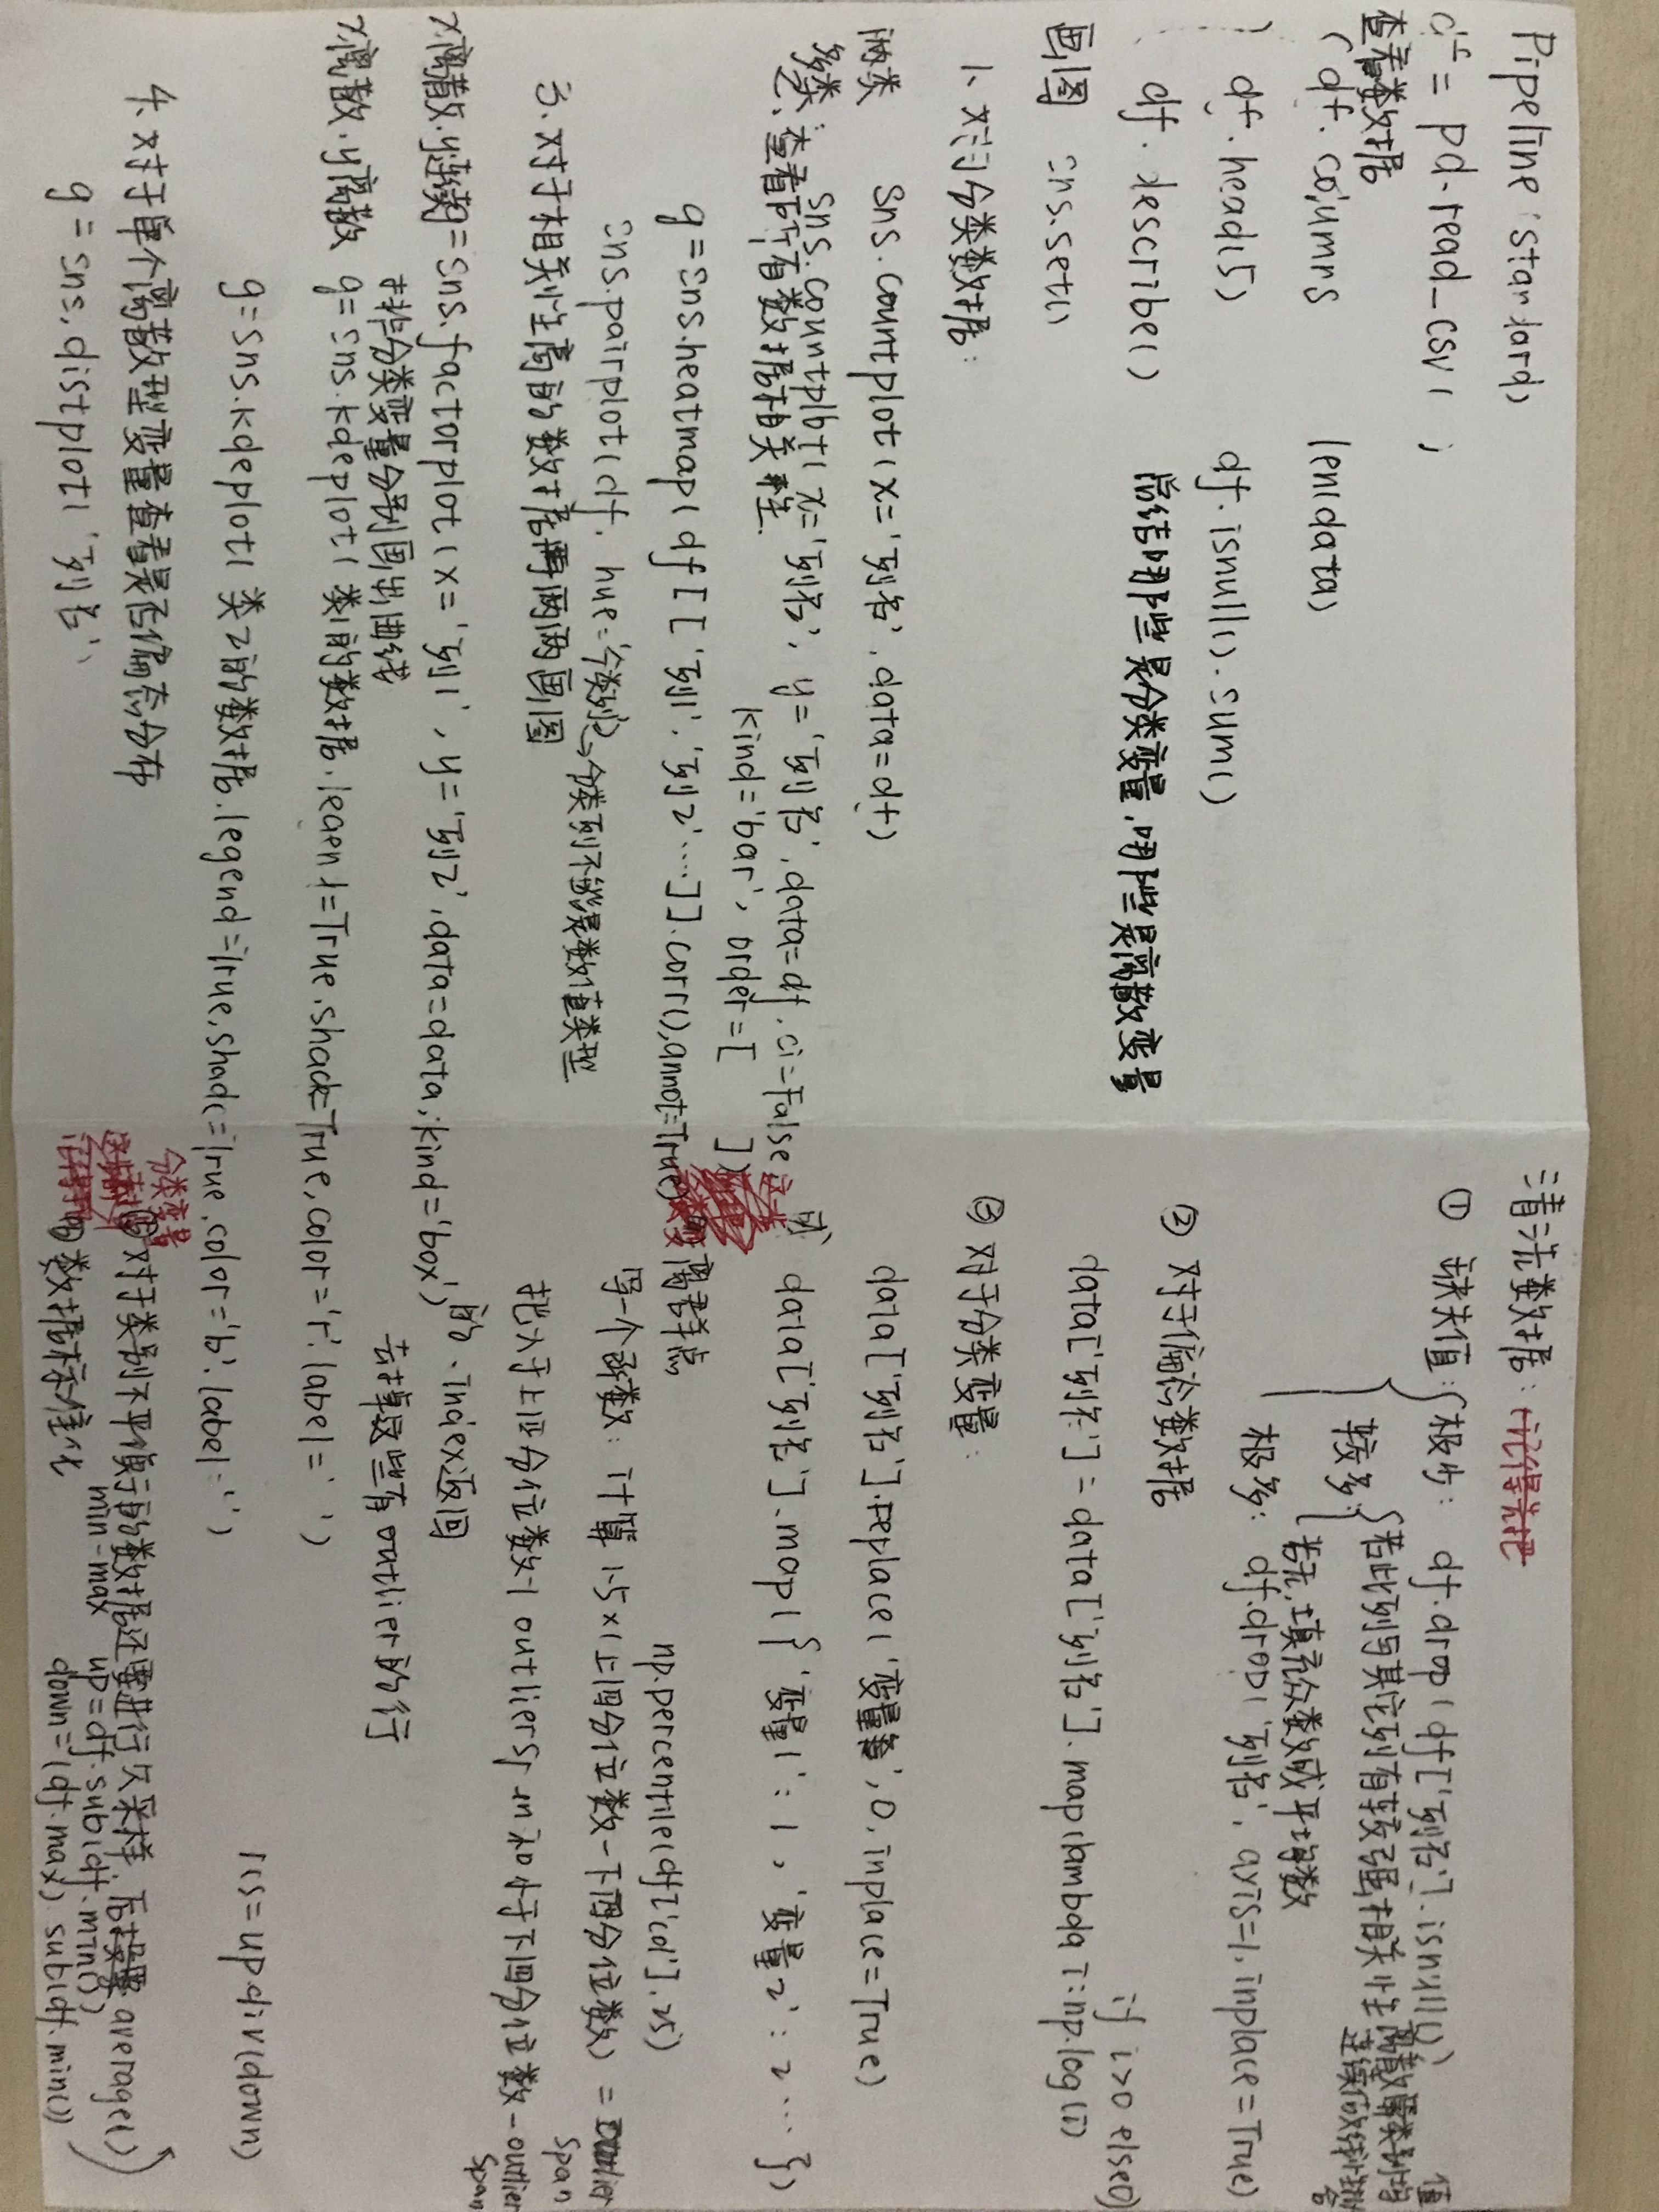
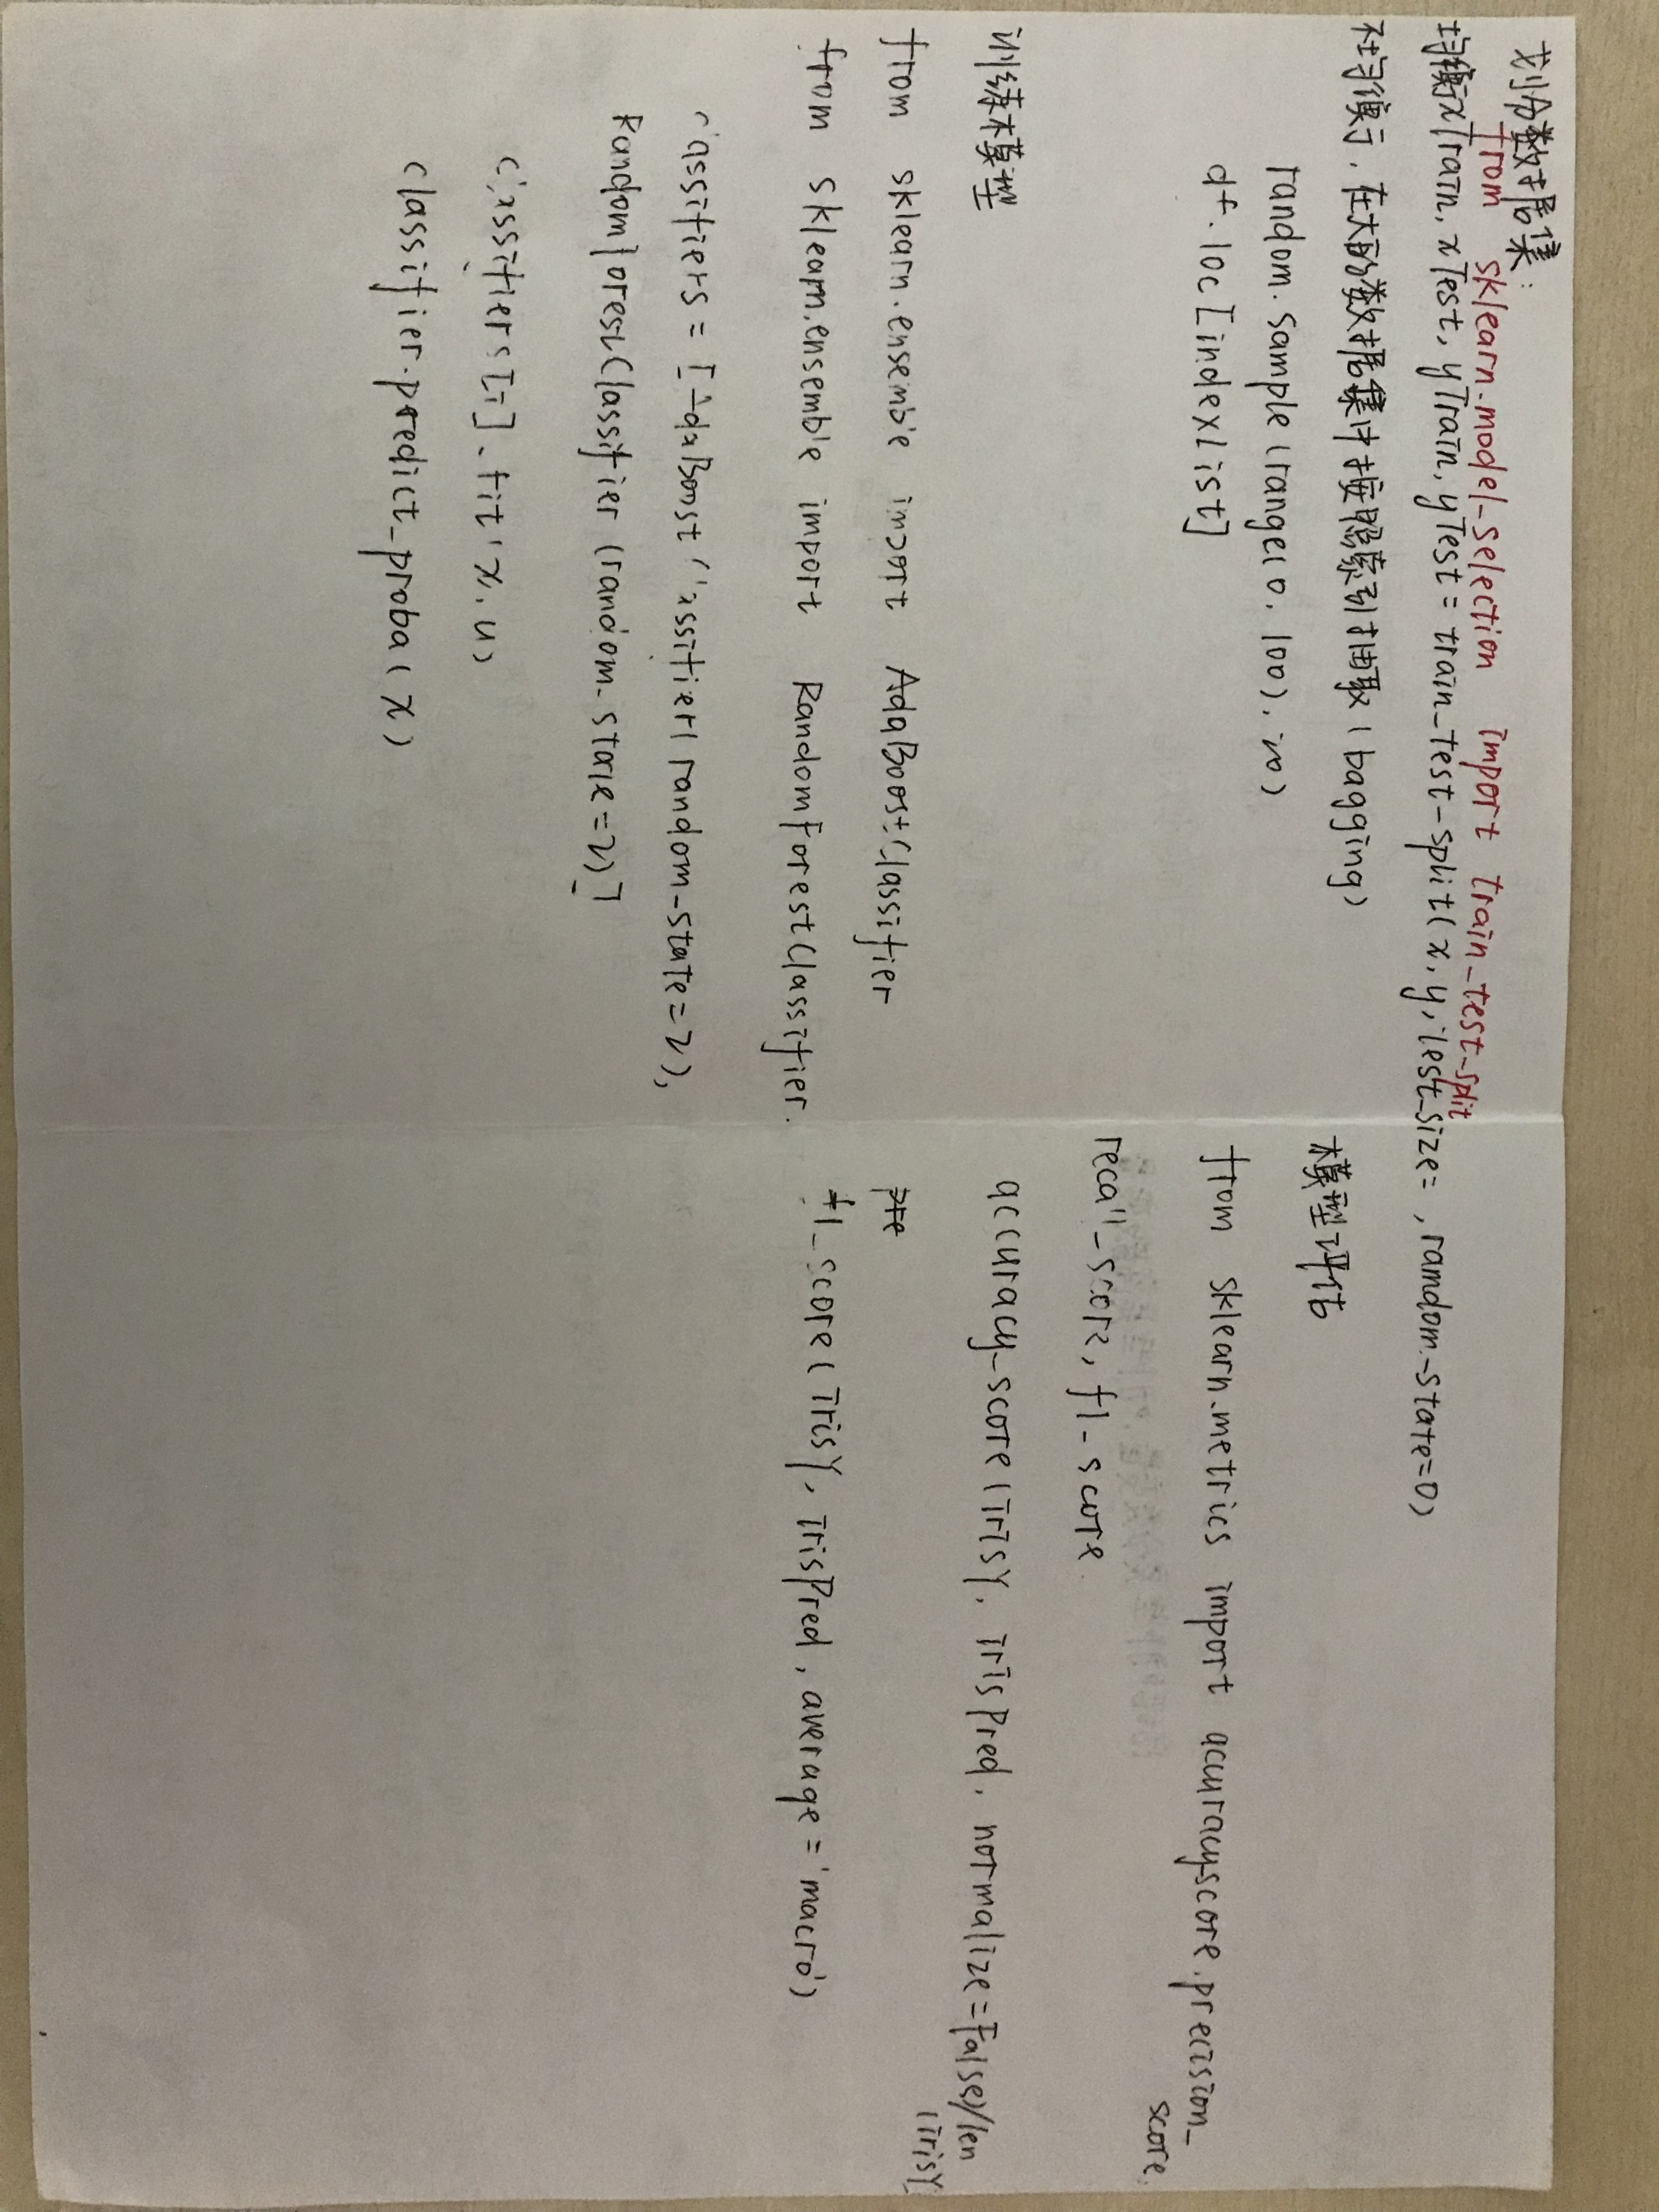
机器学习pipeline总结
# -*- coding: utf-8 -*-

"""scikit-learn introduction

Automatically generated by Colaboratory.

Original file is located at

    https://colab.research.google.com/drive/1quaJafg43SN7S6cNwKFr0_WYn2ELt4Ph

scikit-learn官方网站:https://scikit-learn.org/stable/

模块引入

"""

from sklearn import datasets

from sklearn.metrics import mean_squared_error, r2_score

import matplotlib.pyplot as plt

import numpy as np

"""#分类:

 - SVM(support vector machine):支持向量机

 - svm.SVC()

###iris数据集

 - iris feature: 花萼长度,花萼宽度,花瓣长度,花瓣宽度

 - iris lable: 山鸢尾,杂色鸢尾,维吉尼亚鸢尾

"""

iris = datasets.load_iris()

print('iris feature\n', iris.data[0:5])

print('iris label\n', iris.target[0:5])

"""###创建模型"""

from sklearn import svm

clf = svm.SVC()

irisX = iris.data

irisY = iris.target

clf.fit(irisX, irisY)

irisPred = clf.predict(irisX)

clf.predict([[5.1,3.5,1.4,0.2]])  #刚刚的第1个数据

"""###评估指标

 - accuracy

 - precision

 - recall

 - F1

"""

from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score

print('acc is ', accuracy_score(irisY, irisPred, normalize=False)/len(irisY))

print('precision is ', precision_score(irisY, irisPred, average='macro'))

print('recall is ', recall_score(irisY, irisPred, average='macro'))

print('F1 is ', f1_score(irisY, irisPred, average='macro'))

"""#回归

 - 线性回归

 - 模块:linear_model.LinearRegression()

###糖尿病数据集

"""

diabetes = datasets.load_diabetes()

diabetesX = np.array([[diabetes.data[i][0]] for i in range(0,diabetes.data.shape[0])])

diabetesY = diabetes.target

print('feature\n',diabetesX[:5])

print('label\n',diabetesY[:5])

"""###创建模型"""

from sklearn import svm, linear_model

regr = linear_model.LinearRegression()

regr.fit(diabetesX, diabetes.target)

diabetesPred = regr.predict(diabetesX)

regr.predict([[0.03807591]])  #对于原始数据的第一个值的预测结果

plt.scatter(diabetesX, diabetes.target)  #原始数据的散点图

plt.plot(diabetesX, diabetesPred)  #线性回归的折线图

"""###评价指标

 - 均方误差(mse)

"""

from sklearn.metrics import mean_squared_error

print('mean squared error is ', mean_squared_error(diabetesY, diabetesPred))

"""#聚类

 - k-means

###创建数据集

"""

from sklearn.datasets.samples_generator import make_blobs

clusterX, clusterY = make_blobs(n_samples=1000, n_features=2, centers=[[-1,-1], [0,0], [1,1], [2,2]], cluster_std=[0.4, 0.2, 0.2, 0.2], random_state=0)

plt.scatter(clusterX[:, 0], clusterX[:, 1])

"""###建立模型"""

from sklearn.cluster import KMeans

clu = KMeans(n_clusters=2, random_state=9)

clusterPredict = clu.fit_predict(clusterX)

plt.scatter(clusterX[:, 0], clusterX[:, 1], c=clusterPredict)

plt.show()

"""#模型评估

 - cross validation 交叉验证

 - 以iris数据集为例

"""

from sklearn.model_selection import train_test_split,cross_val_score

from sklearn.metrics import accuracy_score

from sklearn import svm

import warnings

warnings.filterwarnings('ignore')

clf = svm.SVC()

scores = cross_val_score(clf, irisX, irisY, cv=10, scoring='accuracy')

print('十折交叉验证分别的accuracy ', scores)

print('平均的accuracy ', sum(scores/10))

"""- 通过设置随机种子来进行十次十折交叉验证"""

from sklearn.model_selection import StratifiedKFold,KFold

accEachTime = []

for i in range(0,10):

    clf = svm.SVC()

    scores = cross_val_score(clf, irisX, irisY, cv=KFold(n_splits=10, random_state=i, shuffle=True), scoring='accuracy')

    print(scores)

    accEachTime.append(sum(scores/10))

print('每一次的accuracy值 ', accEachTime)

print('十次十折交叉验证的平均accuracy值 ', sum(accEachTime)/10)
机器学习pipeline总结的更多相关文章
- Spark Pipeline官方文档
ML Pipelines(译文) 官方文档链接:https://spark.apache.org/docs/latest/ml-pipeline.html 概述 在这一部分,我们将要介绍ML Pipe ...
- FPGA的过去,现在和未来
我们知道,相对于专业的ASIC,FPGA有上市时间和成本上的优势.另外,在大多数情况下,FPGA执行某些功能较之CPU上的软件操作更高效.这就是为什么我们认为它不但会运用在数据中心的服务器.交换器.存 ...
- 2015 Spark 将走向哪里?
在刚刚过去的spark submit上,Matei Zahara简单回顾了下2014年spark的发展,可用一个词来概括那就是"Amazing"!!! 那么2015年,spark ...
- gen语言
概率编程语言(PPL)领域正经历着机器学习技术快速发展带来的奇迹般的复兴.在短短的几年里,PPL 已经从一个模糊的统计研究领域发展出十几个活跃的开源方案.最近,麻省理工学院(MIT)的研究人员推出了一 ...
- SparkMLLib的简单学习
一. 简介 1. 机器学习中,可以将数据划分为连续数据和离散数据 a. 连续数据:可以取任何值,如房价 b. 离散数据:仅有少量特殊值,如一个房屋有2个或3个房间,但不能为2.75个房间 二. 创建向 ...
- 使用PyTorch进行迁移学习
概述 迁移学习可以改变你建立机器学习和深度学习模型的方式 了解如何使用PyTorch进行迁移学习,以及如何将其与使用预训练的模型联系起来 我们将使用真实世界的数据集,并比较使用卷积神经网络(CNNs) ...
- 使用spark ml pipeline进行机器学习
一.关于spark ml pipeline与机器学习 一个典型的机器学习构建包含若干个过程 1.源数据ETL 2.数据预处理 3.特征选取 4.模型训练与验证 以上四个步骤可以抽象为一个包括多个步骤的 ...
- Spark2.0机器学习系列之2:基于Pipeline、交叉验证、ParamMap的模型选择和超参数调优
Spark中的CrossValidation Spark中采用是k折交叉验证 (k-fold cross validation).举个例子,例如10折交叉验证(10-fold cross valida ...
- spark ml pipeline构建机器学习任务
一.关于spark ml pipeline与机器学习一个典型的机器学习构建包含若干个过程 1.源数据ETL 2.数据预处理 3.特征选取 4.模型训练与验证 以上四个步骤可以抽象为一个包括多个步骤的流 ...
随机推荐
- 我如何通过K8S开发认证(CKAD)考试
题记:笔者最近经过3个多月的空余时间准备,终于通过了K8S开发认证(CKAD)的考试,在这里简单给大家分享一下经验. 一,先科普下CKAD 众所周知,Kubernetes在容器编排器大战中脱颖而出后, ...
- jQuery基础之获取和设置标签元素属性
jQuery基础之获取和设置标签元素属性方法,如下图: 代码实现: <script src="JS/jquery-1.12.4.min.js"></script& ...
- 使用redisson时关于订阅数的问题
在使用redisson消息订阅时,我针对门店商品库存减扣进行订阅的操作(在这里一个商品一个监听队列),当正式投入生产时,发现一直再报Subscribe timeout: (" + timeo ...
- Ubuntu 创建 Pycharm 桌面快捷方式
1. 安装 Pycharm,我的运行目录是: /opt/pycharm-/bin 2. 在 /usr/share/applications/ 下创建文件 pycharm.desktop [Deskto ...
- 《C#并发编程经典实例》学习笔记—3.1 数据的并行处理
问题 有一批数据,需要对每个元素进行相同的操作.该操作是计算密集型的,需要耗费一定的时间. 解决方案 常见的操作可以粗略分为 计算密集型操作 和 IO密集型操作.计算密集型操作主要是依赖于CPU计算, ...
- 性能调优 -- Java编程中的性能优化
String作为我们使用最频繁的一种对象类型,其性能问题是最容易被忽略的.作为Java中重要的数据类型,是内存中占据空间比较大的一个对象.如何高效地使用字符串,可以帮助我们提升系统的整体性能. 现在, ...
- bootstrap-table 常用总结-树形结构(展开和折叠)
今天在工作的时候,遇到了一个需求,就是需要一键展开或者关闭树形结构.关于树形结构的不是很熟悉,然后去百度,结果也不是很准确.最后经过Google才找到.下面分享给大家 直接看代码: var flag ...
- 构建Electron的常见问题(Mac)
背景 起因是产品的需求,需要更换Electron为底层平台,但因为会有不少定制化的功能要实现,必须自己实现此类内容,所以也就导致必须自己编译Electron的源代码. 整个构建过程,看Electron ...
- C lang:Protect array data——Const
Xx_Introduction Use pointer translate parameter array original data will change data,and use const p ...
- Oracle处理关于sysaux表空间爆满的问题---更新最新方法!!
对于SYSAUX表空间而言,如果占用过大,那么一般情况下是由于AWR信息或对象统计信息没有及时清理引起的,具体原因可以通过如下的SQL语句查询: SELECT OCCUPANT_NAME ORDER ...