
PDF提取表格的网页工具——Excalibur
在之前的文章另类爬虫:从PDF文件中爬取表格数据中,我们知道如何利用Python的camelot模块,通过写Python程序来提取PDF中的表格数据。本文我们将学习如何用更便捷的工具从PDF中提取表格。
Excalibur是一个用来从PDF中提取表格数据的网页工具,而它正是以camelot为基础。该工具目前只支持文本类型的PDF,而不支持扫描后的PDF文档,关于其说明和使用文档可以参考网址: https://github.com/camelot-dev/excalibur 。
安装Excalibur
在安装Excalibur之前,需要事先安装ghostscript,具体的安装方式可以参考:https://camelot-py.readthedocs.io/en/master/user/install-deps.html 。不同系统安装ghostscript的方式不一样,以笔者的mac电脑为例,安装命令如下:
$ brew install tcl-tk ghostscript
安装ghostscript完毕后,再通过pip安装Excalibur,命令如下:
$ pip3 install excalibur-py
以上就是全部的安装准备工作了。
启动与使用Excalibur
运行下面的命令启动Excalibur:
$ excalibur initdb

$ excalibur webserver
前一句命令是初始化数据库,后一句命令是运行server服务。在浏览器中输入: http://localhost:5050 ,即可使用该平台。
进入该PDF表格提取平台,首页如下:

笔者测试的PDF中含有以下表格:
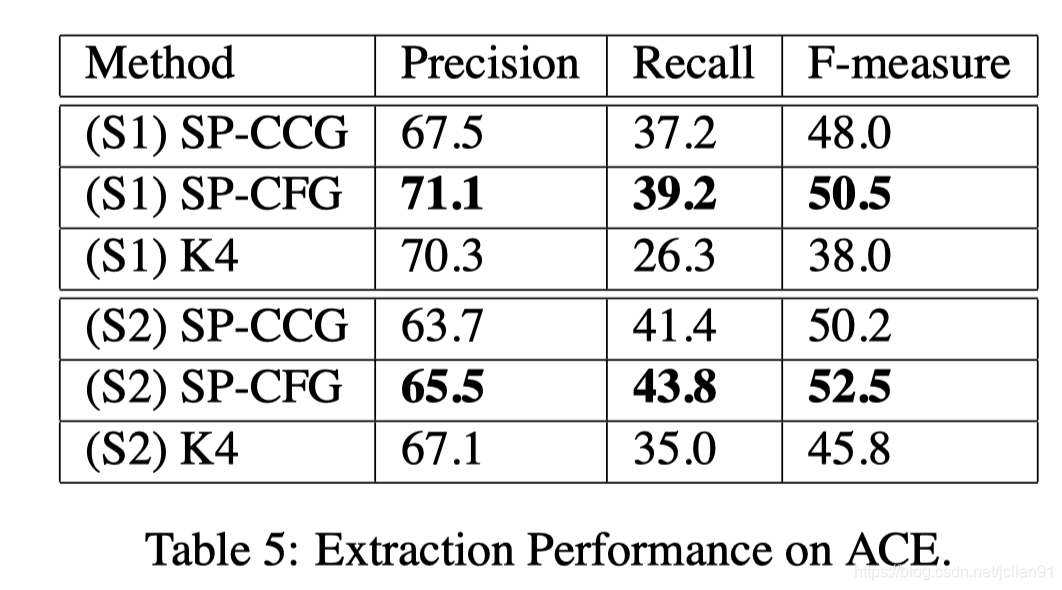
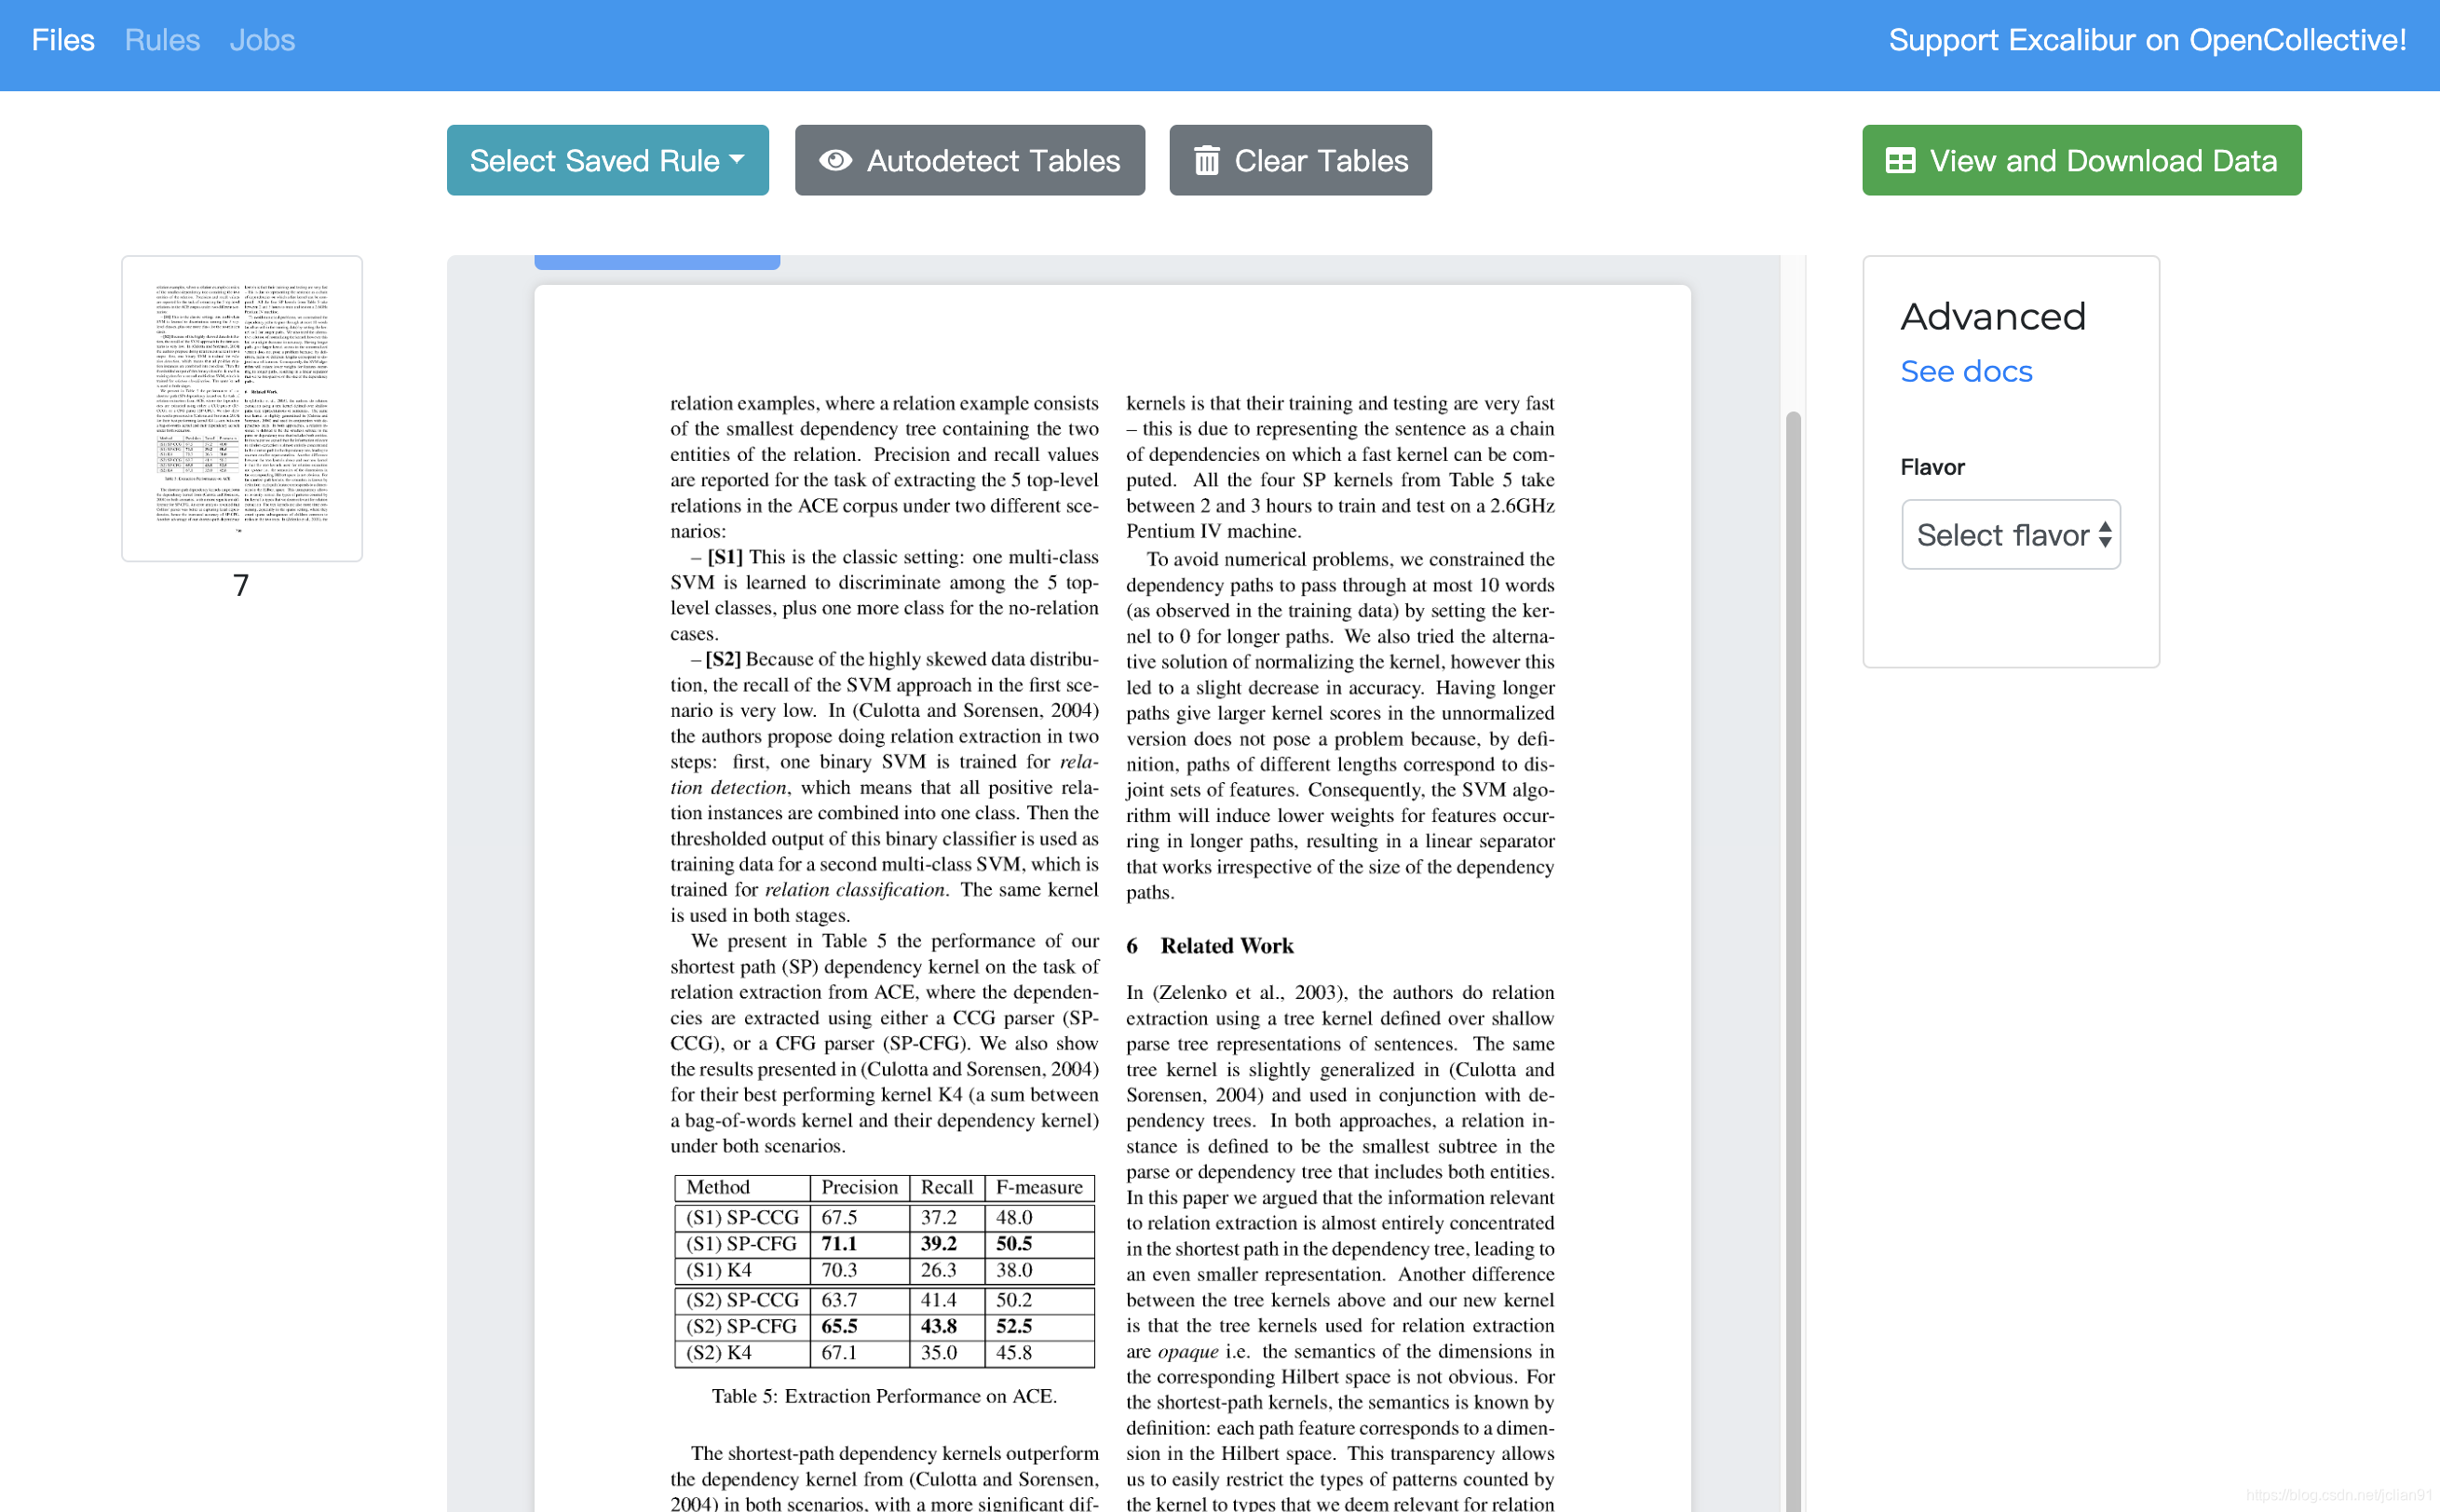
我们将该PDF文档上传至上述平台,点击“Upload PDF”按钮,再选择相应的PDF文档以及该表格所在的页码即可。PDF上传后,该表格所在的那一页如下图所示:
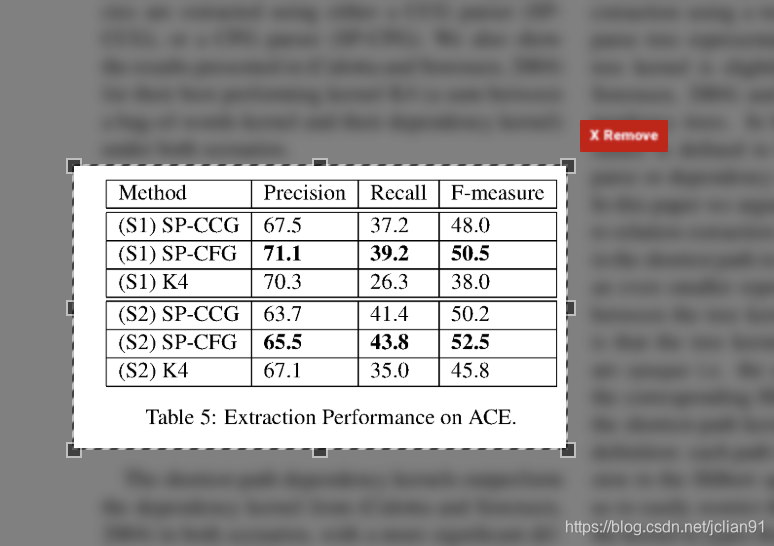
在右侧的Anvanced中的Flavor中选择“lattice”,并用鼠标框选出表格所在的区域,如下图:
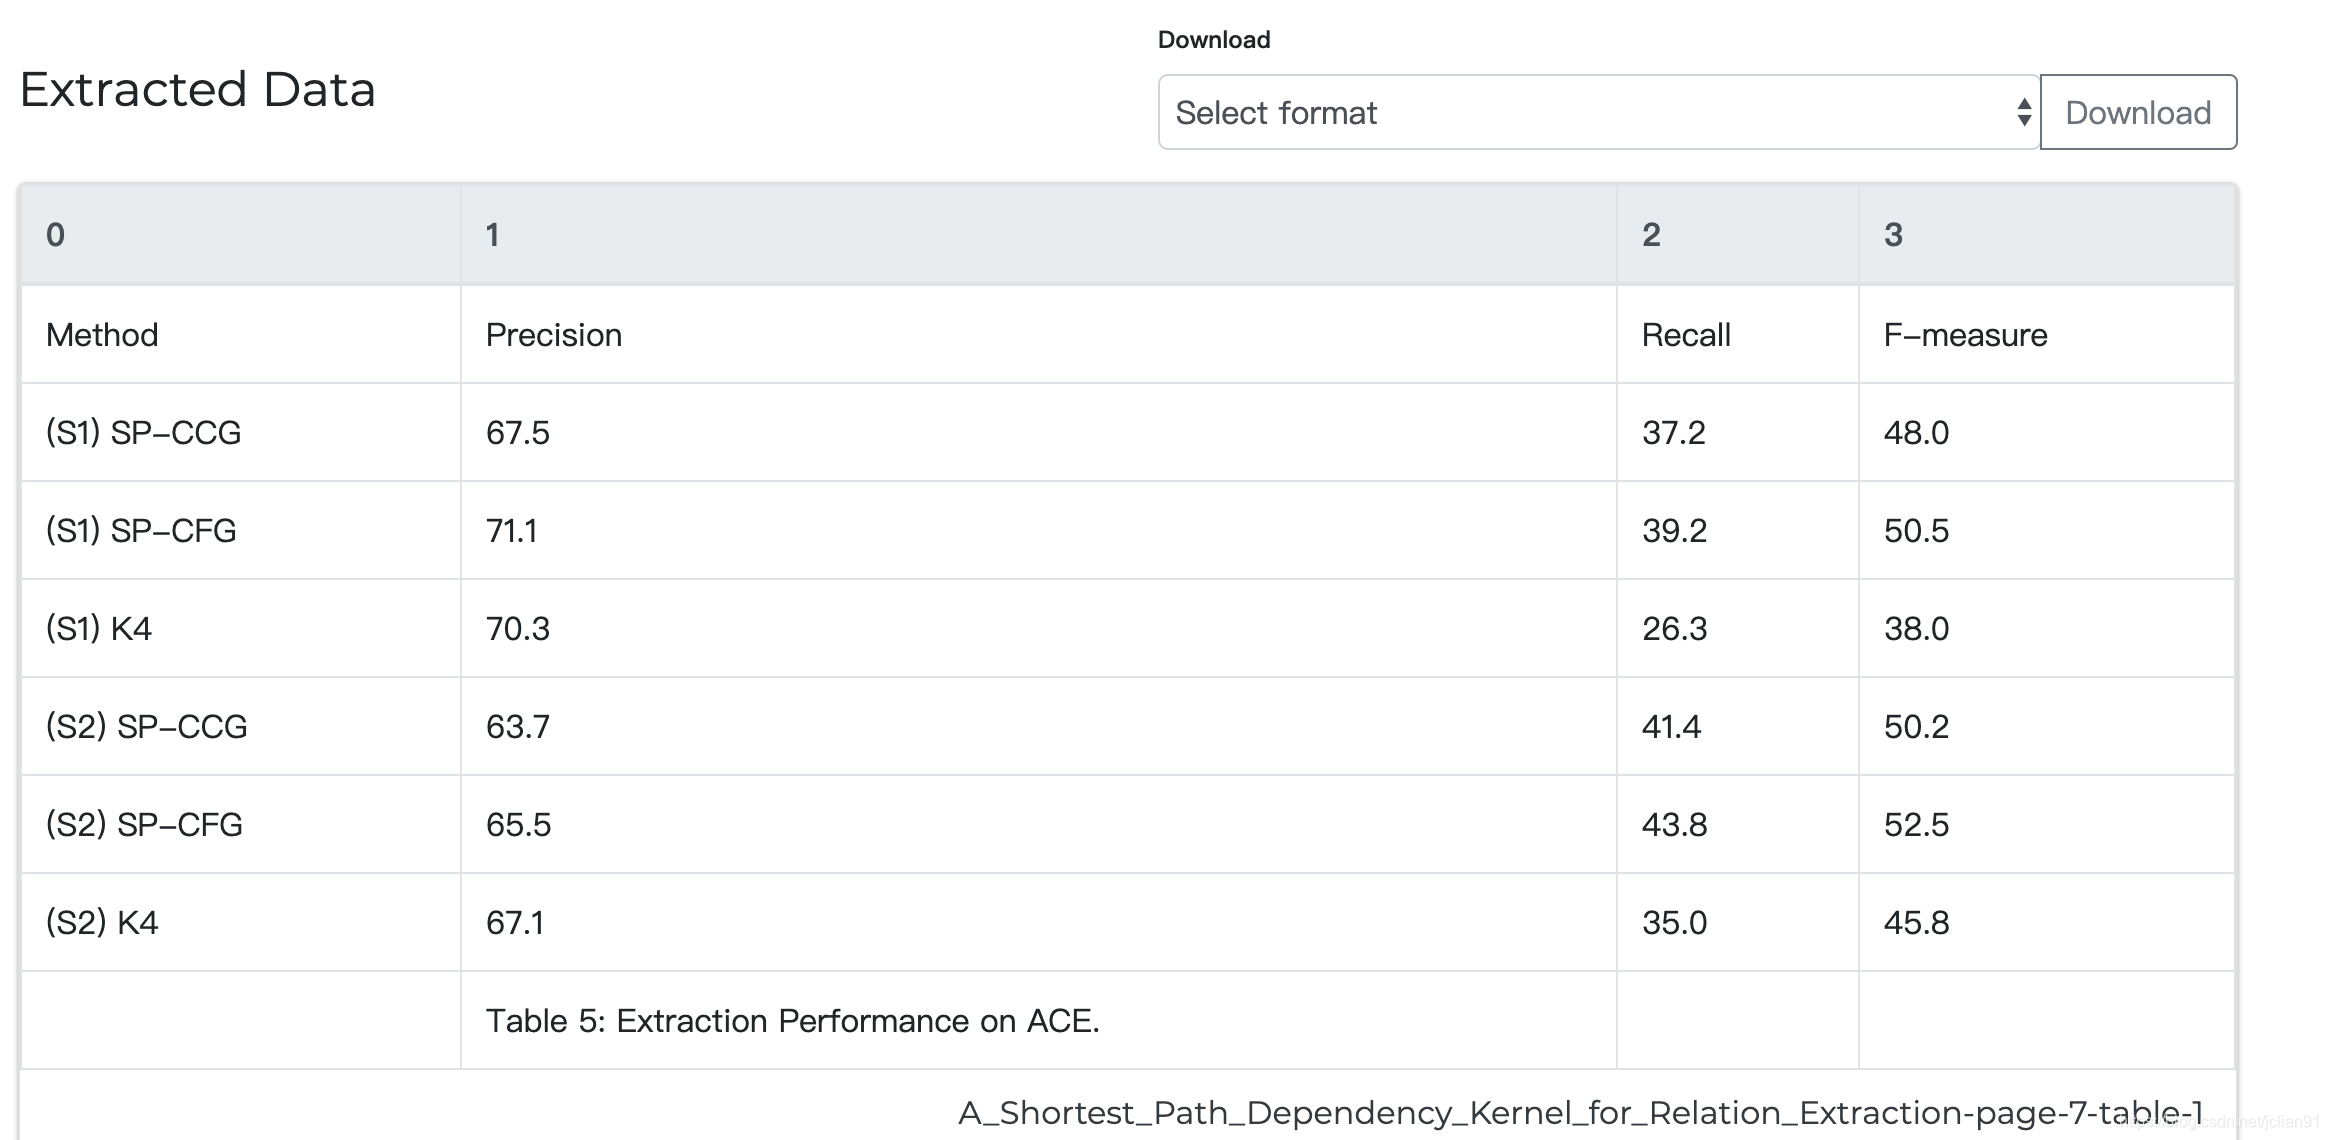
再点击“View and Download Data”按钮,就能得到从PDF解析表格后得到的数据了。截图如下:
如果我们还想将这个表格解析后的结果保存为文件,则可以在Download旁的下拉框中选择一种保存的形式,并点击Download按钮。比如,笔者选择保存为csv文件,则下载后的文件如下:
"Method","Precision","Recall","F-measure"

"(S1) SP-CCG","67.5","37.2","48.0"

"(S1) SP-CFG","71.1","39.2","50.5"

"(S1) K4","70.3","26.3","38.0"

"(S2) SP-CCG","63.7","41.4","50.2"

"(S2) SP-CFG","65.5","43.8","52.5"

"(S2) K4","67.1","35.0","45.8"

"","Table 5: Extraction Performance on ACE.","",""
我们可以发现,该表格解析后的结果还是相当漂亮的。
本次分享到此结束,感谢大家的阅读。
注意:本人现已开通微信公众号: Python爬虫与算法(微信号为:easy_web_scrape), 欢迎大家关注哦~~
PDF提取表格的网页工具——Excalibur的更多相关文章
- 单个pdf提取测试
# -*- coding: utf-8 -*- """ Created on Wed Feb 3 09:32:22 2016 pdf单个文件提取测试 @author: A ...
- ExcelPatternTool: Excel表格-数据库互导工具
ExcelPatternTool Excel表格-数据库互导工具 介绍: 指定Pattern文件-一个规则描述的json文档,基于此规则实现Excel表格与数据库之间的导入导出,校验等功能. 特点: ...
- Introduce: IEPI.BIATranscribe 图像表格拓写工具
应用场合 数据表格是学术.文案工作中常用的表述形式.我们经常需要从第三方获取所需的数据.有些时候这些数据并非以可直接编辑的形式(如电子表格文档),而是以打印件或者扫描件的形式提供.假如需要对数据进行进 ...
- C# 绘制PDF嵌套表格
嵌套表格,即在一张表格中的特定单元格中再插入一个或者多个表格,使用嵌套表格的优点在于能够让内容的布局更加合理,同时也方便程序套用.下面的示例中,将介绍如何通过C#编程来演示如何插入嵌套表格到PDF文档 ...
- 表格和网页ico图标
表格: 表格格式: <table> <tr> 表格的行 <th >表头</th> <th>表头 </th> </tr> ...
- 办公室文员必备python神器,将PDF文件表格转换成excel表格!
[阅读全文] 第三方库说明 # PDF读取第三方库 import pdfplumber # DataFrame 数据结果处理 import pandas as pd 初始化DataFrame数据对象 ...
- 美国usan数据库——PDF提取
QQ:231469242 原创 单个PDF内容提取 # -*- coding: utf-8 -*- """ io.open() is the preferred, hig ...
- 使用POI插件,提取导出excel的工具类
在网站的不同的模块都需要使用到导入导出excel的功能,我们就需要写一个通用的工具类ExcelUtil. 我的思路:首先,导入和导出的Excel的文件格式固定:主标题,二级标题,数据行(姑且就这么叫) ...
- 页面导出生成pdf,使用wkhtmltopdf第三方工具
把页面导出生成pdf,这里用到第三方的工具,使用方法中文文档没有找到,网上也没找到网友详细的神作.没有深入研究,所以也不赘述了,当然最基本的使用大多数也够用了,详细参数的官网也没介绍,大家使用的时候, ...
随机推荐
- 20191010-9 alpha week 1/2 Scrum立会报告+燃尽图 07
此作业要求参见https://edu.cnblogs.com/campus/nenu/2019fall/homework/8752 一.小组情况 队名:扛把子 组长:迟俊文 组员:宋晓丽 梁梦瑶 韩昊 ...
- 20191010-5 alpha week 1/2 Scrum立会报告+燃尽图 03
此作业要求参见[https://edu.cnblogs.com/campus/nenu/2019fall/homework/8748] 一.小组情况 队名:扛把子 组长:迟俊文 组员:宋晓丽 梁梦瑶 ...
- 网络爬虫一定要用代理IP吗
数据采集现在已经成为大数据时代不可以缺少的一部分,在数据采集过程中,很多人都会用到代理ip,那么网络爬虫一定要用代理IP吗?答案虽然不是肯定的,但出现以下情况一定是需要用到代理IP的.1.在爬虫的时候 ...
- 常见HTTP请求头和响应头
2. 常用的HTTP请求头 协议头 说明 示例 状态 Accept 可接受的响应内容类型(Content-Types). Accept: text/plain 固定 Accept-Charset 可接 ...
- Android最大方法数和解决方案
转载请标明出处:http://blog.csdn.net/shensky711/article/details/52329035 本文出自: [HansChen的博客] 什么是64K限制和Linear ...
- MySQL(学生表、教师表、课程表、成绩表)多表查询
1.表架构 student(sid,sname,sage,ssex) 学生表 course(cid,cname,tid) 课程表 sC(sid,cid,score) 成绩表 teacher(tid,t ...
- Go语言冒泡、选择、插入、快速排序实战浅析
Hello,各位小伙伴大家好,我是小栈君,今天为大家带来的分享是关于go语言中的排序实战浅析. 我们就实际操作关于go的冒泡排序.选择排序.插入排序和快速排序四种方式的理论和实战进行分享,希望能够为大 ...
- python加载csv数据
入门机器学习时,一些测试数据是网络上的csv文件.这里总结了两种加载csv文件的方式: 1 通过numpy.urllib2加载 import numpy as np import urllib2 ur ...
- CCNA 之 十三 广域网概述
广域网概述 为什么需要WAN ? 分区或分支机构的员工需要与总部通信并共享数据: 组织经常需要与其他组织远距离共享信息: 经常出差的员工需要访问公司网络信息: 什么事广域网链路? 用于连接LAN的.跨 ...
- CCNA 之 十 ACL 访问控制列表
ACL 访问控制列表 ACL(Access Control List) 接入控制列表 ACL 的量大主要功能: 流量控制 匹配感兴趣流量 标准访问控制列表 只能根据源地址做过滤 针对曾哥协议采取相关动 ...