
[ML学习笔记] XGBoost算法
[ML学习笔记] XGBoost算法
回归树
决策树可用于分类和回归,分类的结果是离散值(类别),回归的结果是连续值(数值),但本质都是特征(feature)到结果/标签(label)之间的映射。
这时候就没法用信息增益、信息增益率、基尼系数来判定树的节点分裂了,那么回归树采用新的方式是预测误差,常用的有均方误差、对数误差等(损失函数)。而且节点不再是类别,而是数值(预测值),划分到叶子后的节点预测值有不同的计算方法,有的是节点内样本均值,有的是最优化算出来的比如Xgboost。
XGBoost算法
XGBoost是由许多CART回归树集成。区别于随机森林的bagging集成,它是一种boosting集成学习(由多个相关联的决策树联合决策,下一棵决策树输入样本会与前面决策树的训练和预测相关)。它的目标是希望建立K个回归树,使得树群的预测值尽量接近真实值(准确率)而且有尽量大的泛化能力(寻求更为本质的东西)。
记w为叶子节点的权值,x为分类结果,则最终预测值 \(\hat{y}_i = \sum_j w_j x_{ij}\)。
设目标函数为 \(l(y_i,\hat{y}_i)=(y_i-\hat{y}_i)^2\)。
对于一组数值需要求平均,相当于求其期望 \(F^*(\overrightarrow{x})=argminE_{(x,y)}[L(y,F(\overrightarrow{x}))]\)
最终结果由多个弱分类器组成,集成的结果:\(\hat{y}_i = \sum_{k=1}^K f_k(x_i), \quad f_k\in F\)
XGBoost本质是提升树,也即每加一棵效果更好(目标函数更优)
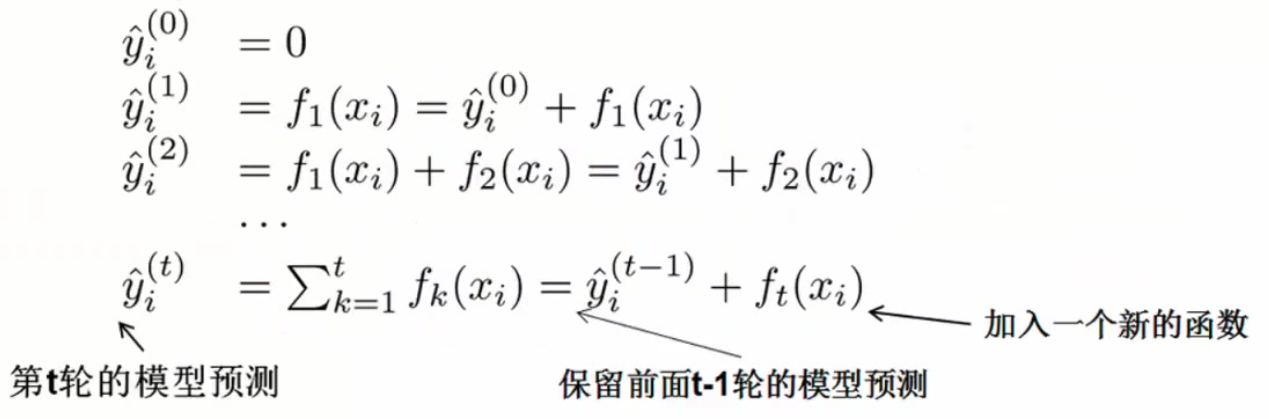
定义正则化惩罚项 \(\Omega(f_t)=\gamma T+\frac{1}{2}\lambda \sum_{j=1}^T \omega_j^2\)(叶子个数 + w的L2正则项)
如何选择每一轮加入什么f(预测值->落入的叶子权值):选取使得目标函数尽量最大地降低(找到\(f_t\)来优化这一目标)
\[
\begin{split}
Obj^{(t)}&=\sum_{i=1}^n l(y_i,\hat{y}_i^{(t)})+\sum_{i=1}^n\Omega(f_i)\\
&=\sum_{i=1}^n l(y_i,\hat{y}_i^{(t-1)}+f_t(x_i))+ \Omega(f_t)+constant\\
&=\sum_{i=1}^n (y_i-(\hat{y}_i^{(t-1)}+f_t(x_i))^2+ \Omega(f_t)+constant\\
&=\sum_{i=1}^n [2(\hat{y}_i^{(t-1)}-y_i)f_t(x_i)+f_t(x_i)^2]+ \Omega(f_t)+constant\\
\end{split}
\]
用\(\hat{y}_i^{(t-1)}-y_i\) 描述前t-1棵的总预测值与真实值之间的差异(残差),因此梯度提升决策树也称残差决策树。
目标函数Obj是一个队树结构进行打分的函数(结构分数 structure score),分数越小代表树结构越好。用泰勒展开近似求解:
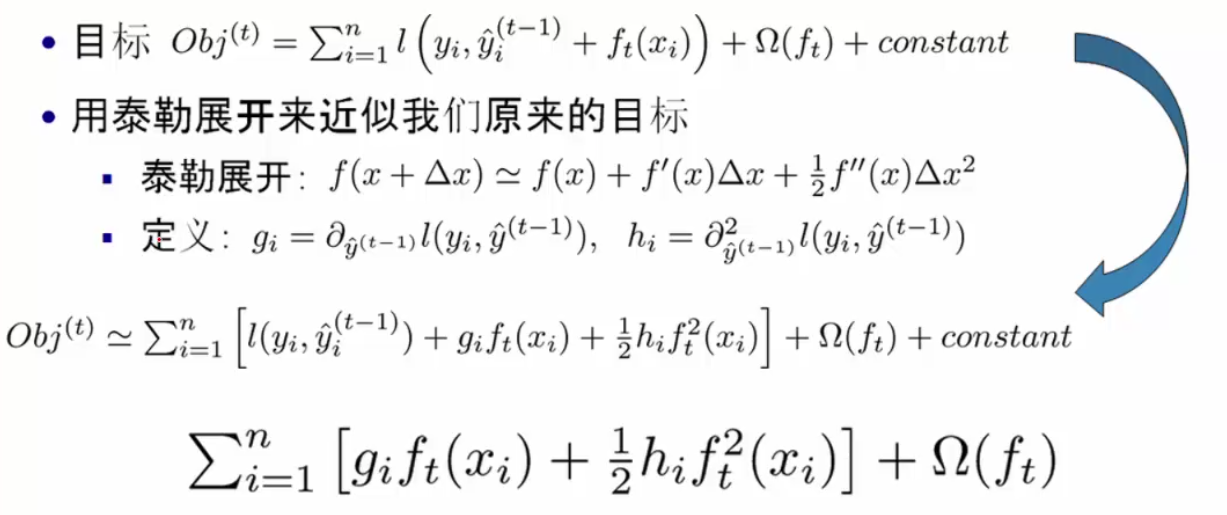
由对样本的遍历变换为对叶节点的遍历
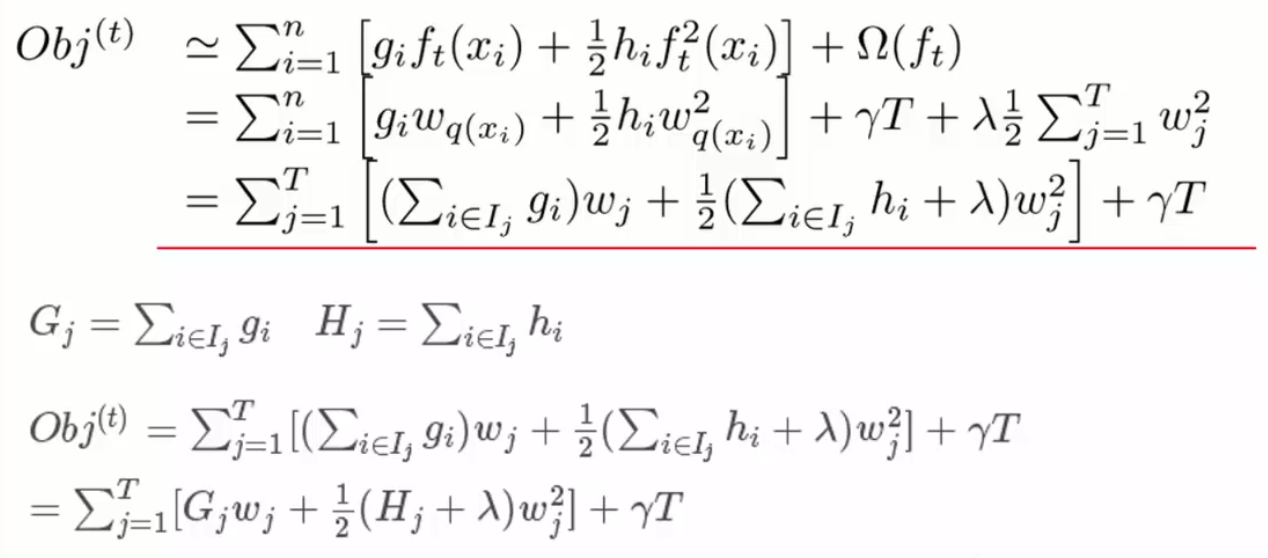
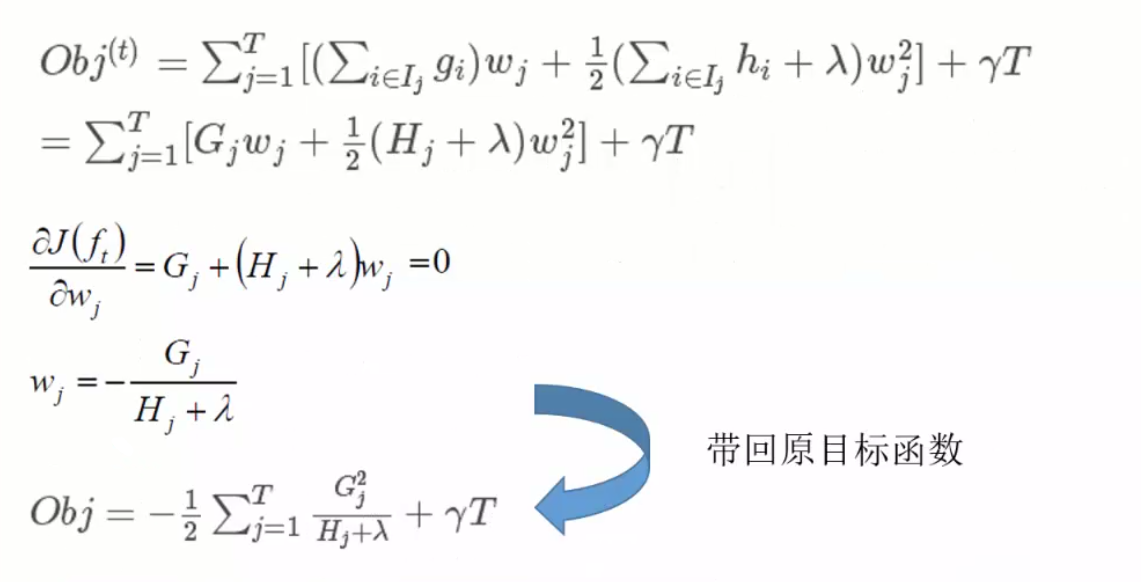
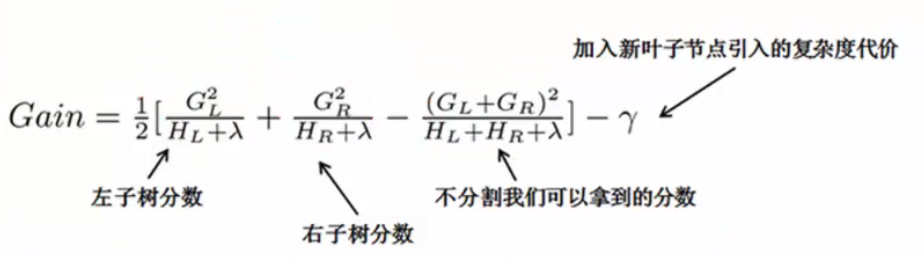
单节点怎么切分(分叉):枚举所有可能的分割方案,假设要枚举所有x<a这样的条件,对于某个特性的分割a,分别计算切割前和分割后的差值以求增益。
推荐阅读:
- 陈天奇博士的文章 Introduction to Boosted Trees (附:原PPT地址、中文笔记博客)
[ML学习笔记] XGBoost算法的更多相关文章
- [ML学习笔记] 朴素贝叶斯算法(Naive Bayesian)
[ML学习笔记] 朴素贝叶斯算法(Naive Bayesian) 贝叶斯公式 \[P(A\mid B) = \frac{P(B\mid A)P(A)}{P(B)}\] 我们把P(A)称为"先 ...
- [ML学习笔记] 决策树与随机森林(Decision Tree&Random Forest)
[ML学习笔记] 决策树与随机森林(Decision Tree&Random Forest) 决策树 决策树算法以树状结构表示数据分类的结果.每个决策点实现一个具有离散输出的测试函数,记为分支 ...
- [ML学习笔记] 回归分析(Regression Analysis)
[ML学习笔记] 回归分析(Regression Analysis) 回归分析:在一系列已知自变量与因变量之间相关关系的基础上,建立变量之间的回归方程,把回归方程作为算法模型,实现对新自变量得出因变量 ...
- 学习笔记 - Manacher算法
Manacher算法 - 学习笔记 是从最近Codeforces的一场比赛了解到这个算法的~ 非常新奇,毕竟是第一次听说 \(O(n)\) 的回文串算法 我在 vjudge 上开了一个[练习],有兴趣 ...
- ML学习笔记之Anaconda中命令形式安装XGBoost(pip install)
0x00 概述 在没有安装XGBoost之前,import xgboot会出错,如下: # ModuleNotFoundError: No module named ‘xgboost’ 0x01 安装 ...
- ML学习笔记之XGBoost实现对鸢尾花数据集分类预测
import xgboost as xgb import numpy as np import pandas as pd from sklearn.model_selection import tra ...
- 学习笔记——EM算法
EM算法是一种迭代算法,用于含有隐变量(hidden variable)的概率模型参数的极大似然估计,或极大后验概率估计.EM算法的每次迭代由两步组成:E步,求期望(expectation):M步,求 ...
- 数据挖掘学习笔记--AdaBoost算法(一)
声明: 这篇笔记是自己对AdaBoost原理的一些理解,如果有错,还望指正,俯谢- 背景: AdaBoost算法,这个算法思路简单,但是论文真是各种晦涩啊-,以下是自己看了A Short Introd ...
- 学习笔记-KMP算法
按照学习计划和TimeMachine学长的推荐,学习了一下KMP算法. 昨晚晚自习下课前粗略的看了看,发现根本理解不了高端的next数组啊有木有,不过好在在今天系统的学习了之后感觉是有很大提升的了,起 ...
随机推荐
- oracle 删除服务sc delete Oracle
oracle 删除服务sc delete OracleVssWriterorcl -----(oracle orcl vss writer service的服务名!)
- SpringMVC源码阅读:属性编辑器、数据绑定
1.前言 SpringMVC是目前J2EE平台的主流Web框架,不熟悉的园友可以看SpringMVC源码阅读入门,它交代了SpringMVC的基础知识和源码阅读的技巧 本文将通过源码(基于Spring ...
- python的Web框架:初识Django
web应用程序 本质 socket服务端 浏览器本质是一个socket客户端 1. 服务器程序 socket请求 接受HTTP请求,发送HTTP响应. 比较底层,繁琐,有专用的服务器软件,如:Apac ...
- UIKit 框架之UIView一
- (id)initWithFrame:(CGRect)aRect //通过一个矩形对象初始化 Configuring a View’s Visual Appearance //配置视觉展示 @pro ...
- SQL语句,表中的列字段字符串合并 和 字符串拆分成表
研究了两天也没有研究的很明白,但是问题做出来了, 如下表中的字段,第一级是由逗号隔开字符串,第二级是由空格隔开的字符串,现在想取空格字符串中的第几个空格前后的字符串, 所用到的工具,1.是 for x ...
- [日常] Go语言圣经-可变参数习题
1.参数数量可变的函数称为为可变参数函数,例子就是fmt.Printf和类似函数2.参数列表的最后一个参数类型之前加上省略符号“...”3.虽然在可变参数函数内部,...int 型参数的行为看起来很像 ...
- 【ZeroMQ】1、ZeroMQ(java)入门之Requerst/Response模式
自己最开始是在cloud foundry中接触过消息服务器(nats),或者说是消息中间件,也算是初步知道了一个消息服务器对于分布式的网络系统的重要性,后来自己也曾想过在一些项目中使用它,尤其是在一些 ...
- 【Linux】apt-get 源地址汇总
修改etc/apt/sources.list文件 deb http://mirrors.163.com/ubuntu/ lucid main restricted universe multivers ...
- Java面试中遇到的坑【填坑篇】
看到大家对上篇<Java面试中遇到的坑>一文表现出强力的关注度,说明大家确实在面试中遇到了类似的难题.大家在文章留言处积极留言探讨面试中遇到的问题,其中几位同学还提出了自己的见解,我感到非 ...
- HDU2444(KB10-B 二分图判定+最大匹配)
The Accomodation of Students Time Limit: 5000/1000 MS (Java/Others) Memory Limit: 32768/32768 K ( ...