
记录一次C#爬虫记录,获取必应图片
记录一次C#爬虫记录,获取必应图片
起因
事情是这样的,我创建了一个仓库,里面有2018年到目前为止每日的必应壁纸,在八月份的时候我看到微软有接口文档,于是写了一个服务,每天早上八点钟会获取必应壁纸(目前已经可以作为api来使用了,暂时不对外开放)
然后推送到微信上面。这个项目的地址是 https://gitee.com/Pridejoy/Bing,有兴趣的可以去看看。但是吧,这个仓库有两个问题
- 2018年以前的壁纸没有的
- 2018年后的壁纸没有版权说明
为了更新这个仓库,我偶然见发现一个网站里面有必应壁纸,而且免费开放,我就绝对去爬这个网站
经过
说干就干,我学的是C#,听闻python的爬虫很厉害,但是0基础入门就不怎么回来,下定决心就干,我发现了一个neget包爬虫挺简单的。我分析了需要爬虫的网站。然后就开始下代码
步骤
不如授人以鱼不如授人以渔
使用的具体详情 https://www.cnblogs.com/xuliangxing/p/8004403.html
安装包
HtmlAgilityPack
如何加载Html
主要常见的有三种方式;从文件加载、从字符串加载、从网页链接加载。
// 从物理路径的文件加载

var doc = new HtmlDocument();

doc.Load(filePath);//文件路径

// 从Stream当中加载

var doc = new HtmlDocument();

doc.LoadHtml(html);

// 从网页的Url链接加载

var url = "http://www.cnblogs.com/xuliangxing/";

var web = new HtmlWeb();

var doc = web.Load(url);
以Stream对象为主的重载方法:
(1)public void Load(Stream stream)    ///从指定的Stream对象中加载html;

(2)public void Load(Stream stream, bool detectEncodingFromByteOrderMarks)    ///指定是否从顺序字节流中解析编码格式

(3)public void Load(Stream stream, Encoding encoding)    ///指定编码格式

(4)public void Load(Stream stream, Encoding encoding, bool detectEncodingFromByteOrderMarks)

(5)public void Load(Stream stream, Encoding encoding, bool detectEncodingFromByteOrderMarks, int buffersize)  ///缓冲区大小
以指定的物理路径为主的重载方法:
(1)public void Load(string path)

(2)public void Load(string path, bool detectEncodingFromByteOrderMarks)    ///指定是否从顺序字节流中解析编码格式

(3)public void Load(string path, Encoding encoding)    ///指定编码格式

(4)public void Load(string path, Encoding encoding, bool detectEncodingFromByteOrderMarks)

(5)public void Load(string path, Encoding encoding, bool detectEncodingFromByteOrderMarks, int buffersize)
如何精准定位到我们需要的数据
这个时候我们需要用到HtmlNodeCollection和HtmlNode这两个类,我们把Html每个标签看作一个Node,所有我们想到定位到某个标签的内容,就需要知道这个标签的相关属性。顺便说一下,HtmlNode类实现了IXPathNavigable接口,这说明了它可以通过xpath来定位数据了,如果你对解析XML格式数据的XmlDocument类了解的话,特别是使用过了SelectNodes()和SelectSingleNode()方法的人来说,对使用HtmlNode类将会很熟悉。其实Html Agility Pack内部是把html解析成xml文档格式了的,所以支持xml中的一些常用查询方式。下面通过简单示例对HtmlNode的一些主要的常用成员作简要的说明。
1.通过ID属性(或者其他属性)来选择对应的节点
通用格式:@id=‘xxxx’(id可以是其他属性等等),比如我们要定位到本文博客主页的标题和副标题内容。
 HtmlAgilityPack.HtmlDocument doc = new HtmlAgilityPack.HtmlDocument();

 doc.LoadHtml(url)//博客主页URL

 //下面的意思是:通过属性id的值,来定位header下的blogTitle节点信息

 HtmlNode titleNode = doc.DocumentNode.SelectSingleNode("//div[@id='header']/div[@id='blogTitle']");
我们还可以不通过属性id去定位,还有通过索引去定位,如下所示,这个效果和上面是等同的:
//下面的意思是:通过索引定位,div[2]是表示根节点的第二个

 HtmlNode titleNode = doc.DocumentNode.SelectSingleNode("//div[2]/div[1]");
备注:注意路径里"//"表示从根节点开始查找,两个斜杠‘//’表示查找所有childnodes;一个斜杠'/'表示只查找第一层的childnodes(即不查找grandchild);点斜杠"./"表示从当前结点而不是根结点开始查找
2.如何获取节点文本内容
 IDNode.OuterHtml ///返回结果是:<h1><a id="Header1_HeaderTitle" class="headermaintitle" href="http://www.cnblogs.com/xuliangxing/">法号阿兴</a></h1>

 IDNode.InnerHtml ///返回结果是:<a id="Header1_HeaderTitle" class="headermaintitle" href="http://www.cnblogs.com/xuliangxing/">法号阿兴</a>

 IDNode.InnerText ///返回结果是:法号阿兴
3.如何获取节点属性值
假如我们上面Html数据当中,博主博客地址,在标签<div id="header">里的<a>标签里,这个时候就需要使用HtmlNode下的Attribute属性了。
string url = doc.DocumentNode.SelectSingleNode("//div[@id='header']/div[@id='blogTitle']/a").Attributes["href"].Value;
4.如何获取某个标签的所有节点
我们如果获取前面Html数据的li所有分类,这个时候需要使用方法SelectNodes了
HtmlNodeCollection uiListNodes = doc.DocumentNode.SelectNodes("//ui[@id='navList']/li")
5.如何去掉外层的html tag只留下文本内容
回到我们刚刚上面讲到的地方,用remove方法。假设要删除上文结点<a id="Header1_HeaderTitle" class="headermaintitle" href="http://www.cnblogs.com/xuliangxing/">法号阿兴</a>,你想留下博客名称而不要的话,那你需要先得到这个Html结点,通过remove方法删除掉多余的HTML Tag假设该节点叫Node:
Node.ParentNode.RemoveChild(Node,true);
结果
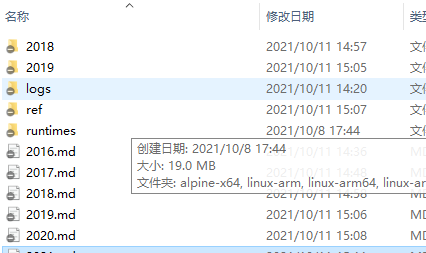
结构当然是ok的了,经过一个小时的爬虫整理上传。
已经上传
2016年壁纸(366张)
2017年必应壁纸(365)
2018年必应壁纸(365张)
2019年必应壁纸(365张)
2020年必应壁纸(366张)
每一张都是精彩绝伦
等到后面会把api开放出来,可以通过情求获取壁纸,包括不同的分辨率
先说明下,
具体的源码 https://wwa.lanzoui.com/iXeZTv7pevi

记录一次C#爬虫记录,获取必应图片的更多相关文章
- Slq怎么样获取首条记录和最后一条记录
sql如何查询表的第一条记录和最后一条记录 方法一:使用top select TOP 1 * from apple;TOP 1 表示表apple中的第一条数据 select TOP 1 * from ...
- 使用webcollector爬虫技术获取网易云音乐全部歌曲
最近在知乎上看到一个话题,说使用爬虫技术获取网易云音乐上的歌曲,甚至还包括付费的歌曲,哥瞬间心动了,这年头,好听的流行音乐或者经典老歌都开始收费了,只能听不能下载,着实很郁闷,现在机会来了,于是开始研 ...
- .NET Core 日志记录程序和常用日志记录框架
本文主要内容为.NET Core的日志记录程序和常使用的日志记录框架的简单使用 首先,打开VS2019新建一个ASP.NET Core Web Api项目,项目创建好后会有一个集成好的天气预报的类和控 ...
- 放养的小爬虫--京东定向爬虫(AJAX获取价格数据)
放养的小爬虫--京东定向爬虫(AJAX获取价格数据) 笔者声明:只用于学习交流,不用于其他途径.源代码已上传github.githu地址:https://github.com/Erma-Wang/Sp ...
- 爬虫, 获取登录者的外网IP
笔者学习了一下用爬虫, 获取登录者的外网IP. 首先导入Jsoup的jar包 public class RetrivePage { private static String url="ht ...
- python爬虫3——获取审查元素(板野友美吧图片下载)
测试环境:python2.7 + beautifulsoup4.4.1 + selenium2.48.0 测试网址:http://tieba.baidu.com/p/2827883128 目的是下载该 ...
- 【Python项目】简单爬虫批量获取资源网站的下载链接
简单爬虫批量获取资源网站的下载链接 项目链接:https://github.com/RealIvyWong/GotDownloadURL 1 由来 自己在收集剧集资源的时候,这些网站的下载链接还要手动 ...
- A记录,CNAME,MX记录,TTL
A记录 A记录是用来指定主机名(或域名)对应的IP地址记录.用户可以将该域名下的网站服务器指向到自己的web server上.同时也可以设置您域名的二级域名. MX记录 MX记录邮件路由记录,用户可以 ...
- 使用C#正则表达式获取必应每日图片地址
微软的Bing搜索引擎首页每天都会提供了一些有趣的图片,下面使用正则表达式获取图片的地址,不管是在手机app还是在网站上都是很好的图片素材,而且每天更新,非常不错. 首先访问微软的API,该地址返回的 ...
- (java)Jsoup爬虫学习--获取智联招聘(老网站)的全国java职位信息,爬取10页
Jsoup爬虫学习--获取智联招聘(老网站)的全国java职位信息,爬取10页,输出 职位名称*****公司名称*****职位月薪*****工作地点*****发布日期 import java.io.I ...
随机推荐
- 记一次 公司.NET项目部署在Linux环境压测时 内存暴涨分析
一:背景 讲故事 公司部署在某碟上的项目在9月份压测50并发时,发现某个容器线程.内存非正常的上涨,导致功能出现了异常无法使用.根据所学,自己分析了下线程和内存问题,分析时可以使用lldb或者wind ...
- 面试官的几句话,差点让我挂在HTTPS上
作为软件测试,大家都知道一些常用的网络协议是我们必须要了解和掌握的,比如 HTTP 协议,HTTPS 协议就是两个使用非常广泛的协议,所以也是面试官问的面试的时候问的比较多的两个协议:而且因为这两个协 ...
- Spring —— bean生命周期
bean生命周期 生命周期:从创建到消亡的完整过程 bean生命周期:bean从创建到销毁的整体过程 bean生命周期控制:在bean创建后到销毁前做一些事情 方式一:配置控制生命周期 <b ...
- 【赵渝强老师】使用Docker UI
Docker提供一个平台来把应用程序当作容器来打包.分发.共享和运行,它已经通过节省工作时间来拯救了成千上万的系统管理员和开发人员.Docker不用关注主机上运行的操作系统是什么,它没有开发语言.框架 ...
- Android系统之System Server大纲
前言 System Server是android 基本服务的提供者,是android系统运行的最基本需求,所有server运行在一个叫system_process的进程中,system_process ...
- Java日期时间API系列14-----Jdk8中java.time包中的新的日期时间API类,java日期计算1,获取年月日时分秒等
通过Java日期时间API系列8-----Jdk8中java.time包中的新的日期时间API类的LocalDate源码分析 ,可以看出java8设计非常好,实现接口Temporal, Tempora ...
- [Vue warn]: Error in v-on handler (Promise/async): "TypeError: Object(...) is not a function"
引用外部发文件时候,只是部分引用,所以原本是解构方式引用的,我忘记加{ }了
- centos7安装python3.12
centos7 安装升级 python3.12 centos7 默认的 gcc 和 g++ 版本都很低,在有 --enable-optimizations 选项时会编译报错,因此要在 scl 环境下编 ...
- find命令,查找文件
find 是 Linux 中强大的搜索命令,不仅可以按照文件名搜索文件,还可以按照权限.大小.时间.inode 号等来搜索文件. [root@localhost ~]#find 搜索路径 [选项] 搜 ...
- C#轻松实现Modbus通信
1.前言 大家好!我是付工.前面给大家介绍了一系列关于RS485与Modbus的知识. 终于有人把RS485说清楚了终于有人把Modbus说明白了通透!终于把ModbusRTU弄明白了这样看来,Mod ...